

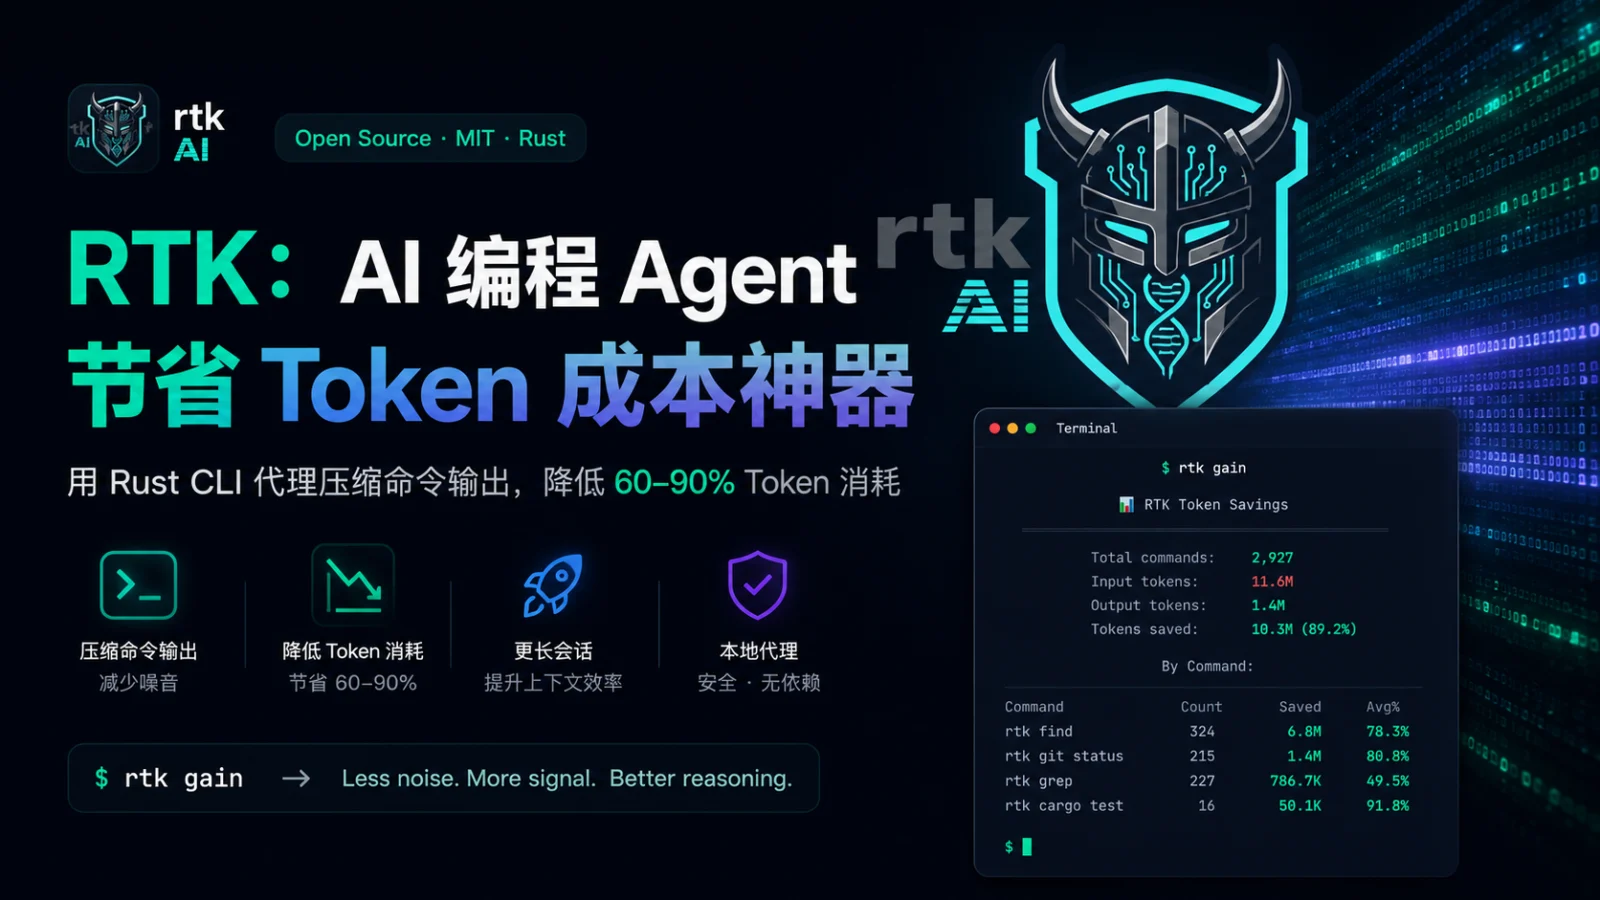
在 AI 编程 Agent 逐渐成为日常开发工具之后,一个越来越现实的问题是:大量终端命令输出会被送进模型上下文,导致输入 Token 快速膨胀。RTK(Rust Token Killer)正是面向这个痛点的开源项目。它不是新的大模型,也不是 IDE 插件,而是一个位于 AI Agent 与命令行工具之间的高性能 CLI 代理,用于在命令输出进入 LLM 上下文之前进行过滤、压缩和结构化。
项目简介
RTK 的官方定位是一个高性能 CLI proxy,目标是在常见开发命令中减少 LLM Token 消耗。项目 README 中强调,它可以在命令输出抵达模型上下文之前进行过滤与压缩,采用单一 Rust 二进制文件形态,支持 100 多个命令,并声称额外延迟低于 10ms。官方文档给出的典型收益区间是节省约 60%–90% Token,实际效果会随项目规模和命令输出类型而变化。
项目地址:https://github.com/rtk-ai/rtk
它解决的核心问题
AI 编程 Agent 在执行开发任务时,经常会调用 git status、git diff、tree、rg、cargo test、pytest、docker logs 等命令。这些命令对人类开发者来说很有用,但原始输出往往包含大量重复行、无关路径、冗余日志、样板文本和进度信息。
如果这些原始输出被直接写入模型上下文,就会产生几个问题:
- 输入 Token 变多:长日志、目录树和测试输出会快速占满上下文窗口。
- 模型注意力被稀释:关键错误和真正需要修改的文件被大量噪声淹没。
- 成本难以控制:一次任务可能包含多轮命令调用,累积成本比单次请求更重要。
- 重试成本上升:模型读到噪声后更容易误判,进而引发更多工具调用和修正轮次。
RTK 的思路很直接:不改变开发者原有命令语义,而是在 Agent 看到输出之前,把输出变成更适合 LLM 消化的紧凑格式。
工作方式:把原始命令输出变成 LLM 友好输出
RTK 的典型工作链路可以理解为:
AI Agent → Shell Command → RTK → 原始命令 → RTK 过滤/压缩 → 返回紧凑输出给 Agent官方 README 给出的示意是:没有 RTK 时,Agent 调用 git status 会直接拿到 shell 返回的原始输出;使用 RTK 后,命令会被改写为 RTK 代理形式,RTK 再调用实际的 git 命令,并将结果过滤成更短、更聚焦的文本。
RTK 主要使用四类策略:
- Smart Filtering:去除注释、空白、样板文本和其他低价值噪声。
- Grouping:把相似项目聚合,比如按目录聚合文件、按错误类型聚合失败信息。
- Truncation:保留关键上下文,裁掉重复或低价值内容。
- Deduplication:折叠重复日志行,并用计数表达重复次数。
支持的场景与命令类型
RTK 的覆盖面比较广,适合经常使用终端型 AI 编程工具的开发者。根据项目 README,RTK 支持文件、Git、GitHub CLI、测试框架、构建工具、Lint 工具、包管理器、AWS、Docker、Kubernetes、JSON、日志等多类命令。
| 类别 | 示例 | 优化价值 |
|---|---|---|
| 文件与搜索 | ls、tree、read、grep、rg | 压缩目录树和搜索结果,减少无关路径噪声 |
| Git | git status、git diff、git log | 把冗长状态、diff 和提交历史变成更紧凑摘要 |
| 测试 | cargo test、pytest、go test、jest | 优先保留失败信息、断言位置和关键错误 |
| 构建与 Lint | tsc、ruff、eslint、cargo clippy | 按文件、规则或错误类型聚合输出 |
| 容器与云服务 | docker logs、kubectl logs、aws logs | 对日志和资源列表做截断、去重与摘要 |
对 Claude Code、Codex、Cursor 等 Agent 的意义
RTK 的价值不在于替代 Claude Code、Codex、Cursor、Gemini CLI、OpenCode 这类编程 Agent,而在于给它们加上一层轻量的“命令输出治理”。对于 Agent 来说,工具输出是上下文的重要组成部分;如果工具输出更短、更稳定、更结构化,模型就更容易判断下一步应该读哪个文件、修哪个错误、是否需要继续运行测试。
RTK 官方 README 中列出了多种 Agent 集成方式,包括 Claude Code、GitHub Copilot、Cursor、Gemini CLI、Codex、Windsurf、Cline / Roo Code、OpenCode、Kilo Code、Google Antigravity 等。不同 Agent 的接入方式并不完全相同:有些可以通过 hook 在命令执行前自动改写,有些则通过规则文件、插件或显式命令调用完成。
需要注意的是,RTK 并不会让所有上下文问题自动消失。它主要优化的是命令行输出,而不是模型内部推理、IDE 内置读取工具或所有文件选择策略。比如 Claude Code 的内置 Read、Grep、Glob 等工具不一定会经过 Bash hook,因此某些场景仍需要显式使用 shell 命令或直接调用 RTK 命令。
安装与快速体验
RTK 提供多种安装方式。官方推荐 Homebrew:
brew install rtkLinux / macOS 也可以使用快速安装脚本:
curl -fsSL https://raw.githubusercontent.com/rtk-ai/rtk/refs/heads/master/install.sh | sh也可以通过 GitHub 仓库使用 Cargo 安装:
cargo install --git https://github.com/rtk-ai/rtk安装完成后,可以用以下命令检查版本和统计:
rtk --version
rtk gain
针对不同 Agent,可以使用类似命令初始化:
rtk init -g                     # Claude Code / Copilot
rtk init -g --gemini            # Gemini CLI
rtk init -g --codex             # Codex
rtk init -g --agent cursor      # Cursor
rtk init -g --opencode          # OpenCode
适合哪些用户
RTK 尤其适合以下几类用户:
- 经常使用 Claude Code、Codex、Cursor、OpenCode、Gemini CLI 等 AI 编程工具的开发者。
- 项目中存在大量测试输出、构建日志、lint 错误或容器日志的团队。
- 希望降低 AI 编程任务输入 Token 成本,并提升上下文质量的工程团队。
- 希望在不重写现有开发流程的前提下,给 Agent 增加一层终端输出压缩能力的用户。
局限与使用建议
RTK 的定位非常清晰,但使用时也需要理解它的边界:
- 它不是模型上下文缓存:RTK 优化命令输出,不等同于 provider 的 prompt cache 或 context cache。
- 它不替代文件选择:Agent 仍然需要判断该读哪些文件、哪些 diff、哪些测试日志。
- 它不一定覆盖所有工具调用:是否自动改写取决于 Agent 的 hook、插件或规则机制。
- 压缩有信息损失风险:极端排障场景可能仍需查看完整输出,因此 RTK 的 tee / raw output 机制很重要。
一个更合理的实践方式是:把 RTK 视为 AI 编程 Agent 成本治理链条中的一环,与 Repo Map、上下文路由、规则文件治理、Prompt Cache、工具输出截断和任务级成本统计配合使用。
项目点评
RTK 的亮点在于它抓住了 AI 编程工作流里一个很具体但高频的问题:命令行输出并不是天然适合 LLM 阅读。相比从模型层面讨论 Token 成本,RTK 更偏工程化、工具化和可落地。它不要求用户更换模型,也不强行改变 IDE,而是通过 Rust 单二进制和 hook / 插件方式接入现有流程。
对于中文开发者来说,RTK 值得关注的原因主要有三点:第一,它把 Token 优化落实到开发命令这个高频入口;第二,它覆盖了 Git、测试、Lint、Docker、Kubernetes、云服务等真实工程场景;第三,它提供了 rtk gain、rtk discover 等统计能力,让节省效果可以被观察,而不只是主观感受。
如果你正在使用 Claude Code、Codex、Cursor 或 OpenCode 做真实项目开发,并且经常发现 Agent 把大量日志、目录树和测试输出塞进上下文,RTK 是一个值得尝试的项目。
评论