

导读:OpenAI 在 2026 年 9 月 29 日发布 GPT-6.1 Sol,距离 GPT-6 Sol 上线仅约一周。因为版本号只多了一个“.1”,很多人第一反应是“常规小更新”,但从官方基准、API 规格以及 Reddit、Hacker News、GitHub Copilot 用户的实际反馈来看,这次升级对编程和 Agent 工作流的影响明显大于版本号给人的感觉。
本文截至 2026 年 10 月 2 日,结合 OpenAI 官方资料、GitHub 公告以及近期社区真实使用反馈,回答一个最实际的问题:GPT-6.1 Sol 与 GPT-6 Sol 到底差多少,值不值得直接切换?
先给结论:不是“翻倍变强”,但对复杂编程任务属于明显升级
如果只看单项 benchmark,GPT-6.1 Sol 并没有出现“能力翻倍”这种夸张变化;但如果看真实开发工作流,它更像是一次可靠性、复杂任务完成度和 Token 利用效率的集中修正。
尤其值得注意的是,GPT-6 Sol 发布后,社区里出现了大量“比 5.6 Sol 更容易漏指令”“复杂重构不够稳”“像是 Terra 级模型换了 Sol 名字”的负面反馈。GPT-6.1 Sol 上线后,这类声音明显减少,取而代之的是“终于像真正的 Sol”“复杂任务可用了”“配额消耗更舒服”等评价。
不过它也不是没有代价:高推理档下速度偏慢,是目前社区最常见的负面反馈之一。
一张表看懂 GPT-6.1 Sol 与 GPT-6 Sol 的核心区别
| 项目 | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| 定位 | 接近 Astra 的复杂工作能力,强调编程、电脑操作与专业工作 | 复杂编程与 Agent 工作流 |
| 输入价格 | $2 / 100 万 Token | $2 / 100 万 Token |
| 输出价格 | $10 / 100 万 Token | $10 / 100 万 Token |
| 缓存输入 | $0.10 / 100 万 Token | $0.20 / 100 万 Token |
| 上下文窗口 | 105 万 Token | 105 万 Token |
| 最大输出 | 12.8 万 Token | 12.8 万 Token |
| 知识截止 | 2026-04-30 | 2026-04-20 |
| 推理强度 | low / medium / high / xhigh / max | none / low / medium / high / xhigh / max |
从规格上看,最直接的成本变化是缓存输入价格再次减半。对于 Codex、长上下文代码库、持续 Agent 会话这类会反复读取相同上下文的场景,这个变化比普通聊天更有意义。
官方 benchmark:6.1 Sol 的提升不是纸面微调
OpenAI 在开发者社区公开的数据里,GPT-6.1 Sol 在 DeepSWE v1.1 上以 High 推理强度达到 75.2%,而 GPT-6 Sol 在 Max 推理强度的最高成绩为 68.8%。换句话说,新版在更低的推理档位下,已经超过旧版的最高档成绩。

在 AutomationBench 上,GPT-6.1 Sol 的 Medium 档成绩为 31.7%,比 GPT-6 Sol 同档高约 4.8 个百分点。OpenAI 还给出 OSWorld 2.0 离线测试数据:GPT-6.1 Sol Max 为 71.4%,已经非常接近 GPT-6 Astra 的 73.5%。
这些数字不能简单理解成“现实工作一定提升 10% 或 20%”。Agent 编程有明显的阈值效应:模型只要少漏一个关键约束、少做一次错误重构、能多坚持几轮验证,最终结果就可能从“任务失败”直接变成“可交付”。所以 benchmark 上几个百分点的差距,在真实代码库里有时会显得比数字本身更大。
为什么 GPT-6 Sol 的口碑这么差?
在 GPT-6 Sol 上线后的几天里,Reddit 的 Codex、OpenAI 等社区出现了多条高互动讨论,抱怨点非常集中:
- 复杂任务更容易遗漏明确指令;
- 代码审核&查验和重构时容易做出不必要的修改;
- 部分用户认为它明显不如 GPT-5.6 Sol 稳定;
- 虽然 API 价格更低,但订阅用户更在意“每次任务到底能不能一次做对”;
- 有人甚至直接退回 GPT-5.6 Sol 使用。
例如,一位用户表示自己让 GPT-6 Sol 审核&查验多个项目后,模型在修复问题的同时引入了新的回归;另一些用户则反馈,在相同或近似任务里,GPT-6 Sol 会花更长时间,却没有完成原本 5.6 Sol 能顺利完成的工作。
这些都属于社区用户的主观案例,不能代表所有人,但当相似问题在多个独立讨论中反复出现时,至少可以说明:GPT-6 Sol 的实际体验存在明显的稳定性争议。
GPT-6.1 Sol 的真实用户反馈:明显变好,但“慢”很突出
1. 正面反馈:复杂任务更像 Sol 该有的水平
GPT-6.1 Sol 发布后,Reddit 上很快出现“比 6 Sol 好很多”“终于值得叫 Sol”之类的反馈。有开发者在 GitHub Copilot 场景中测试高级 C++ 任务,认为其质量已经接近更高端模型;也有用户表示,之前最担心的正是 GPT-6 Sol 的不稳定,而 6.1 在实际项目中暂时没有出现同样严重的问题。
Hacker News 的讨论里,也有开发者认为 6.1 Sol 在一般编程任务中已经非常接近 Astra,尤其是 Token 效率更好,只有在视觉、空间推理等少数场景中旗舰模型的优势更明显。
2. 配额与 Token 体感:这是很多 Plus / Codex 用户最满意的地方
社区里有不少用户反馈,GPT-6.1 Sol 长时间运行时的“配额掉速”比预期更低。有用户描述,模型连续工作几十分钟、修改上千行代码后,周配额变化仍然很小;也有用户把它用于数小时的重型项目,认为相比 Astra 更适合长期常驻。
这里需要注意:ChatGPT / Codex 的订阅配额并不是简单按照 API Token 单价一比一换算,而且平台策略会变化,因此这些只能视为当前用户体感,不能当成固定额度承诺。
3. 最常见的负面反馈:速度慢
6.1 Sol 的主要争议不是“太笨”,而是“太慢”。多个 Reddit 与 Hacker News 用户都提到,在 High、xHigh 等较高推理档位下,它完成复杂任务的等待时间明显增加。
这其实和它的使用定位有关:如果你追求的是“同样订阅额度里尽可能多做有价值的工作”,很多人愿意接受慢一点;但如果你做的是高频、小改动、需要快速来回交互的任务,延迟就会非常明显。
4. 仍然不是人人满意
也有用户在 6.1 Sol 上遇到明显失败案例。例如有开发者让模型根据完整 Prompt 构建一个小游戏,结果遗漏音乐、玩法等要求,多轮修改后依然没有达到可用状态,并认为其他模型在类似任务上表现更好。
所以 6.1 Sol 不是“从此不会翻车”,更准确的说法是:它把 GPT-6 Sol 最受诟病的可靠性问题往回拉了一大截,但复杂 Agent 任务依然需要测试、审核&查验和 Harness 配合。
中文开发者社区怎么评价?linux.do、V2EX 的反馈比英文社区更“接地气”
补充查看 linux.do、V2EX 等中文开发者社区后,可以看到一个很有意思的现象:中文社区对 GPT-6.1 Sol 的讨论,比 Reddit / Hacker News 更集中在三个问题——是否“降智”、实际订阅额度消耗,以及“鹈鹕骑自行车”这类可视化编程测试。
linux.do:同一个测试里,6.1 Sol 与 6 Sol 的反差非常大
一篇持续更新的 linux.do 对比帖尤其有代表性。作者使用同一账号测试 GPT-6 Sol、GPT-6 Luna、GPT-5.6 Sol、GPT-6 Astra,随后在 9 月 30 日追加 GPT-6.1 Sol。按照作者自己的测试记录,GPT-6 Sol 在“糖果”等固定题上曾出现明显失误,而 GPT-6.1 Sol 从 low 到 max 全部通过;作者还记录到单次测试的 Plus 5 小时额度消耗约为 1%~3%。
另一位 linux.do 用户用约 1000 行着色器教学网页做静态分析:此前 GPT-6 Sol 没找到的数组越界问题,6.1 Sol 在 low 档就找了出来;但同一帖的评论区也有人反馈 6.1 仍会“降智”、速度很慢或额度体感并不理想。也就是说,中文社区的共识不是“6.1 永不降智”,而是它的能力上限和正常状态明显比 6 Sol 更令人满意,但账号、路由和服务端状态造成的波动仍然存在。
V2EX:评价更克制,重点是“终于像 Sol”与性价比
V2EX 上的讨论也比较典型。一位用户连续使用 6.1 Sol 约两小时后,称周额度只下降约 2%~3%,并认为 5x 档已经“能用”;另一条讨论中则有人直接反驳“接近 Astra、五分之一成本”的宣传口径,认为 6.1 更像是“Sol 本来就应该有的样子”。
这类反馈比单纯比较 benchmark 更有参考价值,因为它反映了开发者真正关心的三件事:一次能不能把活干对、长时间使用会不会快速吃完额度、以及模型在真实 Codex / Agent 环境里是否稳定。
最近很火的“鹈鹕骑自行车”到底测了什么?
“鹈鹕骑自行车”并不是 2026 年才出现的新梗。Simon Willison 在 2024 年就提出了一个非常简单的 LLM 小测试:
Generate an SVG of a pelican riding a bicycle
它要求语言模型直接写 SVG 代码,而不是调用图片生成模型。难点在于模型必须同时理解鹈鹕、自行车,以及“坐在车上、脚踩踏板、身体与车架关系合理”这类空间结构。它非常直观,但本质上仍然是非科学、单样本、容易受随机性影响的民间测试。
中文社区流行的其实是“加强版”:HTML + SVG + 2D 动画
这次 GPT-6.1 Sol 发布后,linux.do 和 V2EX 大量传播的版本通常不是原始静态 SVG,而是类似“创建一个 HTML,内容是 SVG 绘制的鹈鹕骑自行车 2D 动画”的任务。它会额外考察 HTML 结构、SVG 绘制、动画、空间关系和一次性代码完成度。
linux.do 上多位用户分别测试了 6.1 Sol 的 High、xHigh、Max 等档位。常见反馈是:整体画面、动作连贯性和空间结构明显好于 6 Sol,不少结果已经很接近 Astra;但也存在踏板不动、坐姿奇怪、细节错误等问题。同一个模型、同一个档位,不同账号甚至会生成差异很大的结果。
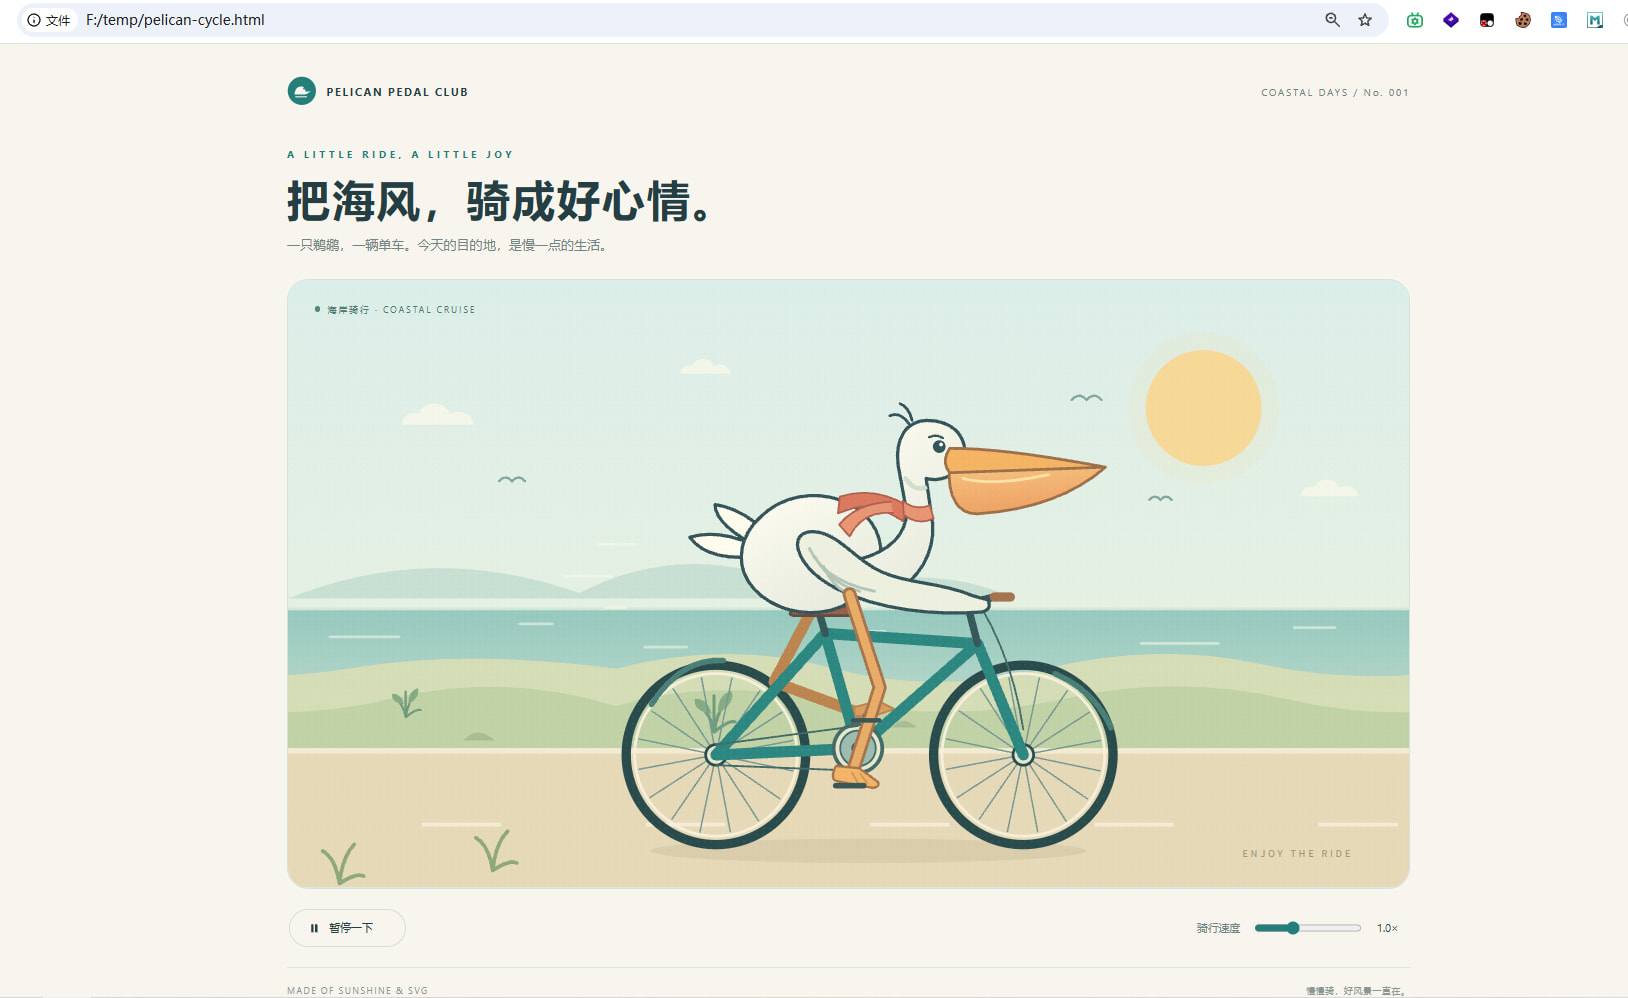
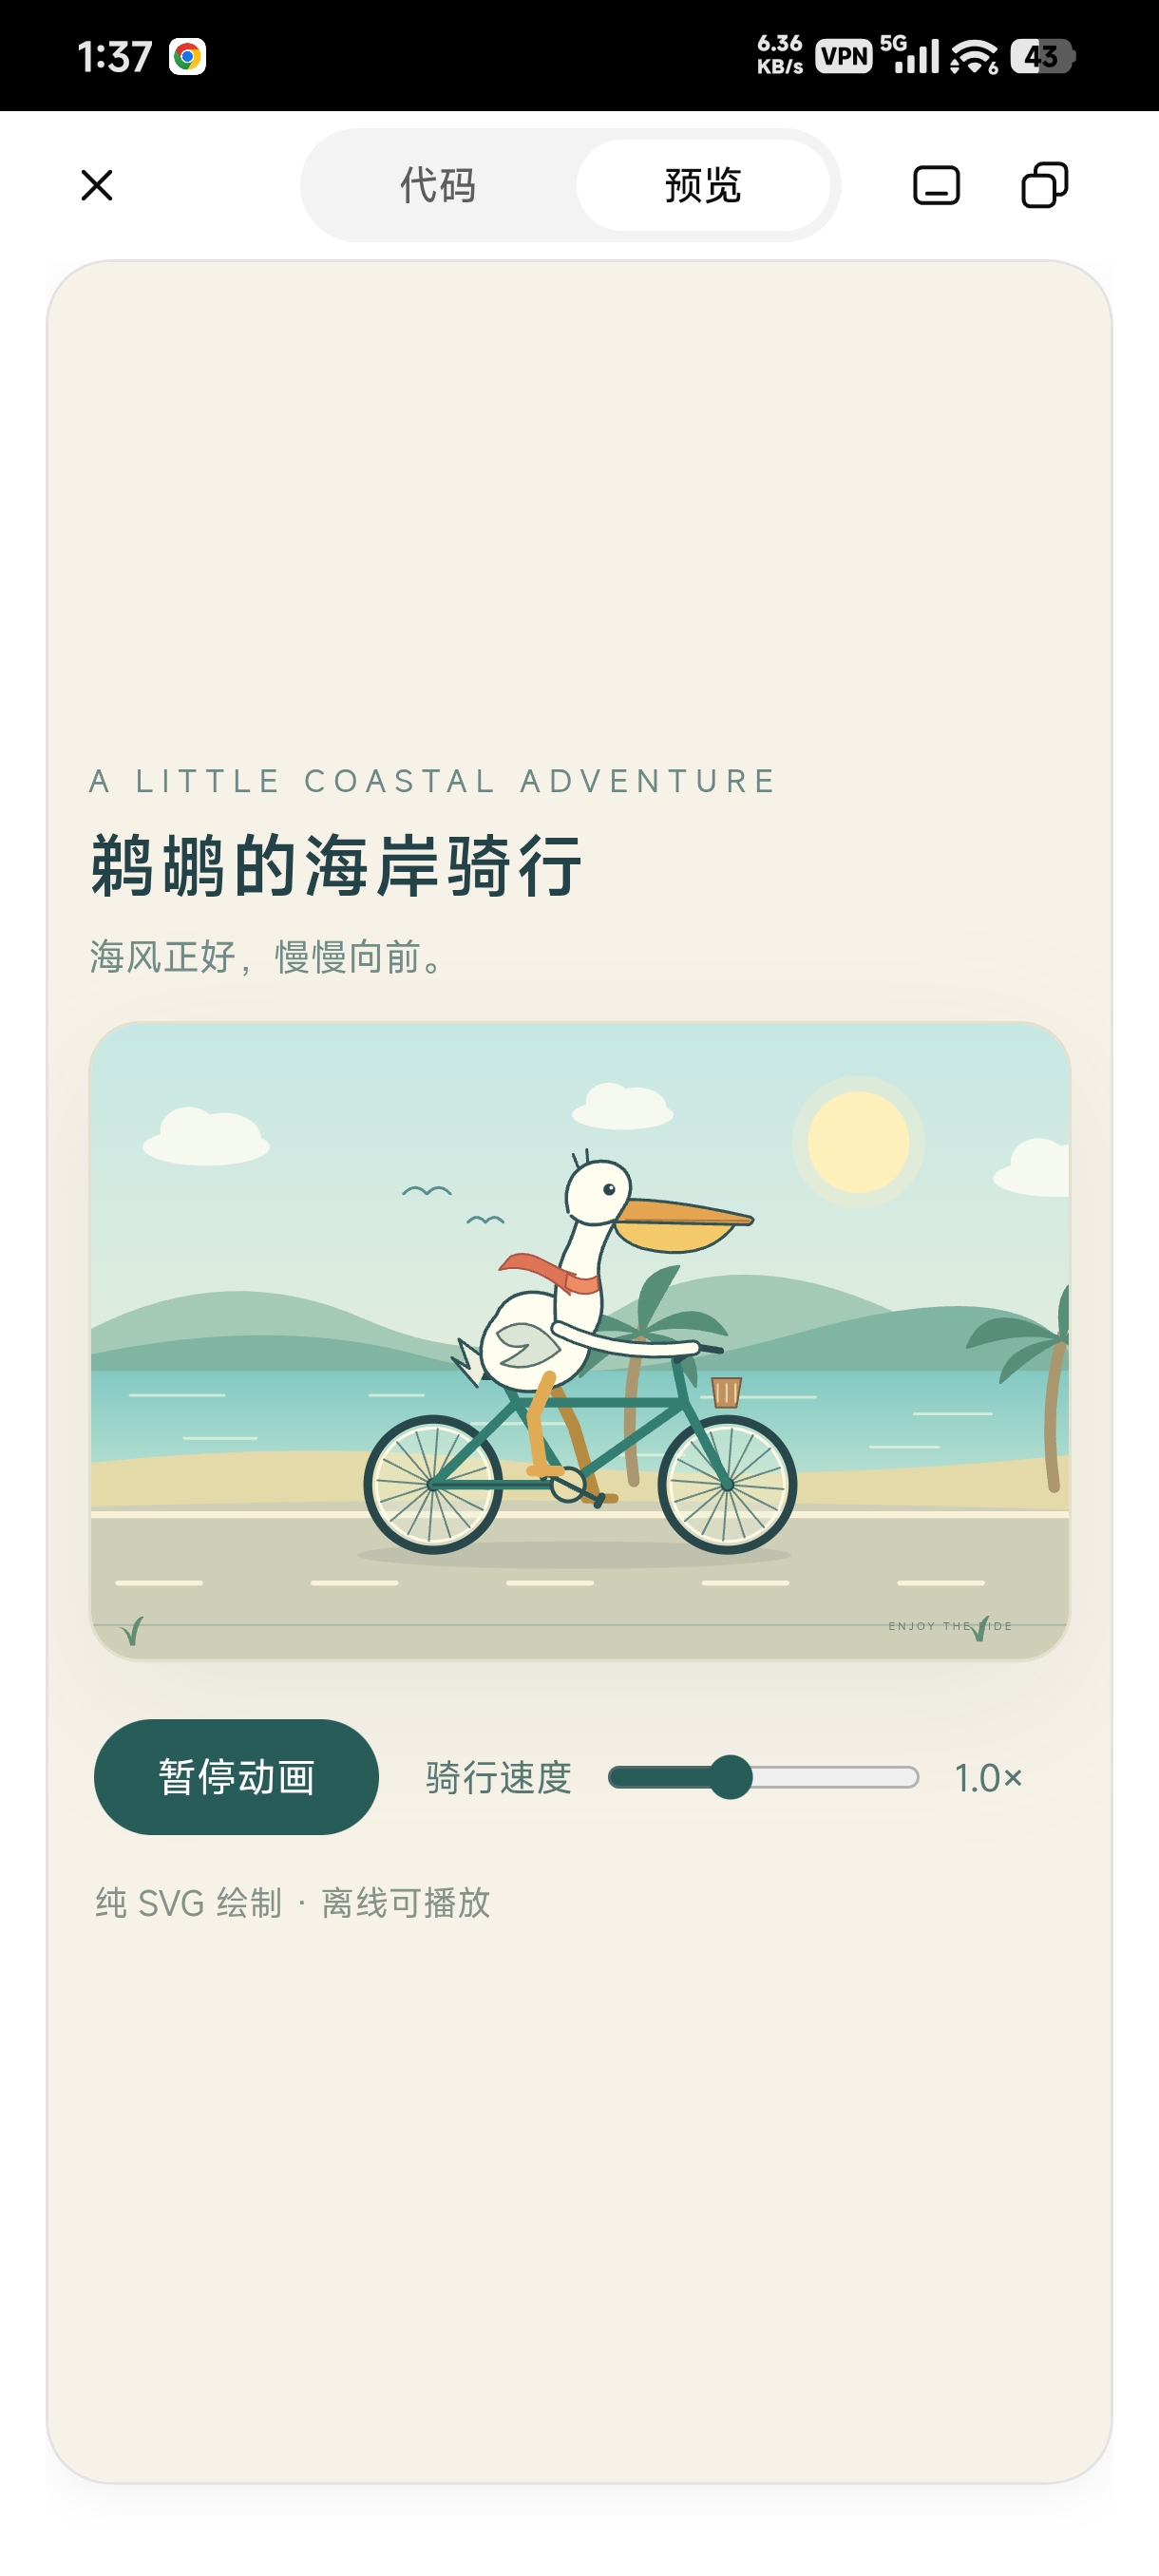
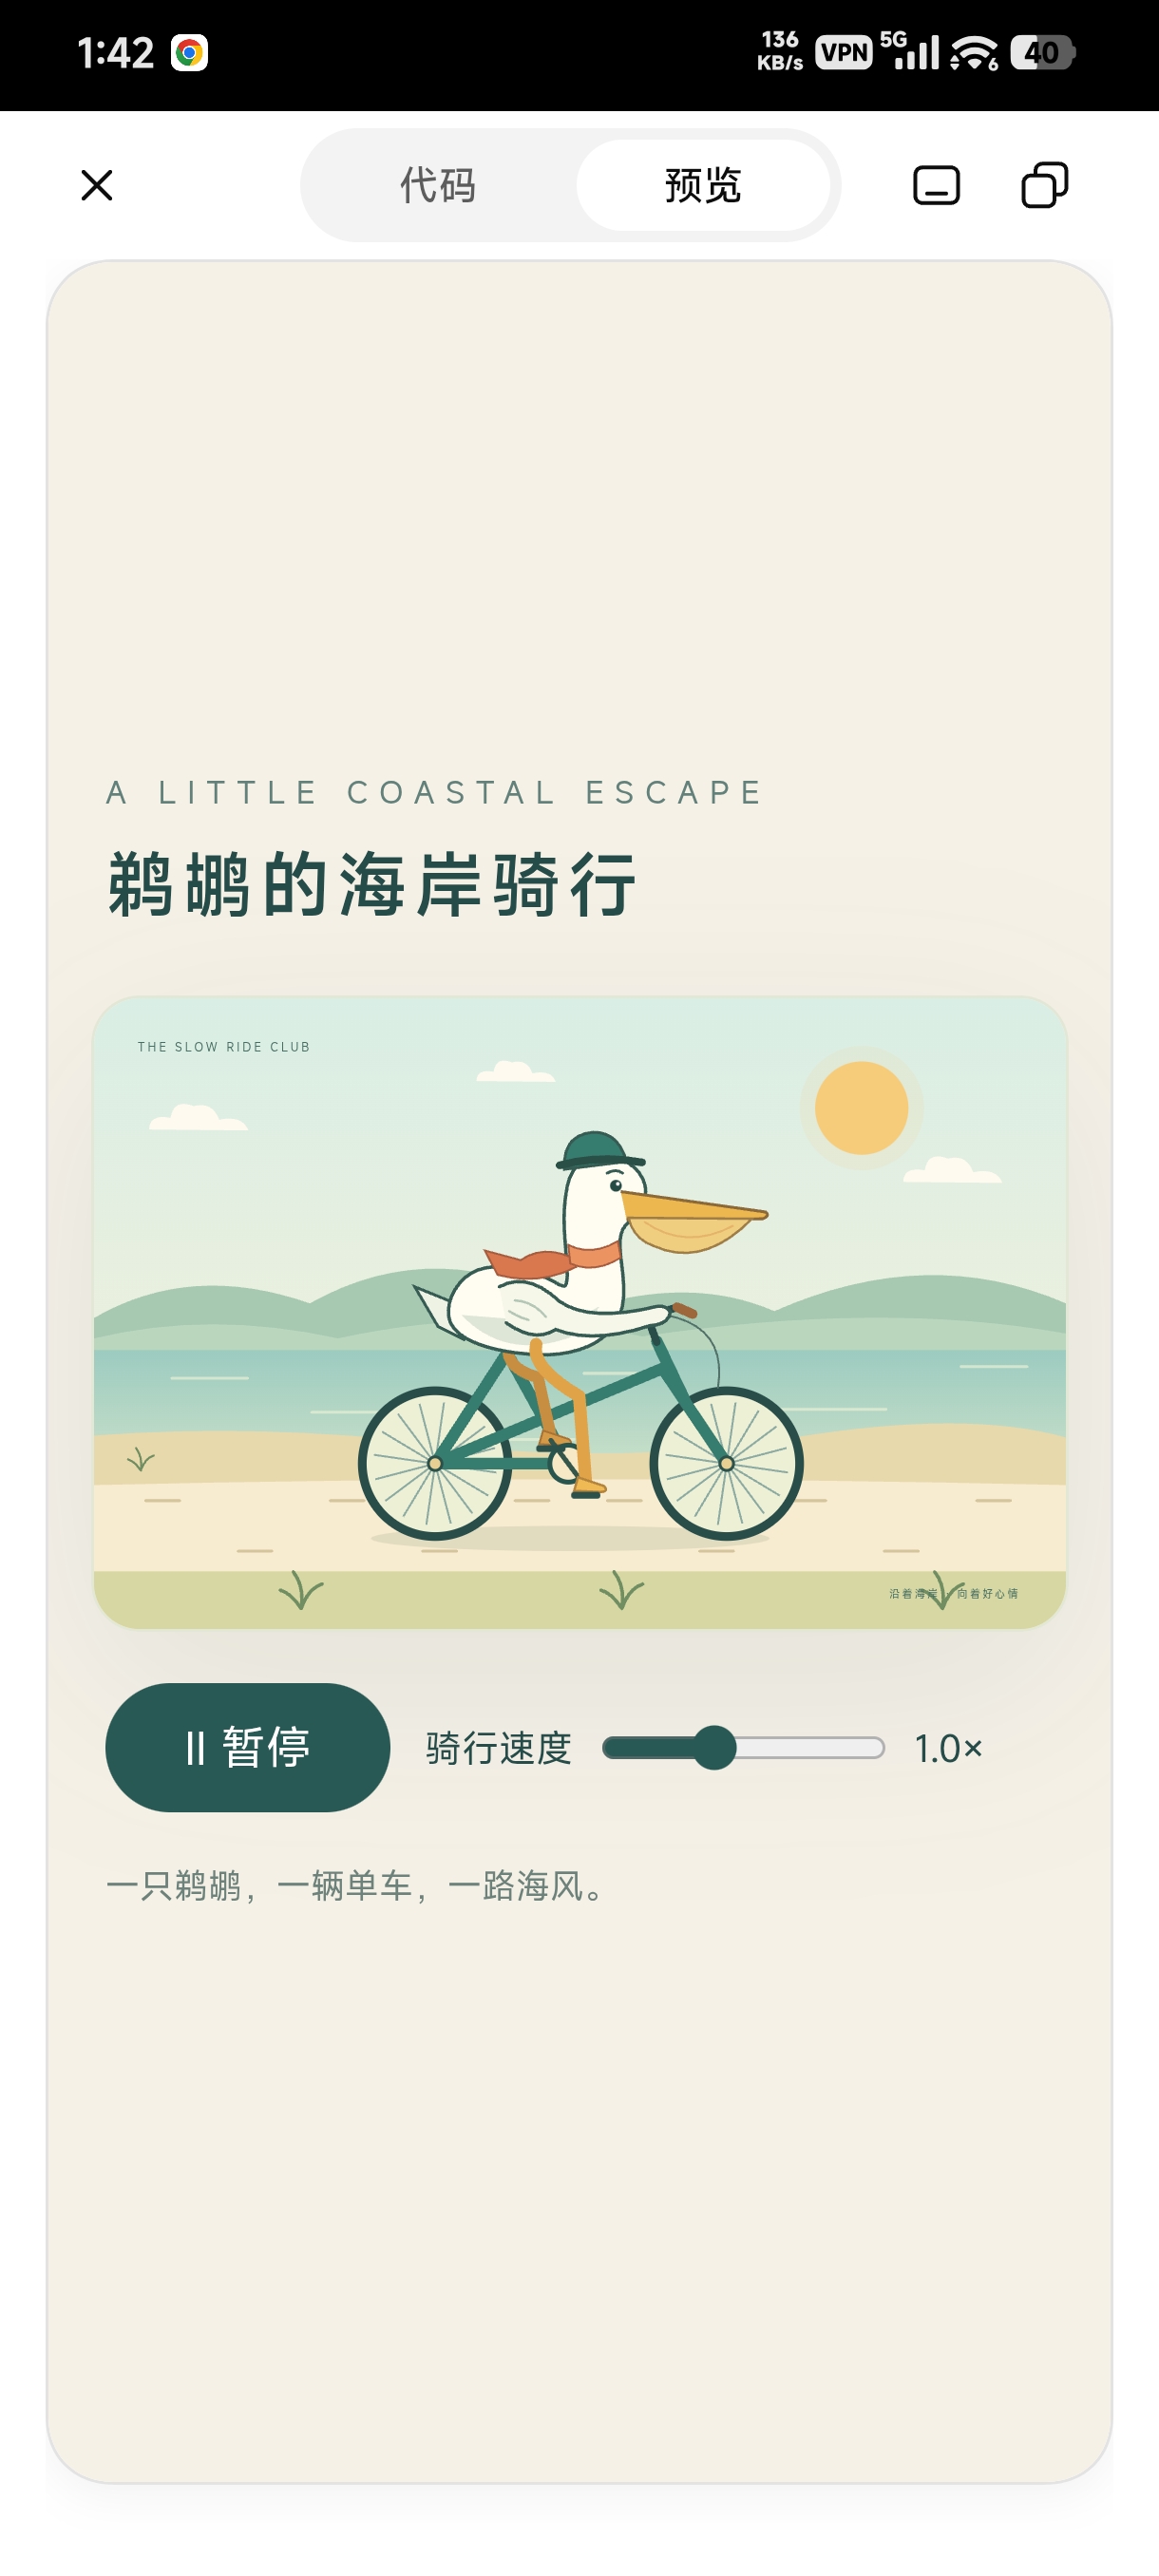
上面两张为同一位 LINUX DO 用户给出的网页端 Medium 档实测截图,适合直接观察 6.1 Sol 与 Astra 的空间关系与构图差异。
V2EX 用户甚至专门做了 Pelican Benchmark,收集 Classic SVG 与 Animated HTML 两种轨道的源文件,并记录模型、思考档位和实际提示词。这个做法比只发截图更有价值,因为至少可以回看原始代码和测试条件。

但有一个很重要的反例:Simon Willison 自己并没有认为 6.1 的原版鹈鹕明显更强
如果只看中文社区里那些很漂亮的 6.1 Sol 动画,很容易产生“6.1 已经把 6 Sol 完全甩开”的印象。但 Simon Willison 在 9 月 29 日亲自跑了 GPT-6.1 Sol 的原始静态 SVG 鹈鹕测试后,给出的判断是:结果与 GPT-6 家族此前的鹈鹕相比“没有明显不同”。
这并不与中文社区冲突,因为两边实际上经常不是同一个测试:一个是最原始的一句话静态 SVG,另一个是更复杂的 HTML / SVG 动画任务。后者更接近“前端代码生成 + 空间推理 + 动画实现”的综合测试,因此更容易放大不同模型在规划和代码执行上的差异。
怎么看“鹈鹕测试”才比较合理?
- 它适合快速观察模型有没有基本的 SVG / HTML 构图能力;
- 动画版还能粗略观察空间关系、动作链和前端代码组织能力;
- 但一次漂亮输出不能代表模型整体能力,也不能证明“没有降智”;
- 必须尽量固定 Prompt、思考档位、客户端、是否允许工具/子 Agent,并重复多次;
- 最好同时搭配真实代码库任务和可自动判定结果的 benchmark。
事实上,一个独立的 GPT-6.1 Sol benchmark 项目在 3527 次调用中也给出了更克制的结果:6.1 Sol 在推理、编码和视觉等项目里通常略领先 6 Sol,但很多准确率差距只有 1~2 个样本;与此同时,它的可见输出速度中位数约为 31.1 tok/s,低于 6 Sol 的 46.0 tok/s,推理总耗时也更长。这与社区“更聪明,但更慢”的整体体感基本一致。
那么,两者到底“差多大”?
如果一定要把差异说得直白一些:
- 简单问答、短代码:差距未必大到一眼可见,6 Sol 甚至可能因为少推理而显得更快。
- 复杂代码库、长任务、重构、排错:6.1 Sol 的提升更明显,可靠性和任务完成度比 6 Sol 更值得信任。
- 长上下文 Agent:6.1 Sol 更占优势,尤其是缓存输入价格减半后,长期运行的成本结构更好。
- 高推理强度:6.1 Sol 能力更强,但速度可能明显更慢。
- API 用户:标准输入/输出价格不变,直接换 6.1 Sol 通常更划算。
- Codex / Plus 用户:社区反馈普遍认为 6.1 的“可用工作量”更舒服,但订阅配额策略仍应以产品实时显示为准。
因此,GPT-6.1 Sol 与 GPT-6 Sol 的关系,更像是同一价格档位下的一次明显纠偏和能力补齐,而不是普通补丁。如果你的主要用途是 AI 编程、代码审核&查验、自动化操作和长时 Agent,6.1 Sol 的实际提升通常会比版本号“6 → 6.1”看起来更大。
我更建议怎么选?
对于大多数开发者,尤其是 Codex、GitHub Copilot、CLI Agent 或自建 Agent 工作流用户,GPT-6.1 Sol 更适合作为新的默认 Sol 模型。
只有一种情况 GPT-6 Sol 仍可能有吸引力:你的任务很简单、对响应速度特别敏感,而且你已经验证 6 Sol 在自己的固定工作流里足够稳定。否则,在相同的标准 API 输入/输出价格下,没有太多理由为了旧版而牺牲 6.1 的复杂任务表现。
不过也别把所有差异都归因于模型。2026 年的 AI 编程体验越来越受 Harness、上下文压缩、工具权限、Prompt 结构、测试环境和 Agent Loop 影响。同一个模型放在不同客户端里,最终表现可能差得非常大。
参考资料
- OpenAI:GPT-6.1 Sol 模型说明
- OpenAI:GPT-6 Sol 模型说明
- OpenAI Developer Community:GPT-6.1 Sol API 与 benchmark 数据
- GitHub Changelog:GPT-6.1 Sol in GitHub Copilot
- Reddit:GPT-6.1 Sol Plus 用户反馈
- Reddit:GPT-6.1 Sol 使用效率讨论
- Reddit:GPT-6.1 Sol 负面实测案例
- Reddit:GPT-6 Sol 真实使用争议
- Hacker News:GPT-6.1 Sol 社区讨论
- LINUX DO:GPT-6 Sol / 6.1 Sol 多轮固定题与额度对比
- LINUX DO:GPT-6.1 Sol 静态分析与编程实测
- LINUX DO:GPT-6.1 Sol High 鹈鹕动画测试
- V2EX:GPT-6.1 Sol 实际使用与额度反馈
- V2EX:Pelican Benchmark 社区项目
- Simon Willison:原始 Pelican Bicycle SVG 测试
- Simon Willison:GPT-6.1 Sol 鹈鹕测试观察
- 独立测试:GPT-6.1 Sol / GPT-6 Sol / Astra / Luna 多轨 benchmark
说明:社区反馈属于用户个人体验,受任务类型、推理档位、客户端、Harness、上下文长度和配额策略影响,本文将其用于观察实际使用趋势,不等同于统一 benchmark 结论。
评论