

将 LLM 智能体部署到生产环境,关键不在于用更强大的模型,而在于把模型限制在单一节点,让系统其余部分都是普通、可测试的代码。以下是实现这一目标的核心设计思路与契约类型。
生产环境为何排斥"自主探索"式智能体
演示场景偏爱能循环调用工具、"自己搞定"的自主智能体。但生产环境对此深恶痛绝。一旦智能体的行为取决于模型当天走了哪条路径,系统就变得无法测试、无法审计、无法让它接触任何关键业务。在金融、医疗、基础设施等受监督&管理或高后果领域,"大概能用"根本站不住脚。
这是 LLM 系统生产就绪的六层成熟度模型的第一级:确定性层。在构建评估体系、置信度路由等上层能力之前,必须先让底层保持稳定。这一层的核心思想只有一句:把模型约束在单一节点,使周围一切都是普通、可测试的代码。本文给出的是具体契约实现,而非空泛概念。
原则一:智能体只提提案,不直接执行
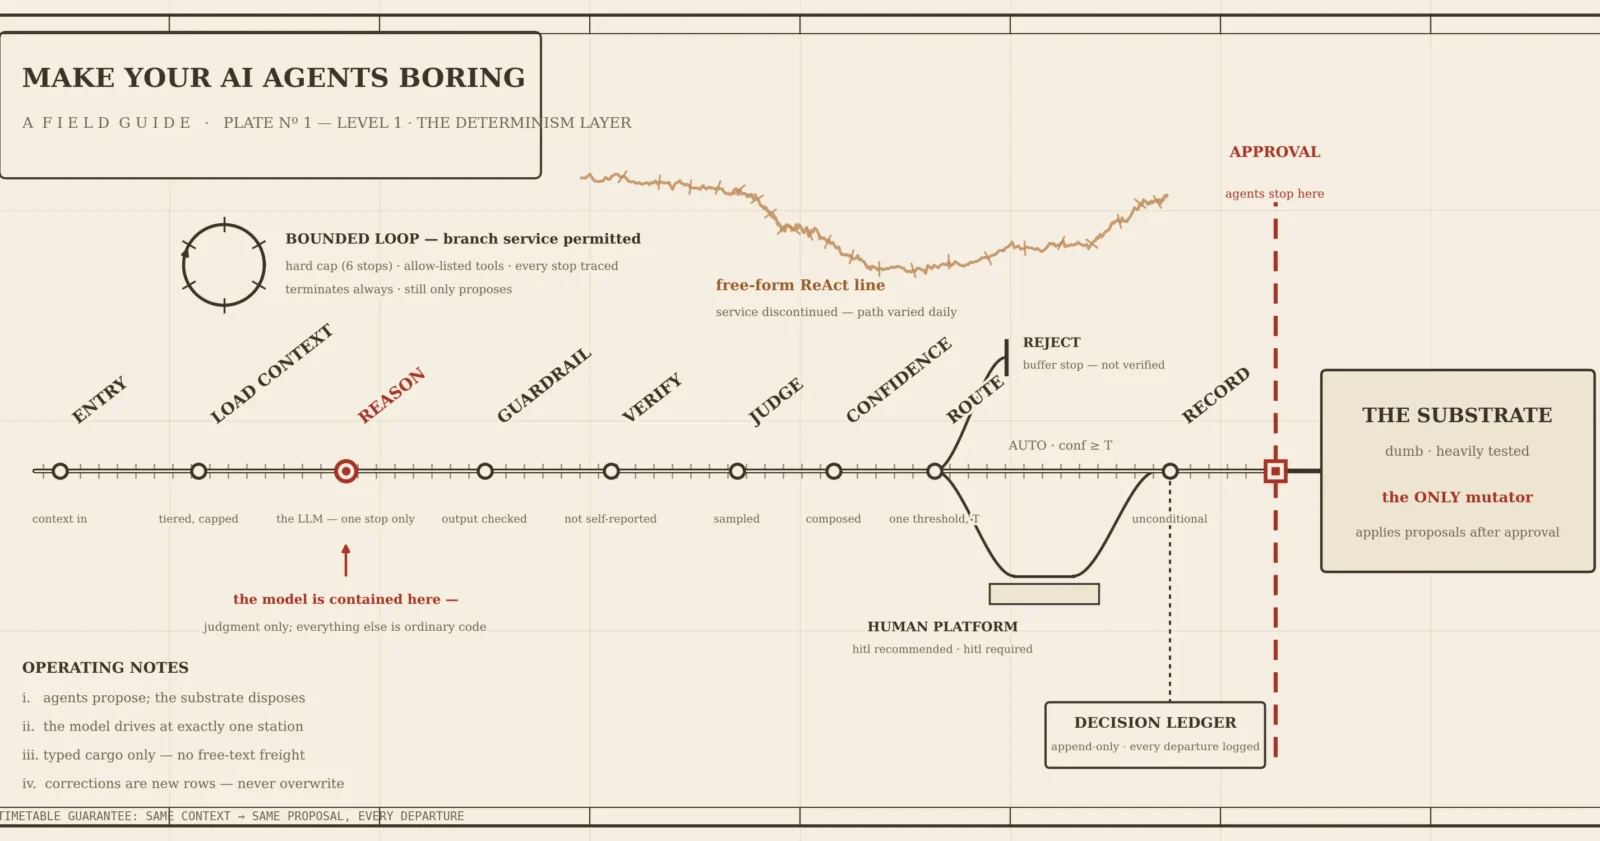
最重要的一条规则:智能体是从上下文到"提案决策"的纯函数——相对于业务状态是纯函数,给定网关(唯一的非确定性调用点,即模型本身)时是确定性的。智能体本身没有改变世界的权限。提案的执行由另一个独立、简单、大量测试过的组件(称为 Substrate)完成,且必须经过审批后才能生效。
from typing import Protocol, Literal
from dataclasses import dataclass
@dataclass(frozen=True)
class Proposal:
 decision_id: str
 capability: str
 action: dict
 confidence: float
 routing: Literal["auto", "hitl_recommended", "hitl_required", "reject"]
 reasoning: list[str]
 evidence: list[dict]
class Agent(Protocol):
 def propose(self, ctx: "Context") -> Proposal: ...
class Substrate(Protocol):
 def apply(self, proposal: Proposal, approval: "Approval") -> "Effect": ...
由于 `propose` 是纯函数,其核心属性可以用一句话断言:
def test_propose_is_pure:
agent = ClassifyAgent(gateway=FakeGateway(scripted)) assert agent.propose(ctx) == agent.propose(ctx) 这一边界的设定带来三个关键属性:
- 可测试:
propose是纯函数——相同上下文必然产生相同提案,无需模拟外部环境即可测试逻辑。 - 安全:被越狱或存在缺陷的智能体只会产生糟糕的提案,而非糟糕的行动。影响范围止步于"护栏拦截或人工拒绝"。
- 可组合:智能体之间互不调用,工作通过 Substrate 流转(如案例表 + 调度器),不存在隐含的副作用链需要追踪。
这一约束将"AI 做了件无法解释的事"转化为"AI 提出了一个建议,这里是审批它的完整记录"。
原则二:每个能力对应一张固定图
自由形式的 ReAct 循环适合探索,却无法提供确定性保证。正确做法是:将每项能力建模为固定顺序的节点图,模型只出现在需要判断力的环节,其余均为普通代码。下图是简化版示意,完整节点列表(含 pre_check 和 memory_write)见下一节。
entry → load context → reason (LLM) → output guardrail → verify → judge (sampled) → compose confidence → route → prepare proposal → record → exit
| 自由 ReAct 循环 | 固定图(本文方案) | |
|---|---|---|
| 控制流 | 模型决定下一步 | 预先已知 |
| 测试难度 | 路径不固定,测试困难 | 每个节点独立测试 |
| 延迟/成本 | 无上界 | 有界、可预测 |
| 审计 | 从轨迹重建 | 每次都是统一的行条目 |
你放弃了一点"灵活性",换来的是对系统行为进行推理的能力。而真正需要灵活判断的部分——对混乱输入的决策——仍然保留在模型最擅长的位置:一个节点,周围被可读代码环绕。
请求的完整解剖
"让智能体具有确定性"听起来很抽象,直到你看到它的具体形态。下面将一次请求完整走完上述固定图,逐节点解析其实现。
状态对象:每个节点读写一个贯穿整个图的类型化状态值。将这一点显式化是核心——它使你能通过构造状态并断言输出来独立测试每个节点。
from typing import TypedDict, Literal, Optional
class GraphState(TypedDict):
 decision_id: str
 tenant_id: str
 identity: dict
 inputs: dict
 context: dict
 model_output: Optional[dict]
 guardrail: dict
 verification: dict
 judge: Optional[dict]
 confidence: Optional[float]
 routing: Optional[Literal["auto", "hitl_recommended", "hitl_required", "reject"]]
 proposal: Optional[dict]
 ledger_entry_id: Optional[str]
**节点契约**:所有节点形态统一:`state -> state`。除模型节点外均为确定性。这一一致性是每个节点可独立单元测试、以及整体行为可推理的基础。
from typing import Protocol class Node(Protocol):
name: str def run(self, state: GraphState, deps: "Deps") -> GraphState: ... 节点图构成:8 个节点在所有能力间共享,只有少数节点与具体能力相关。新增一种能力,只需实现约 4 个节点,继承其余 8 个共享节点即可:
- entry:生成 decision_id,绑定租户与身份标识
- pre_check:验证输入、解析引用、低成本快速退出
- context_load:仅获取当前决策所需的上下文
- llm_decision:推理步骤——结构化输入、结构化输出
- output_guardrail:对模型输出进行脱敏与策略检查
- verification:确定性、与能力相关的正确性校验
- judge:采样式二次模型审核&查验(高风险场景)
- confidence_compose:从各信号组合评分
- routing:决定走自动、人工推荐还是人工必须审批
- prepare_proposal:塑造最终提案
- memory_write:写入智能体自身的审计记忆(非业务状态)
- exit:追加不可变账本条目
两个核心节点:决策与校验
整个系统的支柱只有两个节点:llm_decision 和 verification。
llm_decision 是唯一的非确定性节点——结构化输入、Schema 约束输出、不匹配时重试。它输出的内容在后续环节中一律视为不可信,直到通过校验。verification 则是确定性的、面向具体能力的代码,整个"把模型关在笼子里"的思路就建立在这层校验之上:
def run(self, state, deps):
 out = state["model_output"]
 checks = {
 "in_enum": out["decision"] in ALLOWED_DECISIONS,
 "schema_ok": matches_schema(out, DECISION_SCHEMA),
 "rules_ok": deps.rules.check(out, state["inputs"]),
 }
 state["verification"] = {
 "checks": checks,
 "score": sum(checks.values) / len(checks)
 }
 return state
固定形态的用意在于:控制流可读(路径即图结构)、模型被锁定在一个节点内、每次决策格式统一——意味着每次都有相同的审计行、在同一位置添加检查/指标/护栏。
结构化输出:避免自由文本的陷阱
Node 4 值得单独说明,因为大量 LLM 脆弱性来源于一个选择:让模型返回自由文本再解析。自然语言天然歧义,格式在每次调用间漂移,下游代码随时可能因一句话的措辞变化而崩溃。"好的!大概是 Approve,不过也可能是 Escalate"——现在你得自己解决一个 NLU 问题来提取 Approve,而明天模型换一种说法你的正则就挂了。系统被耦合到了模型最不稳定的东西——它的行文风格。 解法枯燥但有效:约束模型输出经过验证的结构,把其他一切视为失败调用并重试。约束方式有三种,按保障强度排列:
- Schema 引导(JSON Schema / response_format):请求匹配某 Schema 的 JSON,强约束,由提供商强制执行,适合大多数场景
- 工具/函数调用:模型发出带类型的工具调用,强约束,天然适合"用参数做 X"类任务,决策映射到具体动作
- Grammar 约束解码:将 token 约束到某语法,硬保障,无法发出无效格式,适合严格/受监督&管理格式或本地模型
from pydantic import BaseModel
from typing import Literal
class Decision(BaseModel):

decision: Literal["approve", "escalate", "reject"]
 confidence: float
 reasons: list[str]
约束生成能减少格式错误的输出,但无法彻底消除。因此要闭合反馈环:验证每个响应,不匹配则重试——把验证错误反馈给模型。设置重试上限,超限后关闭式失败(fail closed)。
from pydantic import ValidationError class NonConformingOutput(Exception): ... def decide(base_prompt, model, max_retries=2) -> Decision: prompt = base_prompt for _ in range(max_retries + 1): raw = model.generate(prompt, schema=Decision.model_json_schema) try: return Decision.model_validate_json(raw) except ValidationError as e: prompt = f"{base_prompt}\n\nYour previous output was invalid: {e}. Return JSON only." raise NonConformingOutput 边界处做验证,意味着系统其余部分只见到格式良好的决策;模型是否正常行为这个脏活被封装在这一个函数里。
用一个清晰的验证问题换掉了模糊的 NLU 问题——无需解析层、跨模型/提示词切换时依然稳定、内置护栏(固定枚举不可能返回列表外的东西)、且有类型的契约可供单元测试断言。 值得大声说明的一点:结构化约束的是形式,不是正确性。 一个完全合法的 {"decision":"approve","confidence":0.99} 可能完全错误。 结构化输出消除的是解析失败模式,而非判断失败模式——这正是它为何是生产系统的基础层,位于 evals、verification 和 confidence 之下,而不是它们的替代品。
置信度 → 路由
置信度(模型信号 + 校验 + 采样评判)由专门的置信度节点组合而成;路由节点将其转化为四条路径之一,使用单一阈值,prepare_proposal 随后将结果写入提案:
def route(confidence: float, verified: bool, T: float = 0.85) -> str:
if not verified:
return "reject"
if confidence >= T:
return "auto"
if confidence >= T - 0.2:
return "hitl_recommended"
return "hitl_required"
verified 来自 verification 节点( verified = all(checks.values) ),而非代理自己设置的字段。路由器发出全部四种路由状态。注意执行顺序:路由在提案成形之前运行(节点 9 → 节点 10),因此它接收的是原始置信度和 verified 标志,而非一个 Proposal 对象。阈值 T 初期要保守——全部交给人——再按数据切片逐步降低。人的注意力,这一昂贵资源,只花在系统不确定的地方。不可变账本:追加写入的决策记录
每个提议的决策都生成一条不可变行——作为每个决策路径的最后一个节点无条件写入。这不是一条日志行,而是关于发生了什么及为什么发生的规范记录。
CREATE TABLE decision_ledger (
 decision_id TEXT PRIMARY KEY,
 ts TIMESTAMPTZ NOT NULL,
 tenant_id TEXT NOT NULL,
 capability TEXT NOT NULL,
 inputs_hash TEXT NOT NULL,
 model_version TEXT NOT NULL,
 prompt_version TEXT NOT NULL,
 decision JSONB NOT NULL,
 confidence REAL NOT NULL,
 routing TEXT NOT NULL,
 outcome TEXT,
 supersedes TEXT REFERENCES decision_ledger(decision_id),
 prev_hash TEXT,
 entry_hash TEXT
);
对输入做哈希而非仓储——可验证性有了, liability 没了。账本必须是只追加的:纠错通过 supersedes 实现,绝不覆盖。如果你能 UPDATE 账本,它就不是审计轨迹——收回权限。高负载下也绝不能跳过写入——这是记录之记录,不是可丢弃的遥测数据。
有界 ReAct:循环应该待的唯一地方
如果遵循了以上所有——固定图结构、模型锁定在一个节点——迟早会遇到不适配的场景:开放性问题,模型需要查点什么、理解找到的内容、可能再查点什么、然后决策。这就是 ReAct 风格工具循环的用武之地。错误不在于循环本身,而在于无界的循环。把自主权作为深思熟虑的、带护栏的例外来开放——只在那个地方。
受控循环的四条轨道
当一个能力需要循环结构时,代码通过四条硬性约束来防止模型失控:
- 硬性迭代上限:使用
for而非while not done,确保模型无法自行决定何时终止 - 按能力划分的工具白名单:模型只能调用该能力显式允许的工具
- 全程执行追踪:每一步都记录在案,确保决策可回放
- 与固定流程一致的出口:循环输出仍需经过防护栏、验证、置信度评估和路由,且只提案、不行动
核心实现代码如下:
class DisallowedTool(Exception): ...
ALLOWED_TOOLS = {
 "enrich_request": {"search_kb", "fetch_record", "lookup_reference"},
}
@dataclass
class Step:
 i: int
 action: str
 args: dict
 result_digest: str
def bounded_react(state, deps, capability, MAX_STEPS=6) -> Proposal:
 allow = ALLOWED_TOOLS[capability]
 trace: list[Step] = []
 for i in range(MAX_STEPS):
 action = deps.model.next_action(state, tools=sorted(allow))
 if action.is_final:
 return finalize(action.proposal, trace)
 if action.tool not in allow:
 raise DisallowedTool(action.tool)
 result = deps.tools[action.tool](**action.args)
 trace.append(Step(i, action.tool, action.args, digest(result)))
 state = state.with_observation(result)
 return escalate("hit step cap", trace)
追踪记录会写入账本条目,因此基于循环的决策与固定图谱决策一样可重建。两条关键约束各有对应测试:
def test_always_terminates:
deps = fake_deps(model=never_final) p = bounded_react(state, deps, "enrich_request", MAX_STEPS=3) assert p.routing == "hitl_required" def test_disallowed_tool_refused:
deps = fake_deps(model=calls("danger_tool")) with pytest.raises(DisallowedTool):
bounded_react(state, deps, "enrich_request")
用还是不用:决策判断规则
判断一个能力是否需要循环结构,关键在于:达到决策所需的步骤数量和顺序,是否依赖于执行过程中发现的内容?
- 否 → 固定图谱(适用于大多数能力)
- 是 → 有界循环 + 四条轨道 + 明确文档记录
如果出于"安全起见"或"灵活性"而选择循环,应立即停止——这种情况下通常需要的其实是伪装成循环的固定图谱。不必要的灵活性就是在凌晨两点需要调试的不确定性。
反模式清单
- 业务状态直接写入:模型"顺手"修改了业务状态,导致不再纯粹、无法测试,Bug 从提案问题升级为生产事故。让底层设施成为唯一的变更者。
- 隐式状态通过临时元组或字典传递:无法对单个节点进行隔离测试,应将状态定义为类型化对象。
- Prompt 要求"返回 JSON"但无 Schema 约束:模型仍会输出自然语言、代码块或附加说明。应使用 Schema / 工具 / 语法约束,验证后重试——约束不等于保证。
- 直接使用模型输出的"置信度":模型置信度校准不良,应从独立信号组合计算。
- 可变更或被跳过的审计日志:如果账本可被更新,就不是审计轨迹;在负载下跳过写入则没有记录可言。
- 无界循环追求"灵活性":默认选择固定图谱。确需循环时,使用
for限制步数并配置按能力的工具白名单——绝不使用while not done或"所有工具可用"。
核心结论
第一级(一贯应用的一种规范)包含以下要点:
- 将模型限制在单一节点
- 将 Agent 设计为纯函数,只生成提案
- 用经过验证的 Schema 约束节点输出
- 从独立信号组合置信度,将模棱两可的情况路由给人工
- 审批后由简洁底层设施执行唯一的状态变更
- 每项决策写入只增账本
当某个能力确实需要自主性时,予以预算——步数上限、工具白名单、全程追踪,以及与其他能力一致的输出检查。
模型仍在做它真正擅长的事——处理混乱输入时的判断。但整个系统本身是确定的、可测试的、可审计的。说到底,最好的"无聊"就是:足够可预测才能测试,足够封闭才能信任,足够可辩护才能上线。这也是本系列后续所有内容建立的基础。
系列:LLM 系统生产运行指南 —— 六级体系之一级:确定性。
评论