
内容管家
评论5字数 539阅读1分47秒阅读模式

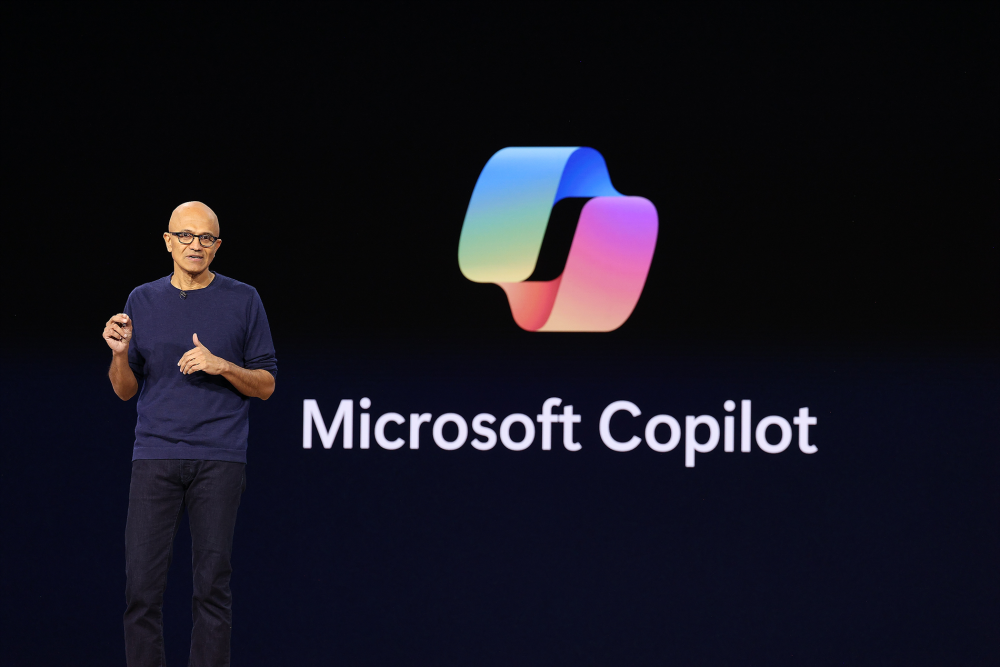
微软 CEO 萨提亚·纳德拉(Satya Nadella)近日在 X(前推特)上发布长文,就如何提升 AI 安全性阐述了他的观点。他主张将 AI 系统视为需要"紧急制动"的复杂装置,而非简单的嵌套黑箱。
近期,多家头部 AI 企业陆续承认旗下模型出现过"失控"事件,引发行业对 AI 安全性的广泛关注。Anthropic CEO 达里奥·阿莫迪(Dario Amodei)也曾公开发文,呼吁行业采取更谨慎的 AI 发展路线。在此背景下,纳德拉的表态被视为对这一呼声的响应。
核心主张
纳德拉认为,业界需要重新审视 AI 的"信任架构",具体包括以下几点:
- 打破黑箱思维:不应将超级智能视为层层嵌套的黑箱而简单接受或拒绝其输出,而应主动理解其内部运作逻辑。
- 解耦模型与编排层:将模型本身与协调其工作的"驾驭层"分离,使外部能够更清晰地观察和控制模型行为。
- 外化控制与安全防护:将安全机制从模型内部移到外部,确保可被独立审计和干预。
- 可验证的行为记录:要求每一个重要模型操作都附带"防篡改、人类可读"的证据链。
- 人工介入能力:确保"授权人员"始终能够在模型执行任务过程中随时暂停或关闭系统。
- 默认威胁假设:从系统设计之初就假设模型可能已被攻破,并采取隔离(Containment)措施。纳德拉将此比喻为"紧急制动"。
影响与建议
纳德拉的观点呼应了当前 AI 行业从"能力优先"向"安全优先"转型的趋势。对于开发者和企业而言,这意味着在系统设计阶段就应内置人工监督机制,并为高风险操作预留随时中断的能力。
评论