

企业级 AI 知识系统:为什么"搭建容易、运营难"
大多数有能力自建 AI 知识系统的工程团队,在真正动手之前都觉得这件事不难——上一个向量数据库,接几个连接器,把 RAG 管道指向文档目录,齐活。
六个月后,这条管道已经变成平台团队的全职工作。
问题不在于低估了数据库本身的复杂度,而在于向量数据库和受治理的知识管道根本是两件不同的事。前者一个周末就能跑起来,后者却是一场关于信任、合规和持续运营的持久战——而且随着新数据源加入、文档过期、Agent 接入,负担只会越滚越大。
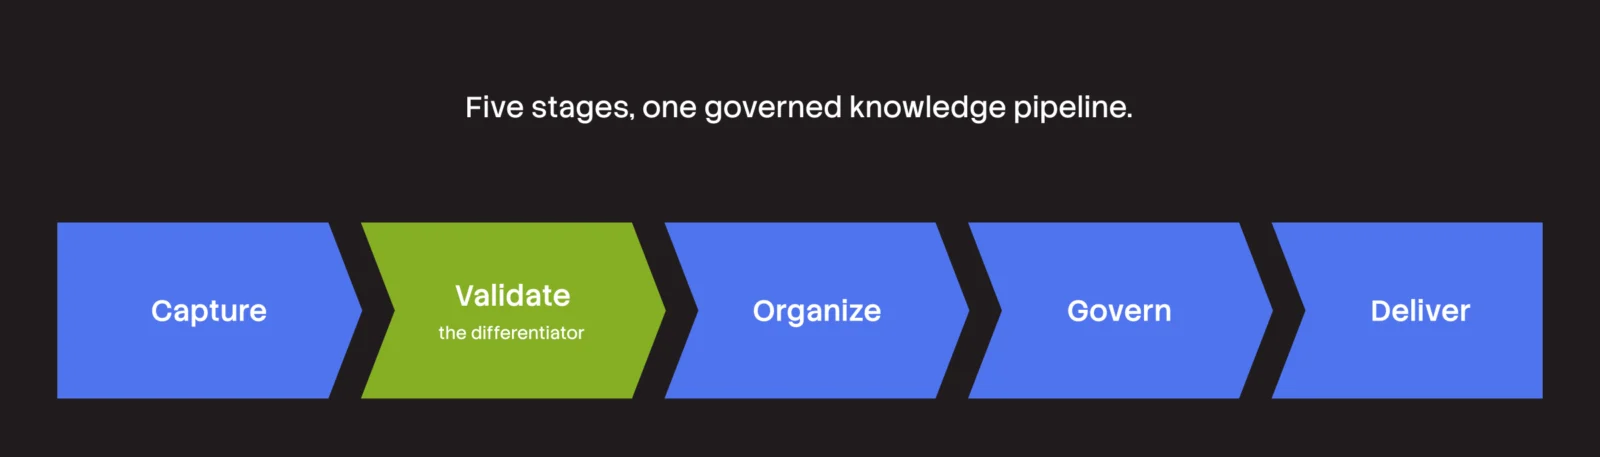
一条可用于生产环境的管道,拆解下来分为五个阶段:
看似简单的阶段,往往是最难的
上面每个阶段单独拎出来看都不算棘手,一个强力团队很可能全部搞定。真正的陷阱在于低估了持续维护这条管道的成本。这些都不是"一次构建、永久托管"的投入——随着 AI 栈的复杂度上升,成本只会叠加,不会消失。
采集阶段:原始文档远远不够
写一个连接器并不难,真正的难点在于随着厂商 API 演化保持同步。而且即便连接器完美无缺,它也只是一个副本——Agent 无法像人类那样快速浏览上下文。如果你给它一条原始 Slack 对话,它往往能命中正确的文档,却提取错了段落。
这就是为什么采集层的输出物不能只是一个存储副本,而应该是知识节点(Knowledge Node)——一条活记录,承载着知识的实质内容、来源、负责人以及可信度评估。即便源工具明天消失,知识本身依然存在。
校验阶段:信任在这里真正建立
这是大多数自建管道最容易跳过的环节,却恰恰是最关键的一层。把所有采集来的内容一视同仁地视为可信,是企业 AI 上下文层最常见的致命错误。有些知识是权威结论,有些则是已被推翻的决定却没人打上标签——没有区分机制,Agent 就会用同等自信的语气呈现两者。
校验以两种模式运行:隐式信任(全自动)和显式信任(人工兜底,适用于高风险场景)。
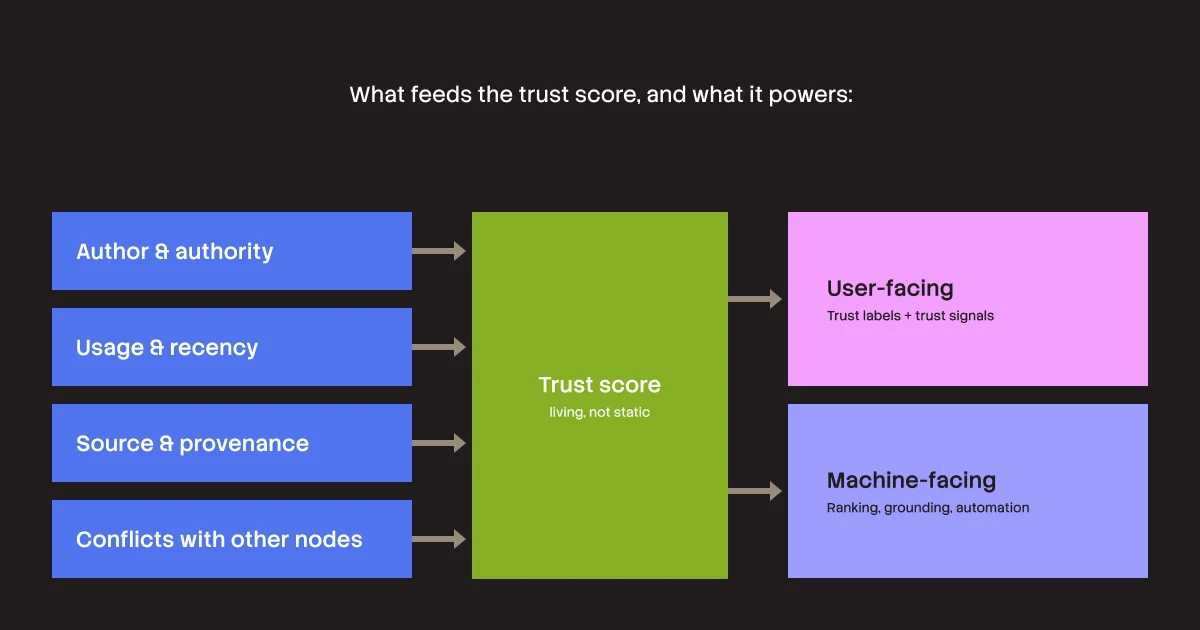
每个知识节点都携带一个由多维信号综合计算出的信任分数,涵盖作者身份、使用频率、知识时效、来源可靠性,以及是否与其他知识存在冲突。大多数内容通过隐式信任自动获得信任分——比如来自资深工程师的合并 PR,或者有明确负责人的已定稿政策。
但信任会衰减。六个月前准确的节点今天未必仍然有效。因此当节点信任分跌破阈值时,系统会向其负责人推送一个轻量级的"一键复核"请求。
隐式信任 vs. 显式信任 衡量这套体系健康度的核心指标是:今天打断了多少人? 每一次人工介入都是隐式信任层运转不够顺畅的信号。
组织阶段:知识进入正确的空间
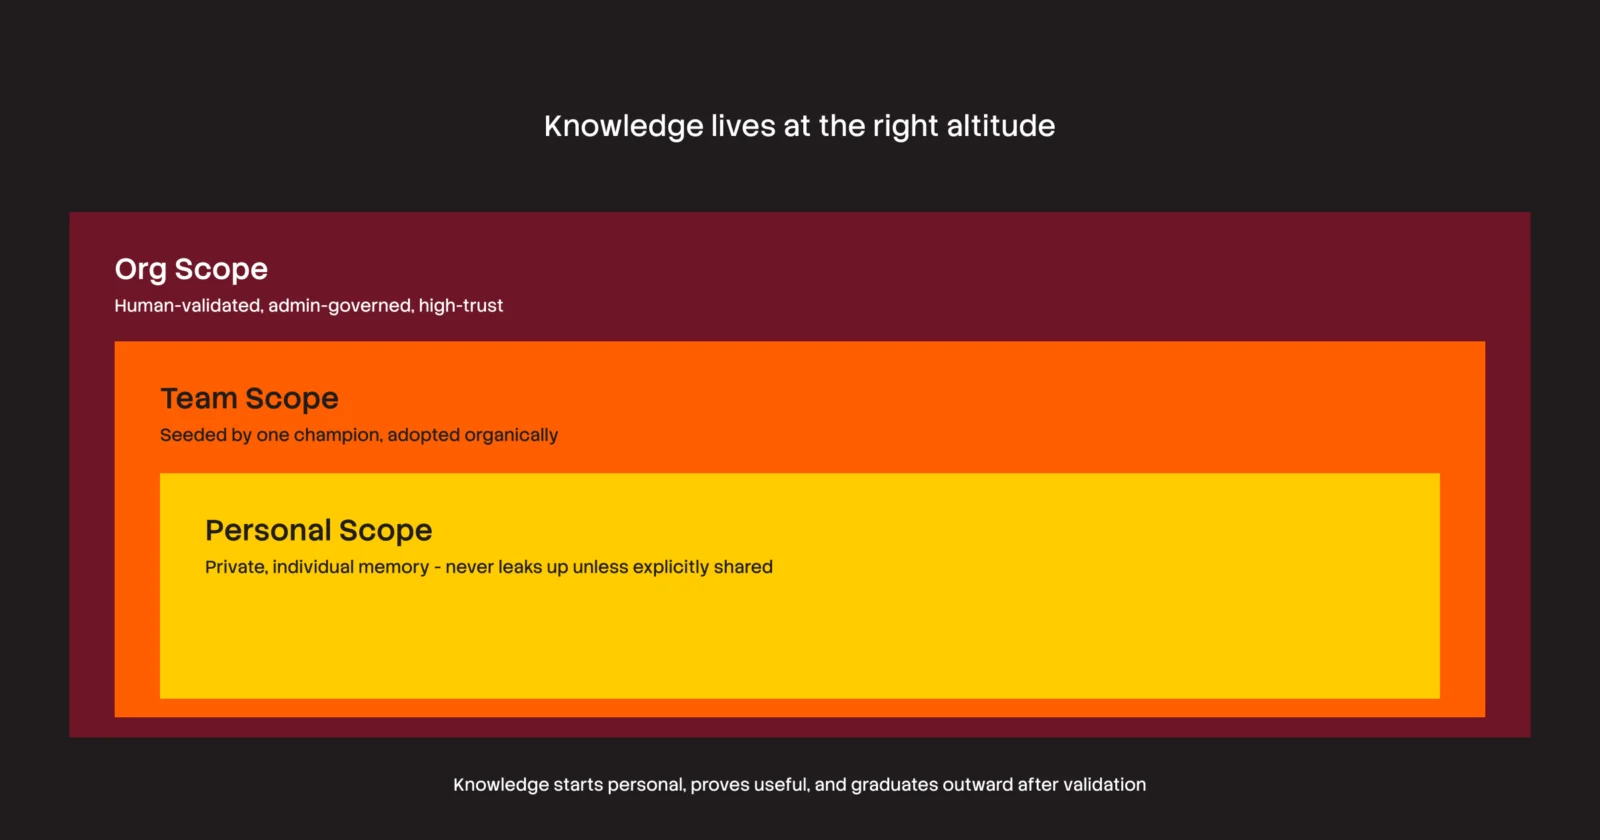
并非所有知识都应面向同一批受众。一名工程师针对自己服务所做的技术决策,分量不应等同于公司级的架构决策,影响范围也理应不同。Scope(作用域) 通过定义"哪些信息属于哪个范围、谁能在该范围内操作"来为知识赋予上下文。这套体系是自动填充的,而非人工归档——知识自然沉淀到合适的空间,而非堆在一个无人愿意涉足的巨型池子里。
知识默认从"个人+私有"开始:开发者反复向 AI 工具解释的访问权限规则,通过 Scope 继承机制实现自动化。Scope 将知识组织到对应上下文,从接入起就应用相应的权限策略。Agent 在某个上下文内获得的权限边界,与同上下文下的人类操作者完全一致——开发者的个人知识不会未经允许泄露给团队,团队知识也不会未经授权扩散到全公司。
治理阶段:企业买家真正需要的控制面
AI 治理必须作为自动化系统,无缝嵌入企业 IT 和安全团队已经使用的工具中。批准全员 AI 落地的负责人有自己的要求:批量设置权限而非逐个操作、需要知道谁访问了什么记录以接入现有安全监控、要在不登录额外仪表盘的情况下掌握系统使用情况。
治理必须同时满足两类使用者:一个是浏览设置页的人类,一个是后台例行检查的自动化系统。
随着 Agent 承担起更关键的任务——例如直接回复客户支持询问或为产品决策提供依据——将任何 AI 输出回溯到具体某条经验证内容、经由哪位具名审核人于何日批准的能力,就不再是加分项,而是一项合规要求。
交付阶段:让知识抵达工作发生的地方
经过验证、组织和治理的知识,如果无人接触到,本质上和锁在档案柜里没有区别。交付有两种模式:显式检索(用户提问,获得最优答案并附带信任分和来源链)和主动推送(系统在工作发生前预判并呈现相关知识,例如工程师打开一个新服务时,系统发现另一个团队半年前遇到过完全相同的瓶颈)。
MCP(Model Context Protocol) 让这一切变成可组合的标准化方案,而非为每个 Agent 单独定制对接层。有了统一的标准接口,每次查询都基于图谱中当前、已验证的状态,而非一张过期快照。
维护成本是持续性投入,而非一次性开支
随着 AI 技术栈日益复杂,知识基础设施的维护负担会同步叠加——连接器需要持续更新、信任模型需要反复校准、中小企业工作流随团队规模扩张而变形、审计人员随时可能要求提供完整的操作轨迹。这些成本并非一次性的,一旦忽视就会不断累积。
Stack Internal 如何消化这些隐性成本
Stack Internal 平台将上述难题视为设计层面的基础问题,而非后期打补丁:
- 连接器框架:基于稳定的连接器框架采集数据,无需维护一套临时拼凑的定制集成。
- 自动信任验证:在请求人工介入之前,先完成自动化验证,建立可信赖的基线。
- 知识域自动划分:无需人工手动归档,系统即可将知识正确分组。
- 合规与审计:将审计追踪和防护栏作为底层能力,而非事后补齐。
- MCP 原生交付:开箱即支持 MCP(Model Context Protocol),默认集成。
构建 vs. 采购:核心判断标准
构建一个向量数据库并不困难,但构建一套可治理、可信赖的知识管道,远非多数组织所能负担。Stack Internal 正是针对这一差距设计:让平台承担知识基础设施的持续性运营成本,团队则专注于自身业务。
评论