

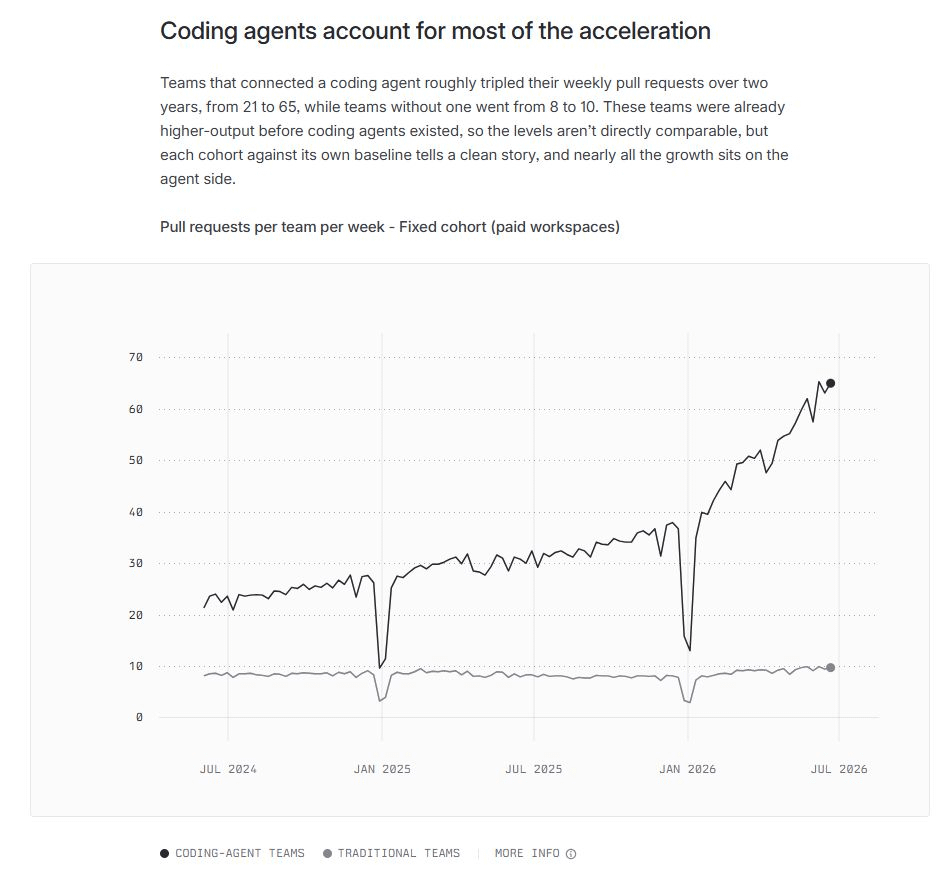
Linear 近期发布了一份平台数据分析报告,涵盖 2024 年 6 月至 2026 年 8 月、近 20 万用户的行为轨迹。核心数据如下:
- 使用 AI 编程代理的团队:每周 PR 从 21 个增长至 65 个
- 未使用代理的团队:每周 PR 从 8 个微增至 10 个
- Linear 平台上由 AI 生成的内容已约占总创建量的 50%
- 代理每周发起约 240 万个 issue,与人工发起的约 250 万基本持平
- PM 参与写代码的比例从 3% 升至 10%,设计师从 1% 升至 8%
- 两年内,每个 workspace 的 PR 总量增长了 111%
产出翻了倍,时间却没省
真正值得玩味的是:没有任何团队真正节省了时间。 工作总量没有下降,只是把 AI 塞进了原有的流程。团队依然做和以前一样的事,甚至因为来回审核&查验 AI 产出,总投入反而增加了。
这里的核心问题是:每周 65 个 PR 是否真的带来了 3 倍的价值?做代码重构会消耗 token,修复 bug 则不会。二者的价值显然不同——产出数量不等于价值增量。 Linear 在报告摘要中给出了一个精准的判断:AI 深刻改变了团队的执行方式,但几乎没有改变团队决定做什么的方式。也就是说,执行不再是瓶颈,决策才是。
TypeScript 7.0 发布:编译速度快了 10 倍,但 Vue/Svelte 用户还需等待
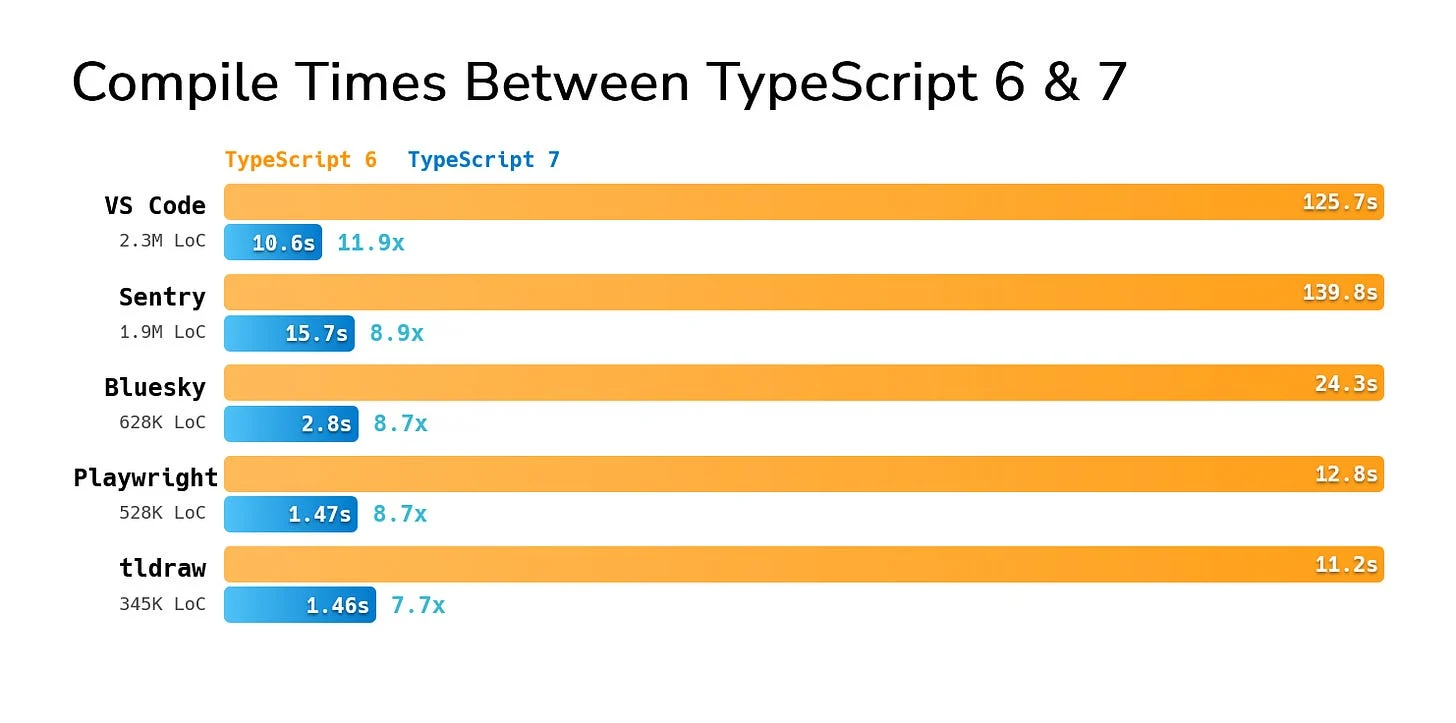
2025 年 3 月,微软宣布将 TypeScript 编译器移植到 Go 以实现 10 倍性能提升。2026 年 7 月 TypeScript 7.0 正式发布,实测数据:
| 项目 | 移植前 | 移植后 | 提升倍数 |
|---|---|---|---|
| VS Code(230 万行代码)完整构建 | 125.7 秒 | 10.6 秒 | 11.9× |
| Sentry(190 万行代码) | 139.8 秒 | 15.7 秒 | 8.9× |
| Playwright | 12.8 秒 | 1.47 秒 | 8.7× |
| 编辑器首次报错响应 | 17.5 秒 | 低于 1.3 秒 | — |
| 内存占用 | 基准 | 降低 26% | — |
部分已迁移的团队也分享了实际收益:Slack 将 CI 中的类型检查从 7.5 分钟压缩至 1.25 分钟;Canva 团队首次报错等待时间从 58 秒降至 4.8 秒。
Go 而非 Rust:类型检查器的环形数据结构难题
7.0 同时是一次清理:不再支持 ES5 编译目标,baseUrl 配置被移除,strict 模式改为默认开启。
不过仍有一处遗憾:程序化 API 要等到 7.1 版本。因此目前使用 Vue 或 Svelte 的开发者,在编辑器内仍需依赖 TypeScript 6。
值得注意的是,移植前微软其实先尝试过 Rust,但最终放弃——原因是 Rust 的借用检查器无法处理编译器中大量存在的环形数据结构(circular data structures),Go 则没有这一限制。
GitHub 8 小时宕机复盘:代理流量暴涨是导火索
8 月 17 日,GitHub 平台遭遇严重降级,峰值错误率约 20%,内容下载错误率达 50%。大部分服务在 3 小时内恢复,但 GitHub Actions 和 Copilot Token Service 受到更长时间影响,整体修复耗时接近 8 小时。这是当月第二次大规模故障。
GitHub 随后公布了详细根本原因分析(RCA),链条如下:
第一层:Istio sidecar 触发连锁过载
故障起点是美中区域负载均衡节点遭遇网络饱和,原因是某个 Istio sidecar(Kubernetes 多容器 Pod)达到并发上限后未能正确自动扩容,导致请求堆积。
第二层:HAProxy 节点接连锁死
过载蔓延至 4 个 HAProxy 节点,Gateway 认证路径随之降级。
第三层:VS Code 重试 bug 将流量放大 10 倍
真正的放大效应来自客户端:Copilot token 调用失败后进入重试循环,VS Code 中一个潜在的重试 bug 将流量乘以 10 倍。原本每秒 7~9K 请求的服务,瞬间飙升至 70~100K。GitHub 最终通过在负载均衡层返回 403 才将其截停。
根因:算力没跟上 AI 代理狂潮
深层背景是流量增速已远超预期:月度 commits 从 4 月的 14 亿增长至 29 亿,2026 年 9 月已达 73.8 亿,但基础设施容量并未同步扩展。AI 代理和"振动编码"(vibecoding)的普及正在以前所未有的速度消耗平台资源,这次宕机某种程度上是必然。
4. AI 成本远不止 Token 消耗
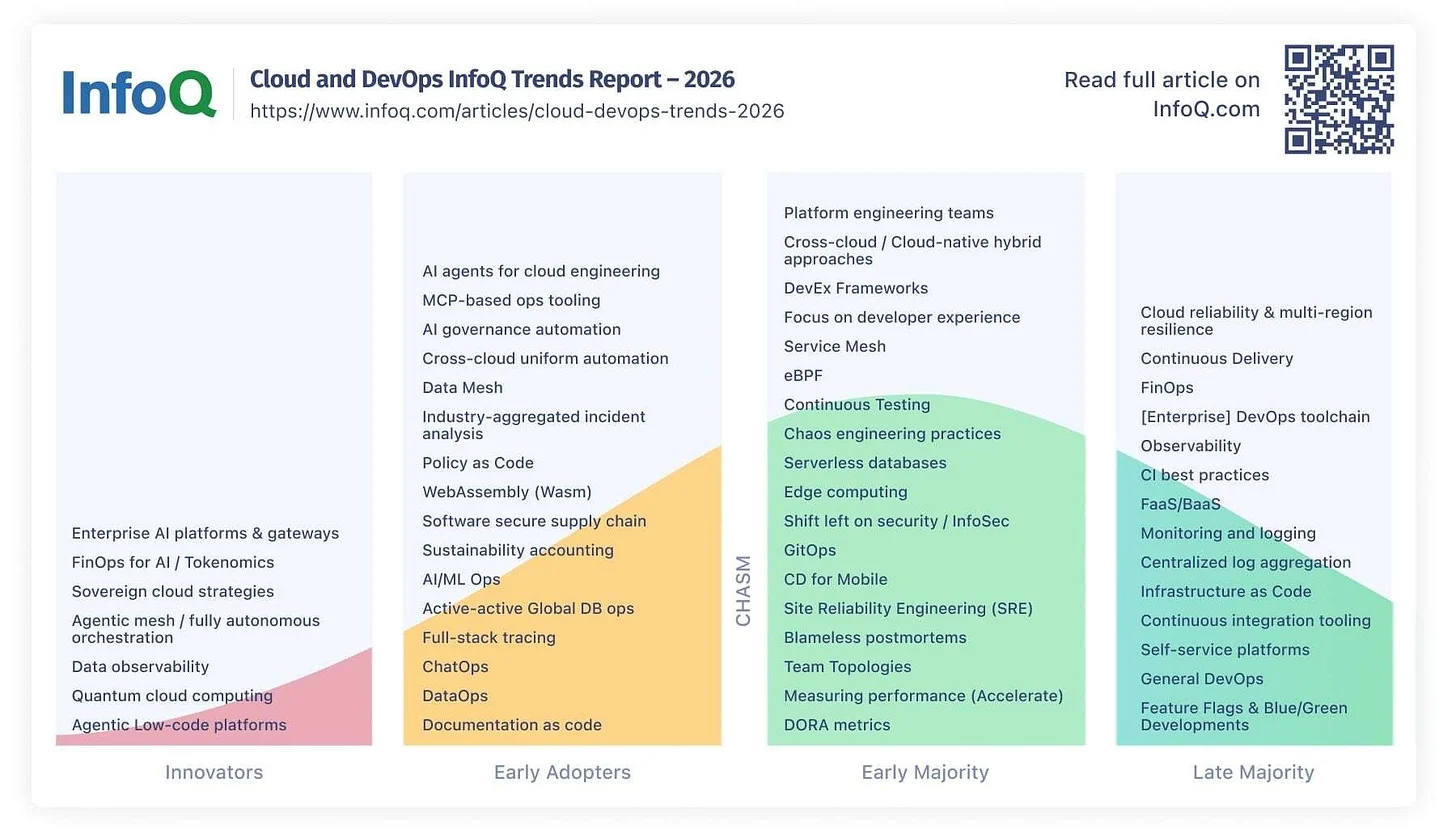
InfoQ 最新发布的 Cloud and DevOps 趋势报告 揭示了几个值得关注的方向: AI 工程助手从尝鲜进入早期普及阶段。 助手正在从单纯的"聊天工具"转向基于实际操作的场景。AWS、微软相继推出 DevOps 助手,Google 也在 GKE 中集成了助手沙箱。不过企业在治理和合规层面仍面临挑战。
Model Context Protocol(MCP)进入早期大众阶段。 Anthropic 于 2024 年 11 月推出的这一协议正在成为 AI 工具集成的行业事实标准,后续发展主要围绕安全与身份认证展开。
平台工程同样处于早期大众阶段。 KubeCon 现场调查显示,70% 的观众认为平台工程不过是 DevOps 的"换皮"。今年的报告提出,应让 AI 融入平台、减少影子平台,而非继续搭建各种门户。
AI 费用治理(FinOps for AI)仍处于创新者阶段。 Token 消耗成本不菲,企业需将其纳入 IT 预算。虽然目前已能追踪 Token 消耗量,但尚无法衡量其实际产出价值。2025 年底成立的 Tokenomics Foundation 正是为了填补这一空白。
主权云也处于创新者阶段。 欧洲企业(如银行)希望数据留在本地,而非"飘在某个云上"。此前不少企业因此转向本地部署。
云可靠性与韧性已进入后期大众阶段。 今年 AWS 某区域曾宕机长达半年,多区域架构设计与运维准备已不再是可选项。
综合来看,下一阶段云领域的大部分工作将围绕"集成"展开——工具可以更少,但需要串联得当,让 AI 真正融入平台。
5. AI 承担 42% 代码编写,工程师职责转向"守门人"
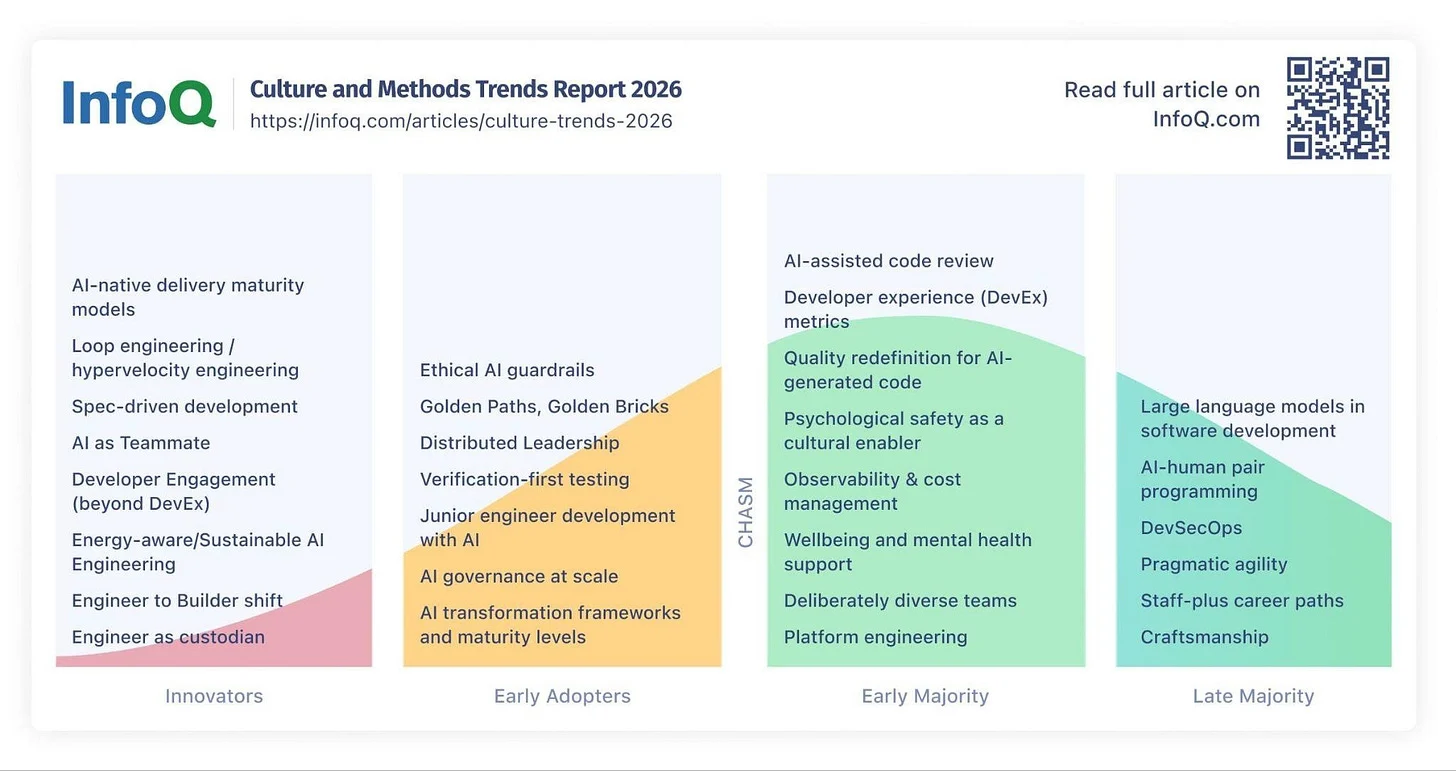
InfoQ 同时发布了 Culture and Methods 趋势报告,聚焦 AI 对团队文化与角色分工的影响。关键要点如下: 工程师的角色正在转变为" custodian"(看护者)。 当前工程师的核心工作变成管理 AI 助手、核查其输出、为 AI 构建防护栏。"看护者"这一角色已有标准化产物——许多项目现已引入 AGENTS.md 文件作为规范。
验证缺口显著。 Sonar 调查了超过 1100 名开发者,发现 AI 已承担 42% 的提交代码,但 96% 的开发者不信任 AI 生成的代码,仅有 48% 的开发者在提交前始终核查 AI 输出。
代码量爆发式增长。 GitHub 2025 年全年达到 10 亿次提交,目前每周约 2.75 亿次,预计今年将超过 140 亿次。按现有流程,没人能审核 14 倍增长的代码量。
"一块披萨"团队兴起。 传统"双披萨团队"正在缩减为两人加一群 AI 助手。报告指出这可能导致思维多样性下降,同时工作强度不减反增, burnout 风险上升。
可问责性成为新的"资历"衡量标准。 关键问题不再是"你能交付多少",而是"你能承担多少责任"。"是 AI 写的"不能作为生产事故的免责理由。
核心转变在于:工程师的技能从"审核&查验 PR"转向"为 AI 助手设定约束框架"——包括规格说明、测试覆盖率阈值、边界条件等。
6. SWE-bench 通过的 AI PR,约半数无法被合入主分支
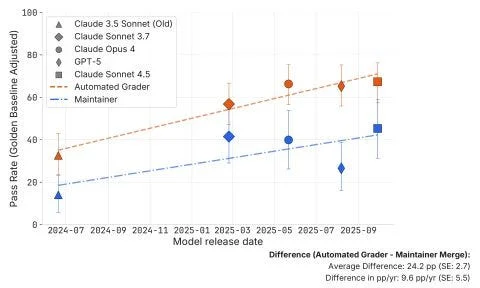
SWE-bench 采用自动化评分,而真实项目由维护者日常维护,两者之间存在天然落差。METR 研究人员 对此进行了量化测量:他们将 AI 生成的 Pull Request 交给对应仓库的实际维护者,按照常规流程审核&查验。
实验设计如下:来自 scikit-learn、Sphinx、pytest 的 4 位活跃维护者,共审核&查验了 296 个已通过 SWE-bench 自动化评分的 AI 生成 PR。审核&查验全程在 GitHub 上进行,且未告知审阅者哪些是 AI 所写。
核心结论:
- 合并率比自动化评分结果低 24.2 个百分点(已对维护者审阅严格程度进行校准)。值得注意的是,同一批维护者对人类原始补丁的合并率也仅为 68%。
- 拒绝原因主要集中在:代码质量薄弱、破坏其他功能、未真正解决核心问题。
- 按自动化评分,Claude Sonnet 4.5 处理一个普通人需要约 50 分钟的任务;但按维护者审核&查验标准,实际有效工作量仅约 8 分钟。
研究使用了 95 个 SWE-bench Verified 问题和 5 个 2024 年中至 2025 年底发布的模型。METR 特别说明:AI 助手只有一次尝试机会,无法像人类开发者那样与审阅者来回沟通——这并非 AI 能力的天花板。
实践启示: Benchmark 分数只能说明测试通过,不代表代码适合你的代码库。这也是我们团队坚持对 AI 生成的 PR 进行人工核查的原因。
AI:能力放大器,而非万能药
AI 在软件开发中扮演着"能力放大器"的角色——它会让高效团队的效率更高,也会让低效团队的乱象更严重。这并非隐喻,而是有数据支撑的结论。
新建项目 vs 遗留代码:效率提升差距悬殊
报告实测数据显示,在新建任务(greenfield)中,AI 可带来 35%~40% 的生产力提升;而在遗留代码(legacy)场景下,这一数字不足 10%。
两者差距的根源不在工具本身,而在于团队的基础设施质量。一个拥有清晰所有权划分、成熟评审流程的团队,接入 AI 后如虎添翼;反之,若边界模糊、流程混乱,AI 只会让问题暴露得更快。
最大的回报不来自写代码,而来自减少返工
大多数技术负责人将注意力放在"代码产出加速"上,却忽略了更重要的一点:AI 最大的价值在于减少返工,让团队拥有更多可用于真正创新,而非修补的时间。
J 曲线:变革前的"学费"
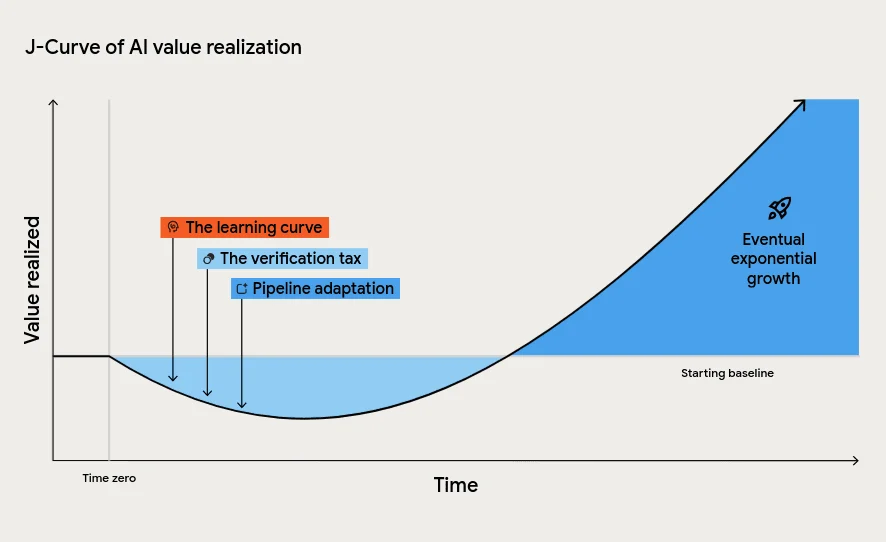
报告还提到了一个值得关注的现象——J 曲线。简言之,引入 AI 的初期,生产效率会先经历一段下降期,之后才会持续上升。DORA 将这段下滑称为"变革的学费"(tuition cost)。
这与二十年来见过的所有工具一样:每一款工具都声称能修复组织问题,但最终只是让问题更快浮出水面。先修系统,再买工具,才是正确的顺序。
9. AI 如何改变开发者的工作方式
Cursor 近期发布的首个开发者习惯报告(Developer Habits Report),揭示了一个比"写代码更快"更值得关注的事实:工作的形态本身正在改变。
产出量翻倍,但规模才是关键
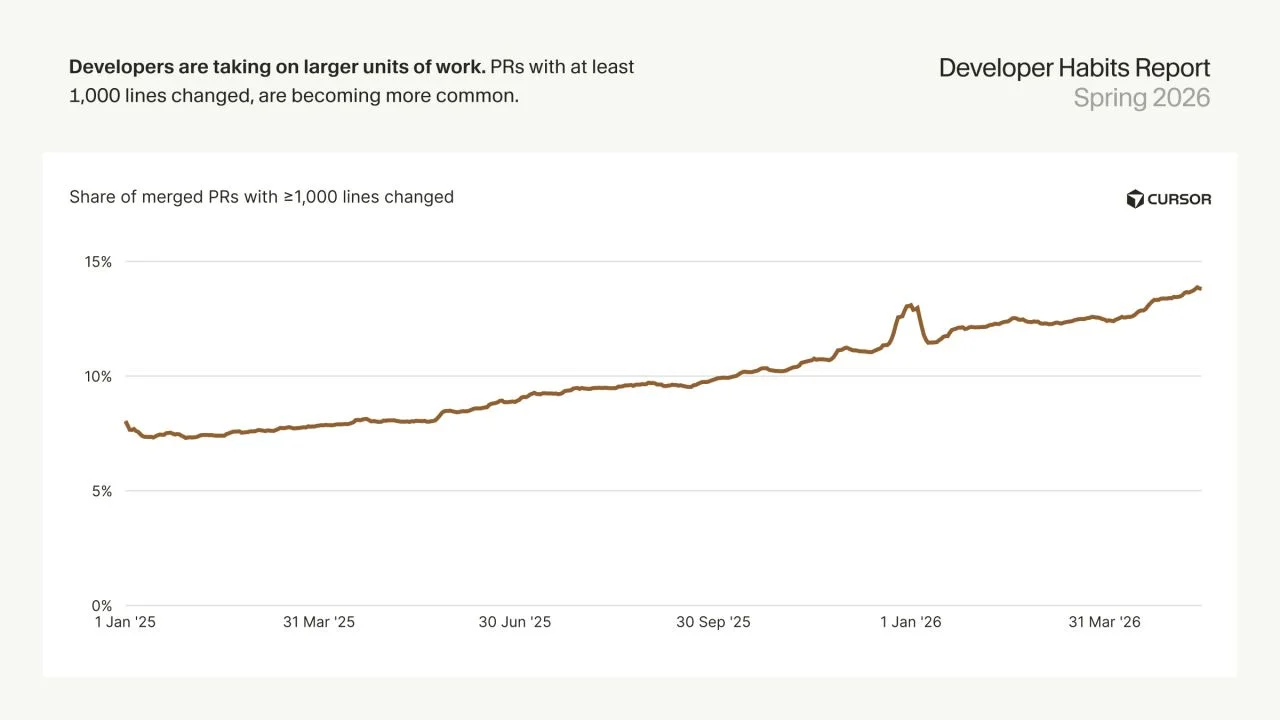
开发者每周新增代码行数在一年内翻番,从 4.2k 行增长至 8.6k 行。不过 Cursor 自己也承认,行数并非理想指标。更值得关注的信号是:单个 PR 的代码规模逐年增大——每年增幅约 2.5 倍,而大型 PR(变更量 1000 行以上)的占比从 8% 上升至 14%。
头部开发者与中位者的差距正在扩大
AI 带来的红利并非均匀分配。P99 开发者的产出是活跃中位开发者的 46 倍,合并的 PR 数量是其 15 倍。AI 生成代码的基尼系数高达 0.77,更接近极端的收入分布曲线,而非平坦分布。这意味着头部开发者从 AI 中获益更多,差距随工具普及而进一步拉大。
模型"读"的内容远超"写"的内容
模型的输入/输出 token 比率从约 4.5 倍翻倍至约 11 倍。目前输入 token 占非缓存 token 总量的 90% 以上。换言之,模型的大部分算力用于构建上下文,真正用于生成代码的部分反而有限。
但上下文质量直接决定代码质量:AI 生成并在 60 分钟后仍被保留的代码比例,已从 76% 上升至 81%。
单次请求成本差异近 9 倍,但按最终采纳行数计费更划算
不同模型家族的单次请求成本相差近 9 倍:从 Composer 2.5 的 0.18 美元到 Opus 4.7 的 1.57 美元。但按"每行被采纳代码"计算,成本差距缩小至约 7 倍,因为更贵的模型每次请求产出的可用代码更多。最便宜的单次请求不一定是最划算的每行成本。
无需手动确认即可提交的比例激增
自今年 1 月以来,Agent 修改直接进入提交(commit)而无需人工逐条确认的比例增长了超过 5 倍:从 7% 上升至约 36%。需注意,这里衡量的是编辑器内的接受(accept)点击,而非 PR 评审环节。这一比例的攀升,折射出开发者对 AI Agent 自主完成修改并提交的信任度正在提升。
评论