

让 AI 写代码越快,验证产品想法就越重要:Itamar Gilad 的证据引导方法
有了 AI 智能体,我们今天产出的软件数量空前庞大,交付速度也比以往快得多。过去需要一个月的活儿,现在一个周末就能做完。但问题也出在这里:我们倾向于直接动手、烧掉 token,然后上线发布——在有人验证过这个想法之前。
本期访谈的嘉宾 Itamar Gilad 并不认同这种做法。他曾在 YouTube 工作,在 Google 主导过 Gmail 的部分业务,此前还在微软任职,如今专注于为产品团队做教练,并写下了《Evidence-Guided》一书。书中提出的 GIST 框架与“信心度量表(Confidence Meter)”,对做产品的工程师来说尤其有参考价值。
本期我们会聊到这些话题:
- 他是谁:从工程师到 Google Gmail 产品负责人,是什么促使他写出《Evidence-Guided》。
- “三分之一”这个数字的来源:A/B 测试数据、功能使用的幂律分布,以及回看自己的路线图,指向的都是同一个结论——用户的行为并不容易改变。
- 被证据“杀死”的 Gmail 创意:假门测试和可用性测试都说“行”,A/B 测试却在功能全部做完之后说“不行”。这次失败催生了信心度量表。
- 廉价 AI 编码为什么让验证更重要:验证从来不是为了省开发时间。未经验证的想法上线,会把产品塞满功能;“上线再迭代”是一种昂贵的学习方式。
- 工程师做自己产品时的三个常见错误:拒绝在细节上妥协、忽视分发,以及先选技术再定问题。
- 面向工程师的 GIST:Goals、Ideas、Steps、Tasks,以及他作为单人从业者如何跑一套去掉敏捷流程的精简版。
- 没有职权时能做的最小第一步:先说服 PM 和设计师,一个人跑不起来。
- AI 研究算不算证据:AI 能分析数据、做网络调研、设计实验、整理访谈,但它无法替代用户。
- AI 如何改变了他自己的工作流:做新概念的“回音板”、把概念可视化、仍需亲自核查的研究,以及访谈笔记。
- 这周就能开始问的六个问题:从“我们为什么要做这件事”开始,再到“我们凭什么认为这个说法是真的”。
从工程师到 Gmail 产品负责人:Itamar 是谁
Itamar 是一位教练、作者和演讲者,专长是证据引导的产品管理与产品战略。二十多年间,他在 Google、微软以及多家创业公司担任过高级产品与工程岗位。在 Google 期间,他先在 YouTube 工作,后来负责 Gmail 的部分业务。
他的个人站点 itamargilad.com 上,资源页面 提供了一批免费下载的模板,包括 GIST 看板、结果路线图、信心度量表等,同时还有多本电子书。他的著作 Evidence-Guided 详细拆解了 GIST 模型,配有大量案例与操作指南。
“最多三分之一有效”:这个数字是怎么来的
我们今天产出的想法中,最多只有三分之一能产生可衡量的效果。大部分团队从来不知道到底是哪几个起了作用,因为压根没人去度量发布后的结果。这一点对以工程师为主的读者群体尤其关键——因为提出这些想法的正是他们。
这个判断有多重来源相互印证:
- A/B 测试分析:跨测试的汇总结果显示,最多只有 1/3 的实验产生了预期效果;多数毫无影响,还有一些则是完全没有任何影响。
- 功能使用的幂律分布:在任何一家公司分析功能使用情况,都会发现一条幂律曲线——少数功能被广泛使用,部分功能偶尔有人用,而更多的功能几乎无人问津。
- 回看自己的路线图:如果从结果维度倒推过去几年的路线图,你会发现几乎没有任何一件事真正大幅推动了指标。多数押注的效果,最好的情况也只是小幅变化。
换句话说,我们身处一个高失败率的工作环境,只是大部分失败被隐藏了起来,因为没有度量发布结果。由此产生的浪费量极其惊人。提升成功比例,是产品公司在市场上取胜最大的杠杆。 原因其实很简单:用户和客户的行为极难改变。他们倾向于无视新东西,继续使用自己已经熟悉的东西——有时甚至是产品的旧版本。一个功能要成功,需要连闯几道关:用户必须先知道它的存在,然后愿意试一次,再持续使用;他们还得愿意付出学习新行为的成本,并为一件自己并不熟悉的事情承担风险。我们的想法,胜算天然是偏低的。
被证据否决的 Gmail 创意:信心度量表的由来
我曾在 Gmail 主导过一个重要的战略性创意。我们最初用假门测试(fake-door)和可用性测试做了验证,然后犯了一个错误:把整个功能先实现出来(这对我们和其他团队来说成本都很高),最后才做 A/B 测试。结果非常糟糕,无论怎么迭代都没有改善。
证据是决定性的——没有理由上线这个功能,于是我们没有发布。团队非常失望,我作为 PM 心里也很不好受。但最终这是正确的选择。这次经历给我的教训是:不能过度信任假门测试、可用性测试这类早期测试,它们很容易制造出虚假的信号。后来我把这一认识整理成了信心度量表。
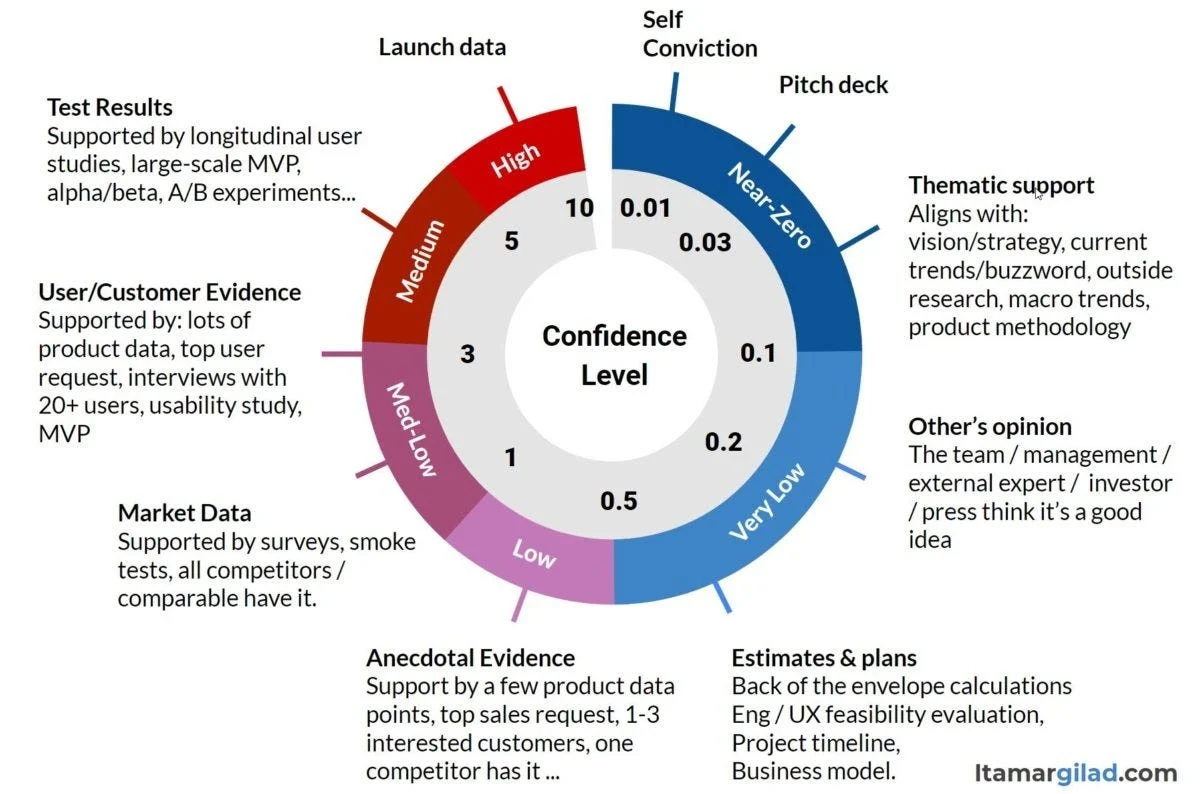
信心度量表是我用来评估“支持某个想法的证据分量”的工具。可以把它想成一支温度计:刻度从 0(我们对这个想法毫无信心)到 10(十拿九稳)。右上角(深蓝色)主要对应个人或小组的意见,这类证据几乎不能给出信心——最多 0.1/10。右下角则对应“与他人一起评审这个想法”以及“在纸面上分析它”,这类测试要难一些,但也只能带来 0.5/10 以内的信心水平。
AI 让开发变便宜之后,产品验证反而更重要:一份基于证据的研发实践指南
围绕产品验证的讨论中,一个常见问题在 AI 编程普及后被重新提起:过去开发成本高,所以必须先验证想法;现在 AI 让编码变便宜了,是不是可以直接「构建、发布、看看结果」?
答案是否定的。但真正的原因往往不在「省了多少编码时间」上,而在学习效率、产品健康度和组织协作方式上。
证据分级:从 Anecdotal 到上线后真实数据
在收集支撑性证据时,通常有两大类来源。
- Anecdotal(轶事性证据):少量数据点,信息密度低。
- Market Data(市场数据):规模大得多的数据集,需要为每项假设设定合适的置信度水平,但置信度永远不应超过 3/10——也就是说,再厚的市场数据也不能单独支撑「已验证」的结论。
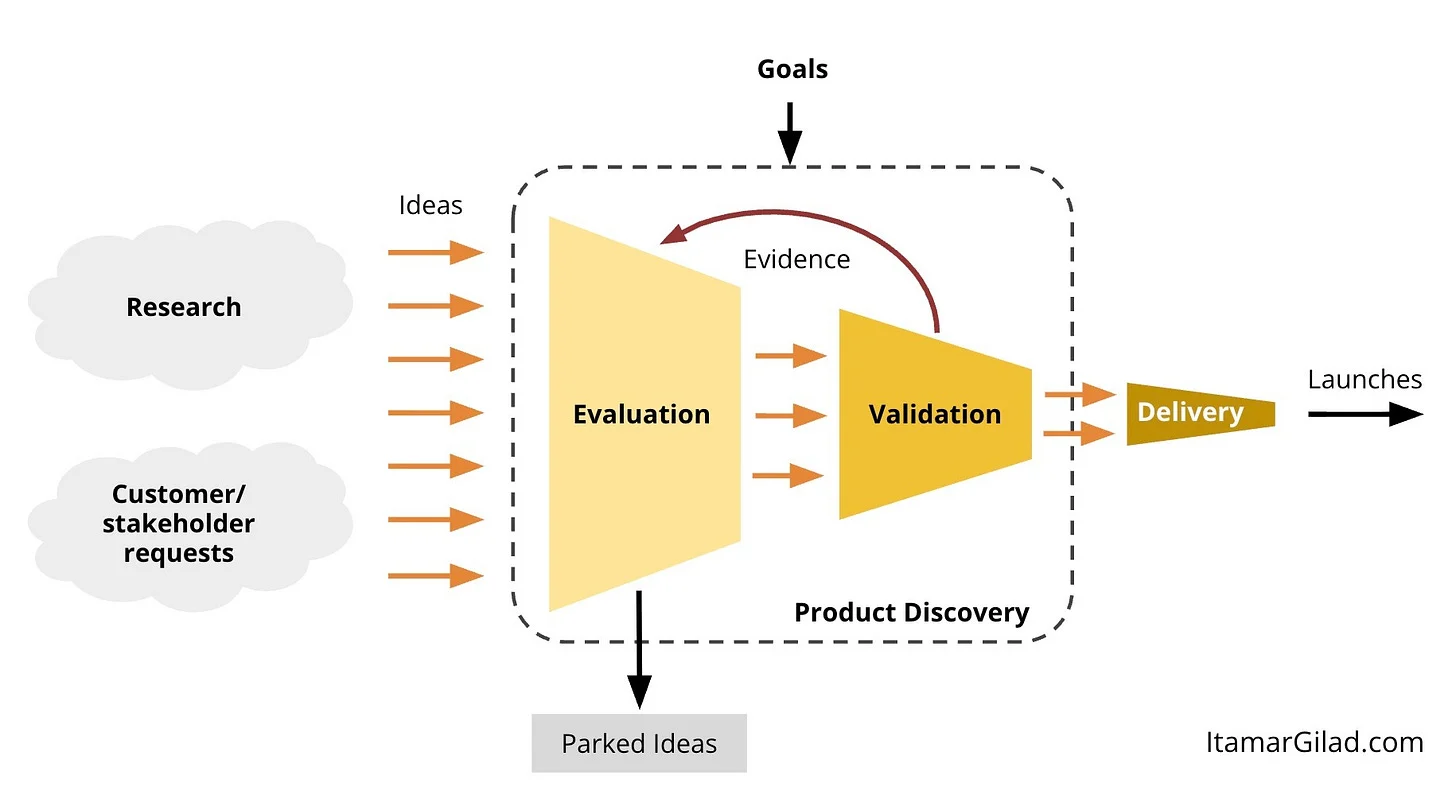
最高级别的证据来自测试想法本身。不同的测试方式给出的信心水平不同,取决于测试的严谨程度。
而终极测试只有一个:上线后的真实数据。
现实约束是:我们不必为每个想法收集齐所有类型的证据,也不必每次都冲到高置信度。「Good enough」的判定标准,是由这个想法的成本和风险共同决定的——相关论述。
AI 让构建变便宜:证据驱动开发是更重要还是更不重要?
「我们以前要验证想法是因为开发太贵,现在变便宜了,所以直接做、直接发、看看会怎样」——这个说法有几个明显漏洞。
1. AI 只加速了编码,并没有让整体验证成本下降
AI 确实加速了写代码,但同时也让某些事情(例如验证代码本身)变得更贵。更长期的维护成本、安全成本也还不明朗。换句话说,开发到底被加速了多少,目前并不清楚——这个比例大概率因产品和团队而异。
2. 验证从来不是为了省编码时间
我们验证想法,主要是因为上线一个坏想法是致命的反模式:把大量几乎没人用的功能塞进产品,代价极高;同时也会付出错过更好想法的机会成本。
3. 「发布—迭代」是一种昂贵且低效的学习方式
功能上线后再评估效果会困难得多:同时并行发生的事情太多,无法隔离出新功能本身与并行营销活动的影响。而且线上功能更难迭代,人也往往缺乏动力去承认它没有成功并转向下一个。
AI 编程确实能让我们更快抵达一个高置信度的测试环节(见上文信心度量表的说明),因此也许可以跳过一些早期的验证步骤。但完全跳过验证,等于在 100% 的用户身上做测试,这几乎从来不是好主意。
结论:在 AI 时代,证据驱动的开发一如既往地重要,甚至更重要。
工程师与独立开发者最常见的产品错误
一位前工程师视角的复盘,这几类错误他自己也都犯过。
不愿削减棱角
表现为:功能求全、质量门槛设得极高,或一味追求「精致漂亮」。这些是你关心的,但用户关心的是产品是否满足他们的需要,以及为此付出什么代价。
一个既不完整也不漂亮的产品同样可能非常成功,因为它精准解决了核心痛点。早期 Google Docs 就是例子:相比 Microsoft Office,它功能只是子集、界面笨拙,明显是「次品」;但它抓住了协作和版本同步这两个关键痛点,且价格便宜得多——仅凭这一点,就足以颠覆一个被 Office 主导了几十年的市场。
轻视营销与分发
这一点在 B2C 尤其明显,在 B2B 同样成立。「只要做出来人们就会来」很少奏效。你今天在用的所有成功产品,既因为产品本身好,也因为它们解决了分发、营销、定价等一整套问题。
为技术而技术
AI 只是最新的例子;在它之前还有 Web3、区块链、VR、AR、助手等一长串「先有解决方案、再去找问题」的想法。正确顺序永远是:先定目标——这项技术打算达成什么——再从目标倒推路径。
GIST 框架:把证据驱动开发落到四个关键动作
GIST = Goals(目标)、Ideas(想法)、Steps(步骤)、Tasks(任务)。核心逻辑很简单:产品组织要在四个关键领域改变工作方式,才能真正转向证据驱动的开发。
设定目标(Goals)
要结果而不是产出,在业务目标与用户价值目标之间取得平衡,并建立指标层级、OKR 等体系。
评估想法(Ideas,即优先级排序)
不要再靠意见、共识或排名来挑想法,而要把影响、成本、可用证据(也就是置信度)纳入考虑。
用 Steps 验证想法
GIST 中的一个 Step,指任何用于验证想法底层假设的活动或短期项目——业内通常称之为「实验」。
任务管理(Tasks)
这一层已有敏捷开发和看板工具,不需要发明新的项目管理体系,关键在于把任务与 Step、Idea、Goal 建立连接。推荐使用 GIST board 来做这件事。
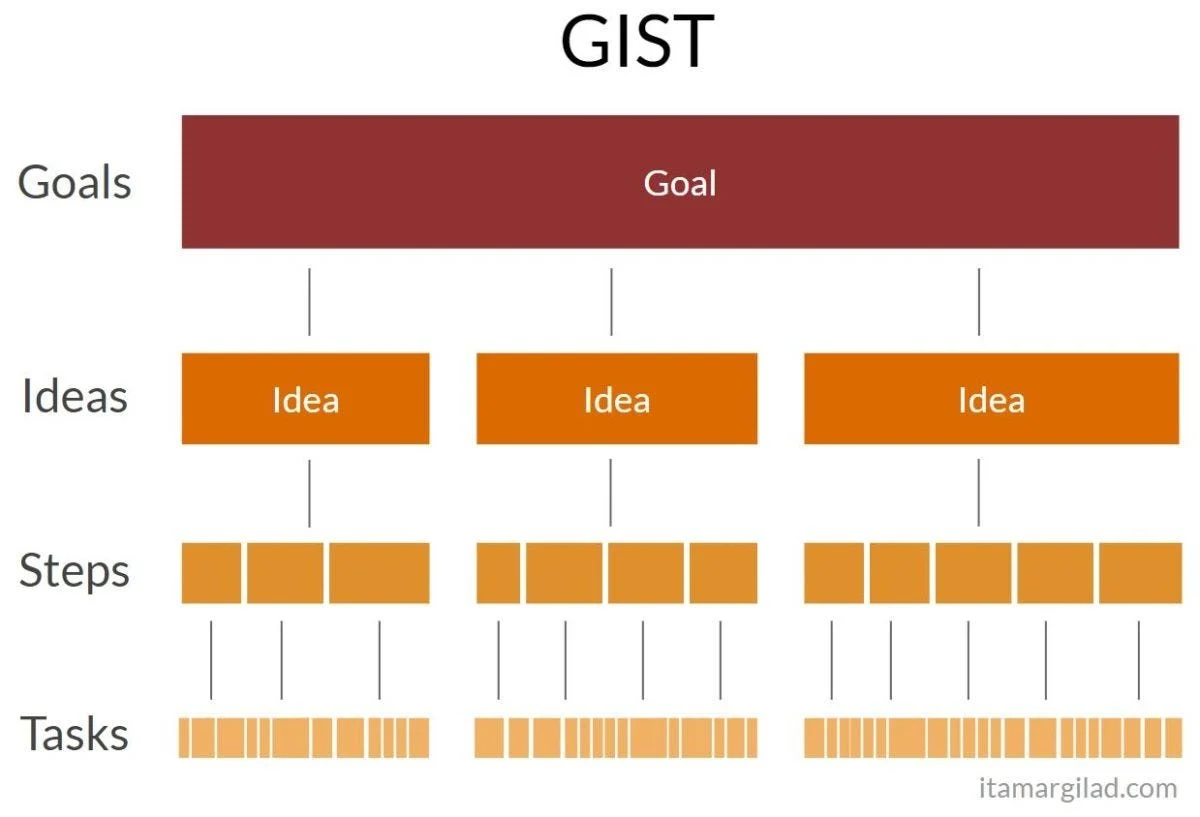
GIST 的完整说明(含示例与落地指南)收录在我的书 Evidence-Guided 中,该书聚焦于下图所示的现代产品开发生命周期的落地采用。
独立开发者的精简版 GIST
一个人做产品时,四部分依然必要,只是可以更轻量。实践方式:
- 用 Airtable 以 OKR 形式设定年度与季度目标;
- 使用这份 idea bank 模板(免费下载)来管理想法库;
- 在 Cursor 或 ChatGPT Work 中设计、规划并分析实验(多数是用户访谈、早期用户计划),每个实验单独一个目录,内含 Markdown 文件;
- 完全不使用敏捷流程。
没有正式职权的人,最小第一步是什么?
最小的一步是:先把团队里的其他人带进来,尤其是 PM 和设计师。
这件事一个人做不成,必须有人愿意认同(buy-in)。之后还需要说服管理者,给出试验这套做法的自由空间。关键在于——你不必整套采纳这个体系,可以从一个 Step 开始试。
核心变化与落地建议
核心变化:AI 把「写代码」变便宜,但没有降低「验证」的总成本,反而放大了坏想法上线、错失机会,以及无法归因学习这三类代价。
影响与建议:
- 用置信度而非「验证/不验证」的二元判断:为每个假设标注证据类型与置信度水平,市场数据也不应超过 3/10;是否达到「足够好」由想法的成本与风险决定。
- 把 AI 用在更快抵达高置信度测试上,而不是用来跳过验证——跳过验证等于在全体用户身上做实验。
- 让 AI 编码的真实成本显性化,包括验证、维护与安全成本,不要假设「开发已经被大幅加速」。
- 在组织层面先做减法再谈体系:不追求功能完整和视觉完美,优先打穿核心痛点并保持成本可控。
- 对没有职权的人:先拉 PM 与设计师入伙,再争取管理层的试验授权,以单个 Step 为最小落地单元推进。
在产品发现(Product Discovery)这件事上,AI 到底能替代什么、不能替代什么?在前面的对话中,Milan(产品发现顾问、《产品发现的艺术》作者)给出了一套相当克制的判断:AI 是研究、实验准备和结果分析的加速器,但不是用户的替身。而在组织落地层面,他更看重的是“用一次工作坊把跨职能负责人、他们的管理者和关键干系人放在同一个房间里”,以及用可量化的指标去验证产品组织是否真的在进步。
下面这组问答,是这次对话中关于衡量、信任边界和工作方式的部分。
如何判断产品发现是否真的在起作用
他给出的思路是设定“采纳层面的元目标”(meta-goals),并用具体指标跟踪,例如每季度测试的想法数量、达到“中等信心(medium confidence)”以上的上线占比。
在书中第 9 章,他列出了几条建议的进度指标:
- 每季度评估的想法总数(至少结合 ICE 打分与目标对齐)
- 每季度实际测试的想法数量
- 产生了学习价值的步骤占比——即能据此对想法重新打分,或基于收集到的证据得出有用洞察
- 至少以“中等信心”水平上线的想法占比(依据 Confidence Meter)
- 已发布并带来可测量结果改善的想法占比
用 AI 做“研究”时,信心该怎么打分
AI 在产品发现中的价值,他认为是相当高的:可以分析定性与定量研究数据、做网络调研、设计并准备实验、分析实验结果、帮助更好地传达结论。
但有一条明确红线:AI 不能模拟用户,也不能在测试中替代用户。在看到能证明相反情况的证据之前,他的建议是不要这样用。
AI 强在哪、哪些场景不该被信任
他指出,AI 目前并没有带来新的测试类型(唯一“新”的算是 AI 模拟用户,而他不认可)。在已有的验证方法体系里,AI 几乎在测试准备和结果分析两端都能帮上忙;但真正由 AI 亲自执行的测试要少得多——比如可用性测试或 A/B 测试,他并不放心交给 AI。
出问题通常出在三个地方:
- AI 对产品、公司和用户缺乏足够上下文
- 没有被正确提示,导致测试本身设计失当
- 结果解读被过度信任
第三点最为关键:AI 很容易基于小样本得出过于宽泛的结论。他的做法是要求 AI 明确说明它所依据的证据,并给结论标注信心水平,这有助于让模型在校准上表现得更“科学”一些。幻觉依然存在,但按他的经验已经比以前少了很多。
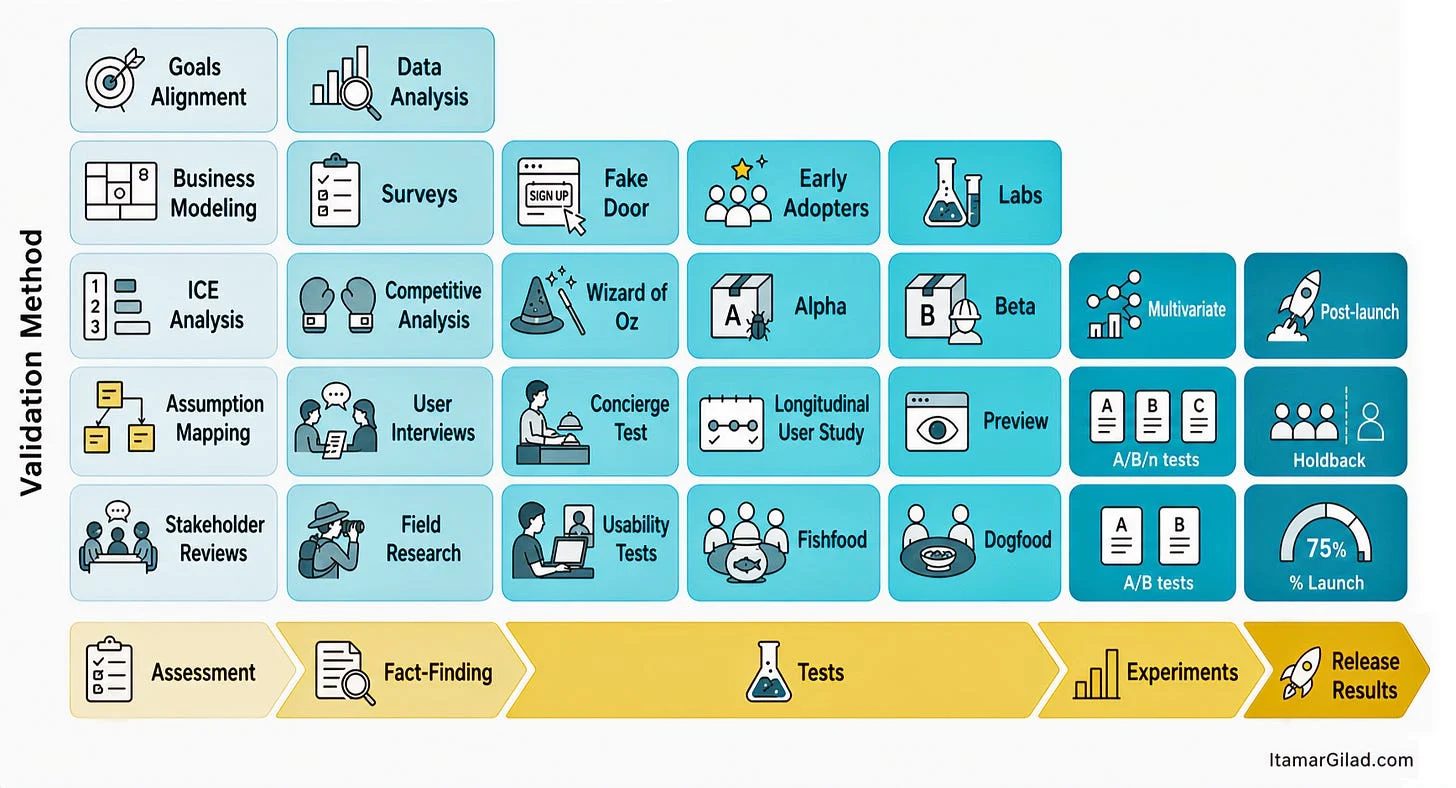
AI 如何改变了咨询者自己的工作流
他现在开设“精益产品管理 + AI”“更好的 OKR + AI”等工作坊,他自己的研发方式也随之改变。作为不写代码、但为产品团队开发方法论工具(模板、工作坊、模型)的人,他的日常用法包括:
- 给想法当回音板:选当前最强的模型,让它挑战自己的想法、反问问题,或对方案做增删修改
- 把新概念可视化
- 调研:视主题而定,AI 有时很有帮助,有时很让人沮丧;他通常不信任其分析结论,倾向于亲自读原始资料——“AI 在这方面仍然会把很多东西搞错,并给出基于极少数据的宽泛结论”
- 访谈中记笔记并做总结:这一项 AI 表现优秀
- 以及更多他自己一时想不起来、但已成为工作流不可分割一部分的用法
给工程师的一个可立即开始的习惯
他给出的建议不是学某个工具,而是从这周开始,每做一个决定就问自己这六个问题:
- 目标:我们为什么要做这件事?目标是什么?
- 研究:我们怎么知道这个说法成立?
- 想法:这个想法对我们要追求的目标有什么潜在影响?支撑它的证据是什么?
- 假设:要让这个想法成立,必须有什么为真?
- 验证:最快能验证我们假设的方式是什么?
- 任务:如何调整敏捷流程来支撑产品发现?
延伸阅读
- Itamar Gilad 官方页面
- 证据引导:在不确定性中打造高影响力产品
- 资源页面
- 最大的杠杆
- The Laws of Software Engineering(作者著作) —— 56 条覆盖架构、人员、时间、质量、规模、代码与决策的法则,每章说明法则内容、出处、适用场景以及在真实项目中的样子,已售出 1,500 余册。
评论