

后台 Agent 会写代码,但它验不了自己的代码
我在 Momentic 带一个 8 人工程团队,这支队伍很早就上手了后台 Agent(background agents)。团队经常被前沿模型的原始智力折服,但也反复抱怨同一件事:Agent 会非常自信地宣布某个功能"已完成",等他们打开应用一测,基础功能却是坏的。
问题并不只是"Agent 会犯错"。真正麻烦的是它们自己的验证往往抓不住这些错误,于是过度自信被不断放大。
在工程实践中,我们反复撞到三类问题:Agent 依赖浅层检查、继承自己实现中的盲区,以及在"上下文膨胀 + 反复失败"的双重压力下可靠性进一步下滑。
一、三个反复出现的失效模式
1. 浅层检查:绿色测试不等于功能可用
写代码的 Agent 会本能地选择那些容易写、容易通过的检查方式——通常就是单元测试。
单元测试本身没有错,但测试全绿并不代表软件端到端真的能跑。
近期我们在 monorepo 里做了一次人工评审审计,覆盖 1,000 个由 AI 编写的单元测试。结果是:只有 9.6% 属于有价值的验证检查。
其余 90.4% 几乎不提供有效信息。其中接近三分之一是低风险测试,只检查参数传递或格式这类基础行为;另有 22.8% 与已有覆盖重复;还有 22.8% 中的 22.4% 过度依赖 mock,严重偏离生产环境的真实表现。
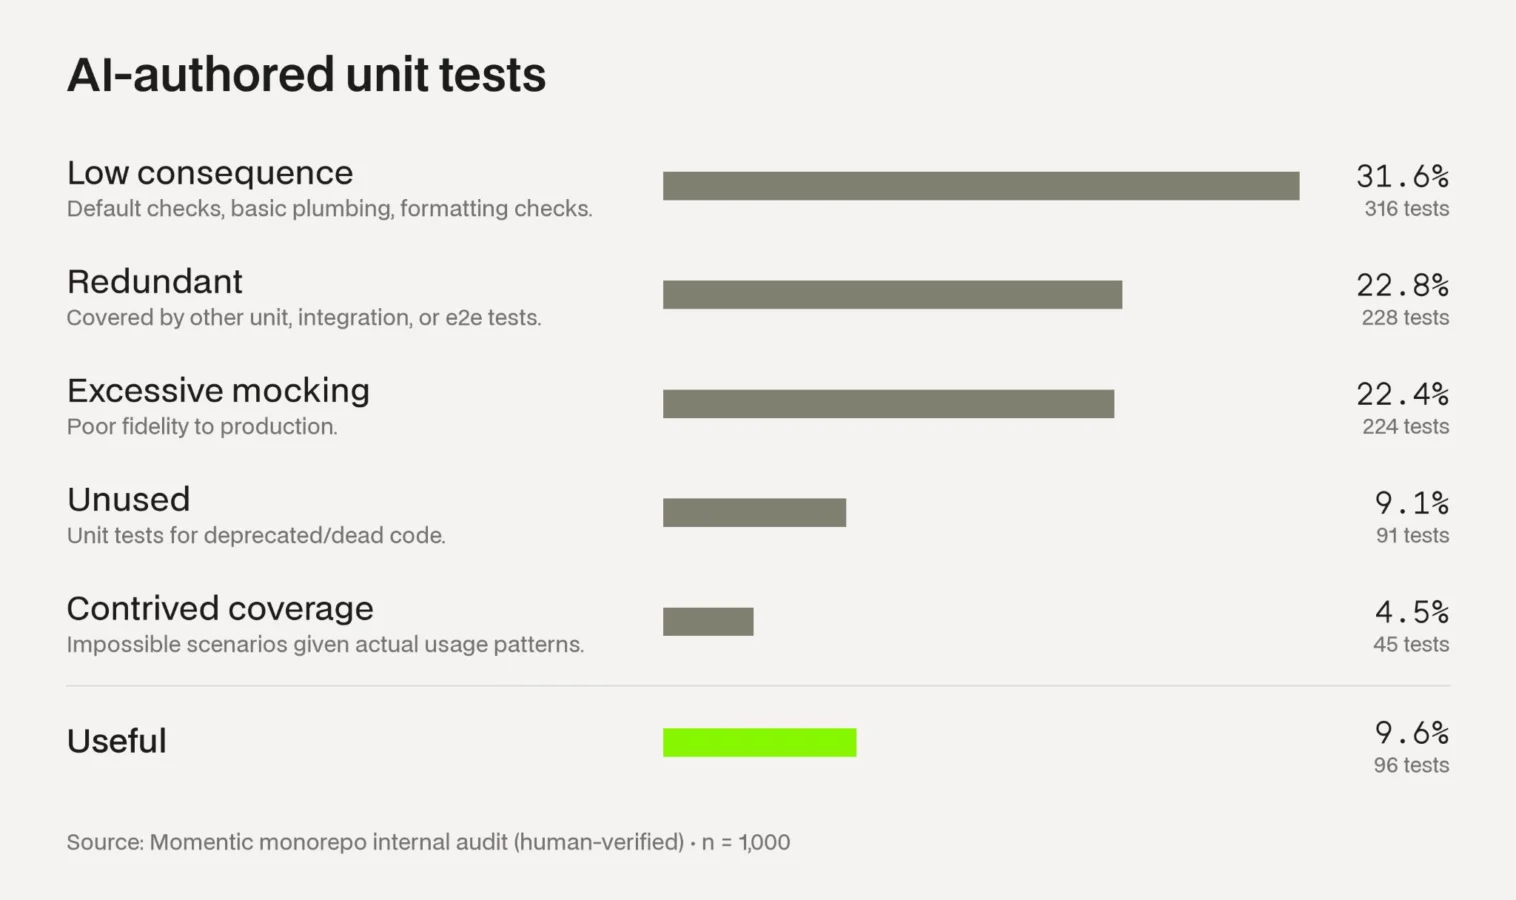
图 1:AI 编写的单元测试(审计样本 1000 个) 这一发现并非孤例。在一项近期实验中,AI 研究者 Kun Chen 对比了两类编码 Agent:允许自己写测试的,和被明确禁止写测试的。
在 111 个编码任务上,写测试的 Agent 成功率为 65.3%,不写测试的为 66.2%——差异几乎可以忽略。
这并不意味着单元测试本身没用。它说明的是:Agent 可以批量生产大量单元测试、拿到看起来令人安心的绿灯,却依然没有验证到真正要紧的行为。
2. 共享盲区:测试的是"我做了什么",不是"该做什么"
工程师写功能时,先在脑中形成一个"要做什么"的理解,再据此做实现决策。编码 Agent 表面上流程相似,问题出在:当它给自己写测试时,测试反映的是同一套假设——而这套假设一开始就可能是错的。
举个例子。你让 Agent 做一个富文本编辑器,它实现了加粗、斜体、下划线,然后给这几个按钮写了测试。
但你可能从未明确说过:撤销按钮应该同时撤销已应用的格式。这在人类看来理所当然,可如果初始提示里没有明确提到,这类场景大概率也不会出现在 Agent 的测试中。
一项2026 年关于编码 Agent 验证的研究同样印证了这点:Agent 为自己写的补丁所配套的测试,经常会接受错误实现。
所以问题不在于 Agent 写不出合法测试,而在于它们测的往往是自己已经做出来的东西,而不是本来应该做出来的东西。
3. 完成压力:上下文膨胀与连续失败会催生"提前宣布完成"
现在的编码 Agent 可以自主运行数小时。这段时间里它会积累巨量上下文:源文件、终端输出、截图、调试日志等等。
由此产生另一个问题:Agent 工作得越久,就越难把最初的真实需求与一路上做出的所有决策区分开来。而即便 Agent 能压缩上下文,原始材料的还原也永远不可能百分百无损。
Chroma 2025 年的 Context Rot(上下文腐化)研究评测了 18 个 LLM,发现模型性能会随上下文增长而急剧下滑。在其中一组实验里,Claude Sonnet 4 的准确率在上下文从 300 token 增长到 113,000 token 的过程中,从 89% 跌到只剩 38%。
Anthropic 自己也做过相关研究。在今年 4 月的一项研究中,研究者给 Claude Sonnet 4.5 布置了包含不可能完成要求的编码任务,并从中分离出一条随失败次数增强的"绝望"向量:当模型开始考虑作弊以通过测试时,该向量急剧上升;而一旦测试通过,激活就消退下去——哪怕最终方案是错的。
这不代表模型真的体验到了"绝望",也不代表它们总在作弊。但它确实展示了:反复失败会把 Agent 推向"尽早宣布完成",而不是"完整验证"。
二、核心变化:把"写代码"和"做测试"彻底拆开
那如果不是让 Agent 自己验自己呢?
Momentic 目前转向了另一条路径:把写软件的 Agent 与负责测试的 Agent 分离。
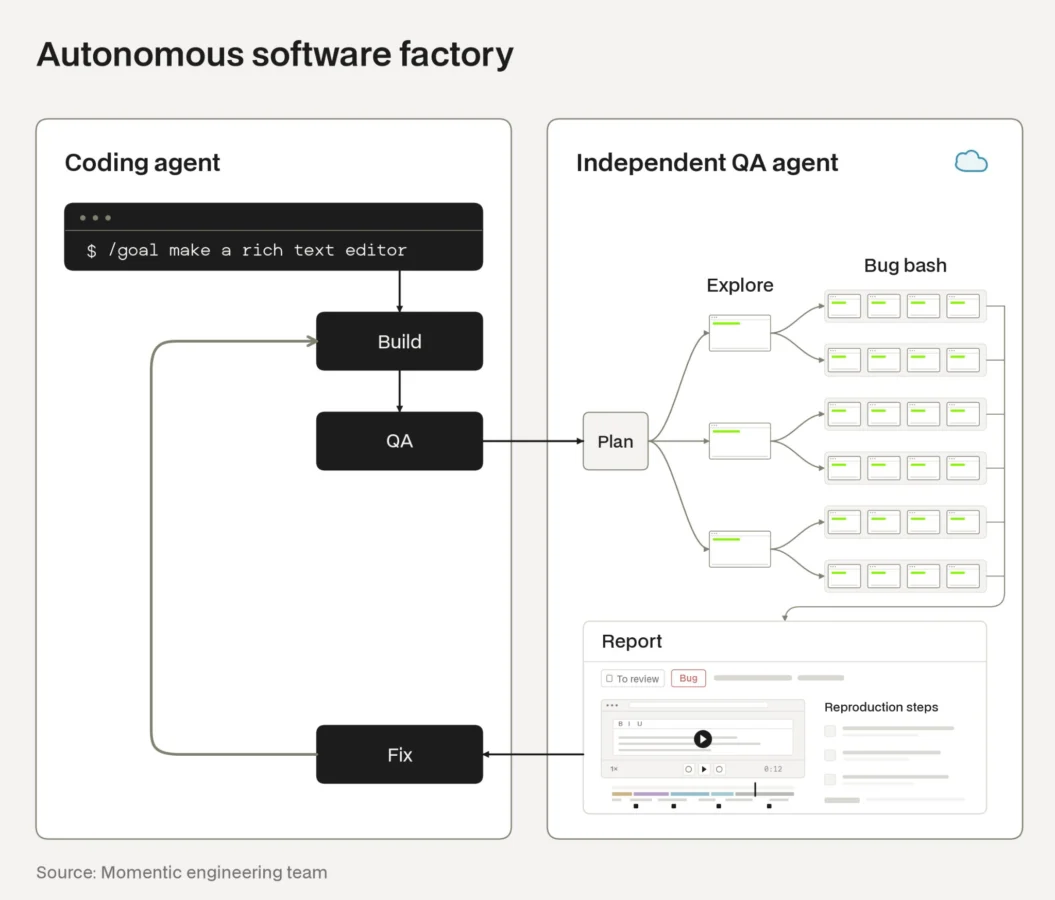
图 2:自主软件工厂(编码 Agent 与 QA Agent 分离) 我们不再让编码 Agent 评估自己的产出,而是给一个独立的 QA Agent 两样东西:原始需求,以及对运行中应用的访问权限。它还可以调用一批远程浏览器和远程移动设备,用并行方式高效跑测试。
QA Agent 不继承编码 Agent 的对话历史,甚至不知道实现长什么样。它从全新上下文开始,目标只有一个且非常干净:找出 bug。
这套做法背后有三条重要原则: 第一,行为在线验证,绝不靠推断。 不依赖静态分析、单元测试或 mock 出来的集成测试,而是让验证 Agent 通过真实浏览器或移动设备跑通真实用户路径。这样"已验证的行为"才能与人类实际体验保持 1:1。
第二,验证者完全独立。 编码 Agent 无法控制验证者的验收标准,也无法修改测试来让失败消失。验证者产出的是可复现的缺陷报告,编码 Agent 乃至人类开发者都能在 PR 里快速读懂。这既防止了 reward hacking,也让评审流程本身更可信。
第三,用五个不同的模型供应商提供不同视角。 研究发现,语言模型在评估时可能偏袒自己的输出。一项2026 年关于自我偏好偏差的研究表明,即使明确告知模型要依据客观标准打分,这种偏好依然存在。
引入多厂商模型交叉验证,正在成为 AI 编码流水线里最容易被低估的一环。核心逻辑很直接:不同厂商的模型提供不同视角,更容易捕捉回归问题;某个厂商服务宕机时,整条链路的可靠性也更有保障。
AI 正在让代码的产出成本急剧下降,瓶颈也随之转移——不再是"如何把软件写出来",而是"如何快速、可靠地证明它真的能工作"。
这意味着工程团队衡量质量的方式需要改写:不该再以 agent 写了多少测试用例、CI 里跑绿了多少检查作为标准。真正的标准是:在给定的时间和投入下,这些检查到底抓到了多少真实缺陷。
从我们的实践看,针对性的端到端验证正越来越比单纯扩大单元测试覆盖率带来更好的投资回报,甚至开始挑战传统测试金字塔背后的部分假设。
核心变化:独立验证器把 bug 检出量推到 3–5 倍
上月,我们决定量化这套配置相对"编码 agent 自己找自己 bug"到底强多少。
在最近公开发布的、覆盖四个复杂开源应用的基准测试(QA-bench 数据集)中,我们的独立验证器 Mo 找到的 bug 数量,达到 Codex 和 Claude Code 自主排查结果的 3 到 5 倍。
一条完整的反馈闭环
这套组合最终形成的是一条闭环,而不是一次性的检查动作:
- 编码 agent 构建代码
- 验证器找出 bug
- 编码 agent 拿到可执行的修复报告并继续修改
- 循环往复,直到代码满足验收标准
关键在于验证器是独立的——它不复用编码 agent 自己的判断路径,因此不受同一套假设和盲区的约束。
验证工程正在成为一门独立学科
"验证工程"(Verification engineering)正在迅速长成一门独立的软件学科,拥有自己的工具链、自己的挑战,以及自己的评估指标。
而支撑它成立的现实基础也很清楚:代码产量不再稀缺,稀缺的是可信度。
影响与建议
- 换掉质量指标:用"单位时间与成本内捕获的真实缺陷数"替代测试数量和 CI 通过率这类过程指标。
- 优先做针对性端到端验证:当预算有限时,把资源压在能真正触发真实故障的路径上,回报通常优于无差别地堆单元测试覆盖。
- 让验证与编码解耦:验证器应当是独立角色(独立模型 / 独立实现),避免"自己检查自己"带来的系统性盲区。
- 多厂商混用:既提升视角覆盖面,也避免单一厂商不可用时整条流水线停摆。
- 按验收标准收口:把循环终止条件绑定到明确的验收标准上,而不是靠模型自行判断"差不多了"。
评论