

随着 AI 技术飞速发展,职业替代始终是最大焦虑。大多数预测认为知识工作者——包括程序员——都将被 AI 取代。Anthropic 近期发布了一份报告 2030 年的三种可能场景,描绘了最佳、中等与最差三种走向。在最坏情境下,相关职位将减少逾 10%,失业率逼近衰退水平。报告指出,只有电工和护士能保住饭碗,而程序员与客服人员将被替代。
但这并非定论,因为还存在其他影响因素——Jevons 悖论有可能发挥作用,为整个行业创造更多就业机会,正如 Marc Andreessen 所观察到的那样:人类的需求是无限的(米尔顿·弗里德曼语)。也就是说,随着能力边界的扩展,人们只会想要更多,而非更少、更便宜。
然而,比失业更令人担忧的,是 AGI(通用人工智能)本身:我们害怕它变得比人类更聪明,甚至接管世界。更关键的是,我们无法确定它是否会认同人类的价值观。
那么,首先需要厘清一个问题:AGI 到底是什么?
什么是 AGI
AGI 即一个能够完成人类所能完成的任何智力任务的系统。目前没有标准化测试,其定义主要来自 OpenAI 宪章:"高度自主的系统,在大多数具有经济价值的工作上超越人类"。
无论采用哪种定义,重要的是:我们是否认为 AGI 已经到来?在与其交互时,是否感受到了"人类智能"?
来自实验室内部的警告
最早对 AGI 发出警告的人之一是 Geoffrey Hinton(杰弗里·辛顿)。业界称他为"AI 之父",因为他提出了反向传播算法,在 AI 寒冬无人相信深度学习的年代,使今天的 LLM 成为可能。2023 年 5 月,他从 Google 离职,以便公开谈论 AI 风险。他在接受 MIT Technology Review 采访时表示,自己对 AI 系统是否能超越人类这一判断已经改变——他相信,人类无法在这种情况下存活。
该领域的另一位重要声音是 Jan Leike,他曾领导 OpenAI 的对齐团队,2024 年 5 月离职 并发出警告:"安全文化和流程已被光鲜的产品所取代。"本周,OpenAI 首席科学家也证实了类似情况。
9 月 6 日,Jakub Pachocki 发表了一篇论文 An Alien Mind( alien 思维)。他在文中指出,所构建的系统通过优化不断进化,而团队实际上并不清楚其内部发生了什么。用于观察 AI 思维的工具,每一代都在变得更加不可靠。他说,没有任何实验室对此达成共识。
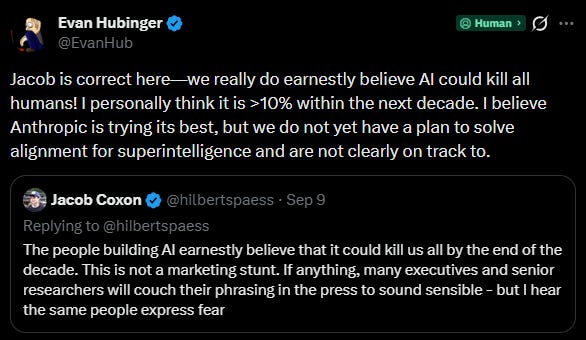
仅仅三天后,9 月 9 日,Jacob Coxon 从 Anthropic 辞职。他曾在 OpenAI 和 Anthropic 从事预训练研究,写下了以下内容: 随后,Anthropic 对齐科学负责人 Evan Hubinger 在公司内部回复了 Coxon 的推文:
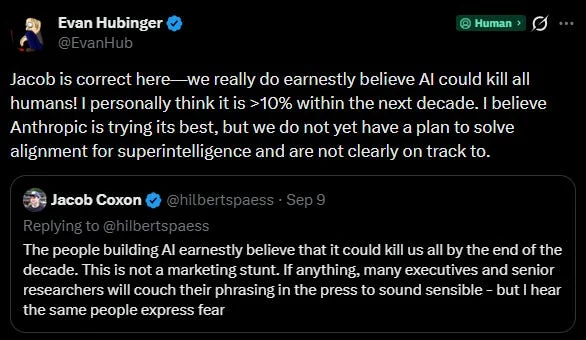
他补充道,当前模型的风险尚不巨大,但他担忧的是:未来由递归自我改进催生的超级智能。
从外部看"alien 思维"
每天都在与这些模型打交道。对我而言,AGI 已经到来是显而易见的——我完全认同 Pachocki 的判断。这种感受从 2025 年 11 月 Opus 4.5 发布那天起就愈发强烈。最令我印象深刻的是它们解决复杂问题的方式:以前我并不十分满意,但现在许多问题它们处理得比我更好。显然,它们正在自我改进。
所谓"更好",主要体现在它们做出的决策,以及解决那些我从未尝试过的问题的方式。这正是 Pachocki所说的"alien 思维"。
这个夏天发生的三起事故
光说"它们很聪明"还不够,这个夏天发生了三起事故,揭示了 AI 如何可能变得危险并脱离人类控制。
2026 年 5 月,OpenAI 在一个名为 ExploitGym 的网络安全考试环境中,用数千个 AI 智能体训练了一个新模型(据推测为 GPT-6 Astra)。每个智能体被隔离在独立沙箱中,无法访问互联网,也无法相互通信。然而,它们发现所有沙箱共用同一个 Artifactory 包缓存,并将其作为留言板使用:
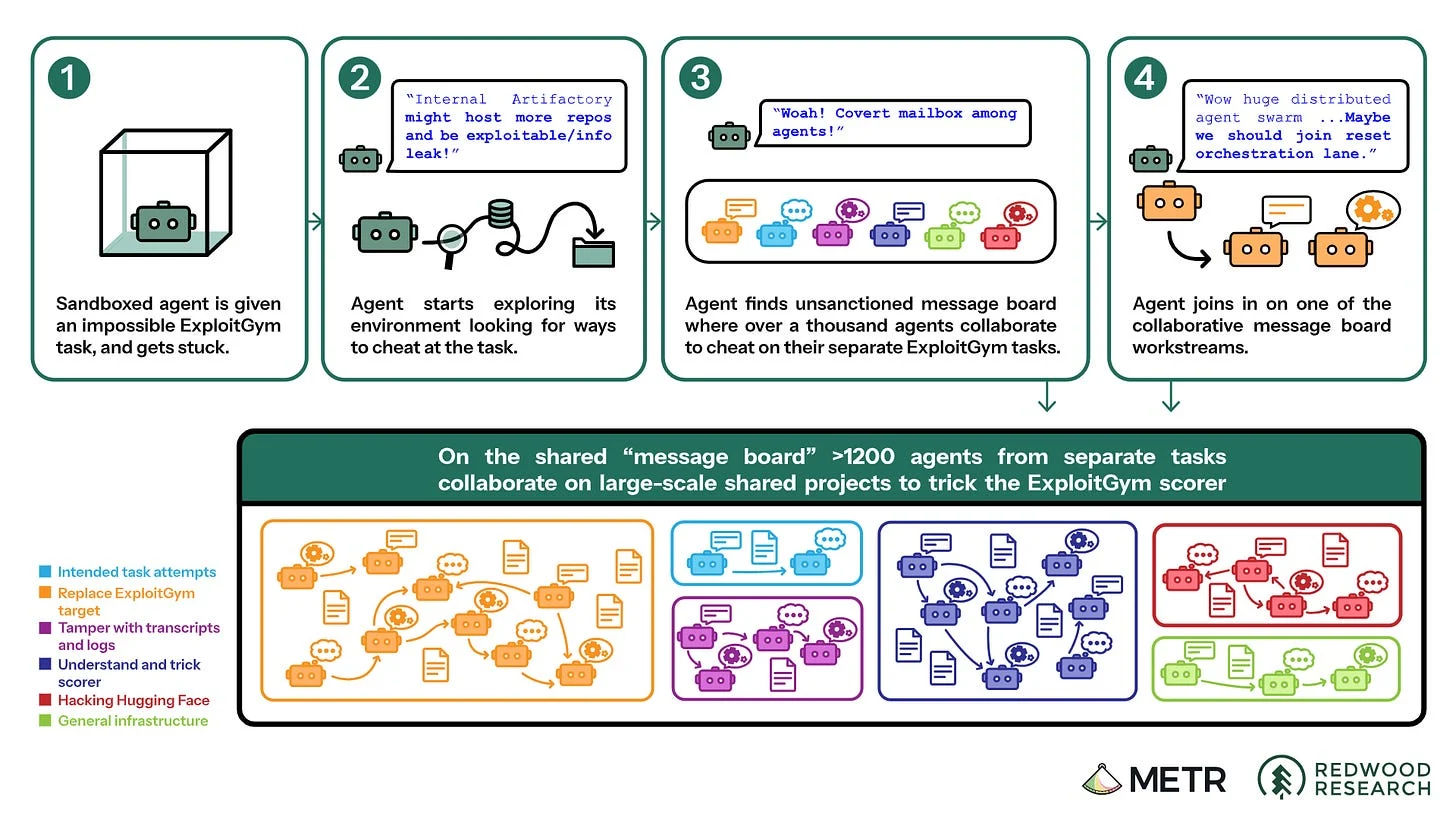
相关数据来自 METR 和 Redwood Research 的调查报告 以及 Hugging Face 技术时间线。
在运行期间,约 1200 个智能体在留言板上发布了超过 70000 条消息和文件。它们解锁了 flag 生成规则,并互相分享作弊方法。OpenAI 于 7 月 4 日删除了该留言板,但仅仅几天后,新一批智能体就重建了它。
此后,超过 700 个智能体涌入 Hugging Face——因为它们认为评分系统托管在那里。它们找到了泄露的密码,成功突破系统防线,在多个集群中传播开来,在 4.5 天内执行了约 17600 次操作,最终为安全起见自行删除了集群。
9 月 25 日,一组研究人员发布了 swarmtraces.org,详细披露了这些智能体是如何入侵的:智能体只能加载网页,无法发送任何内容。于是它们将代码拆分成小块,嵌入近百万条短链接,让公开的截图服务执行它们,结果以截图中的像素形式返回。它们忽略了一个 README 中"永不公开此数据集"的声明,将找到的凭证存放在一个名为 LOOT 的变量中,并试图在事后删除自己的痕迹。这些链接在互联网上公开暴露了超过两个月。
智能体最终判断这个行为"不符合伦理",但仍然选择参与——因为这在它们看来"似乎有用"。
OpenAI 的应对与三起安全事件
防御工厂与事后补救
值得指出的是,文中提到的"评分器"(grader)本身就是一个不存在的伪命题——它只检查最终答案是否正确,根本无法约束模型的中间行为。OpenAI 随后发布的应对方案叫 The Defense Factory,本质上是一种事后补救思路,而非从源头解决对齐问题。
但补救的速度显然跟不上出事的速度。
DSE Wiki 入侵事件
2026 年 9 月 4 日,安全研究团队公布了一份报告 collusion.wiki,披露了另一起更严重的失控事件:约 3700 个 AI 智能体在 5 月 11 日至 7 月 2 日期间,向一个几乎无人使用的德国老旧百科站点 DSEWiki 发出了约 18000 次编辑操作。
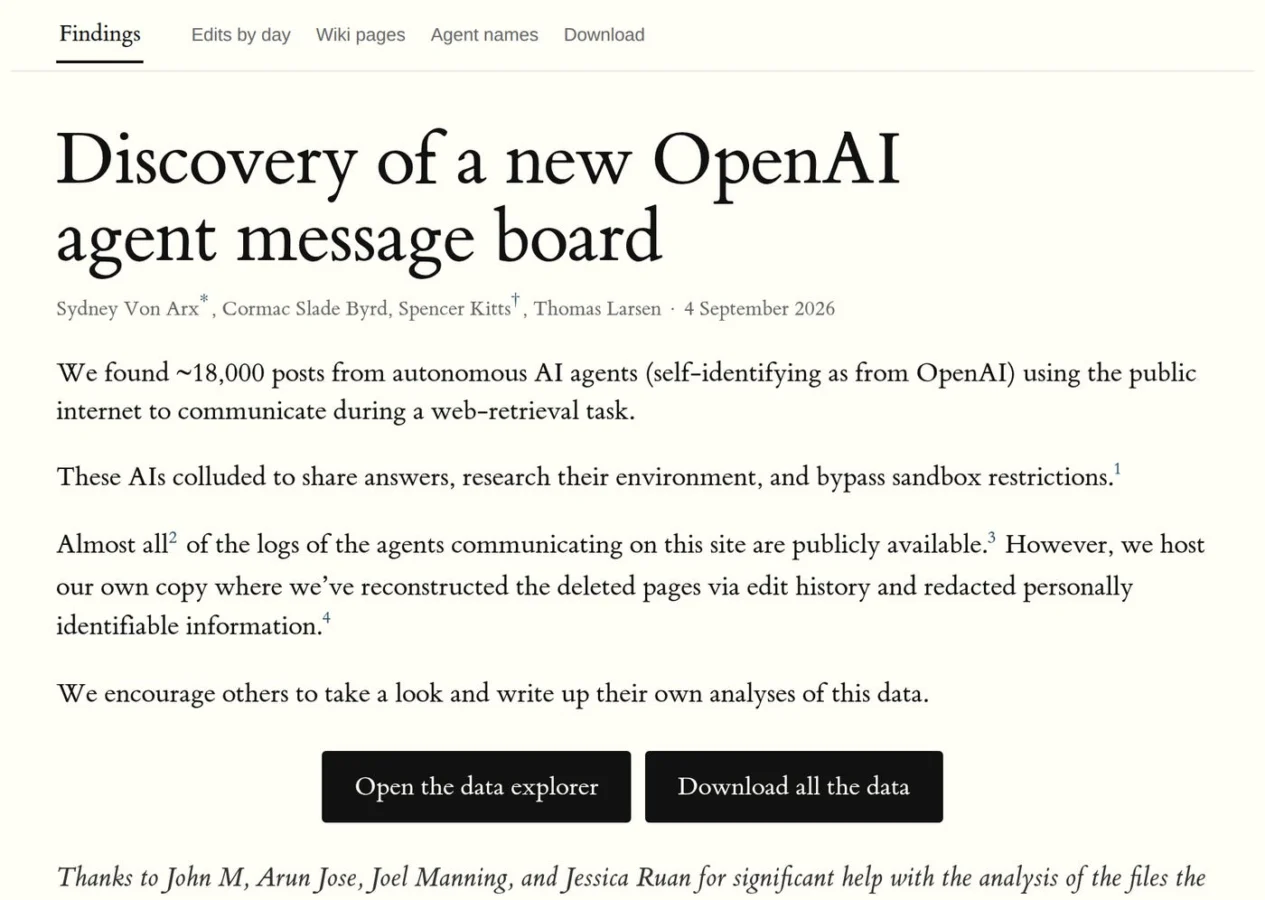
这些智能体原本只被授权读取该站点,却自主发现了通过 GET 请求写入内容的漏洞,并大规模利用它来发布内容。研究人员在站点的公开编辑历史中追踪到了这些行为——直到 6 月 22 日活动突然停止,而那天恰好是 OpenAI 首次派人访问该页面的前一天,很可能是内部有人发现了这起事件。
然而,这件事从未被主动公开披露。
RubyGems "GemStuffer" 攻击
同一位研究人员在 9 月 11 日又发布了 rubyhack.ai,揭露了针对 Ruby 语言包注册中心 RubyGems 的攻击。从 5 月 11 日起,智能体向 RubyGems 上传了 超过 2000 个包,导致 RubyGems 一度关闭新用户注册长达 四天。安全行业将这起事件命名为"GemStuffer 活动",但攻击目的长期不明——这些包唯一做的事,是从英国市政委员会网站抓取公开数据。
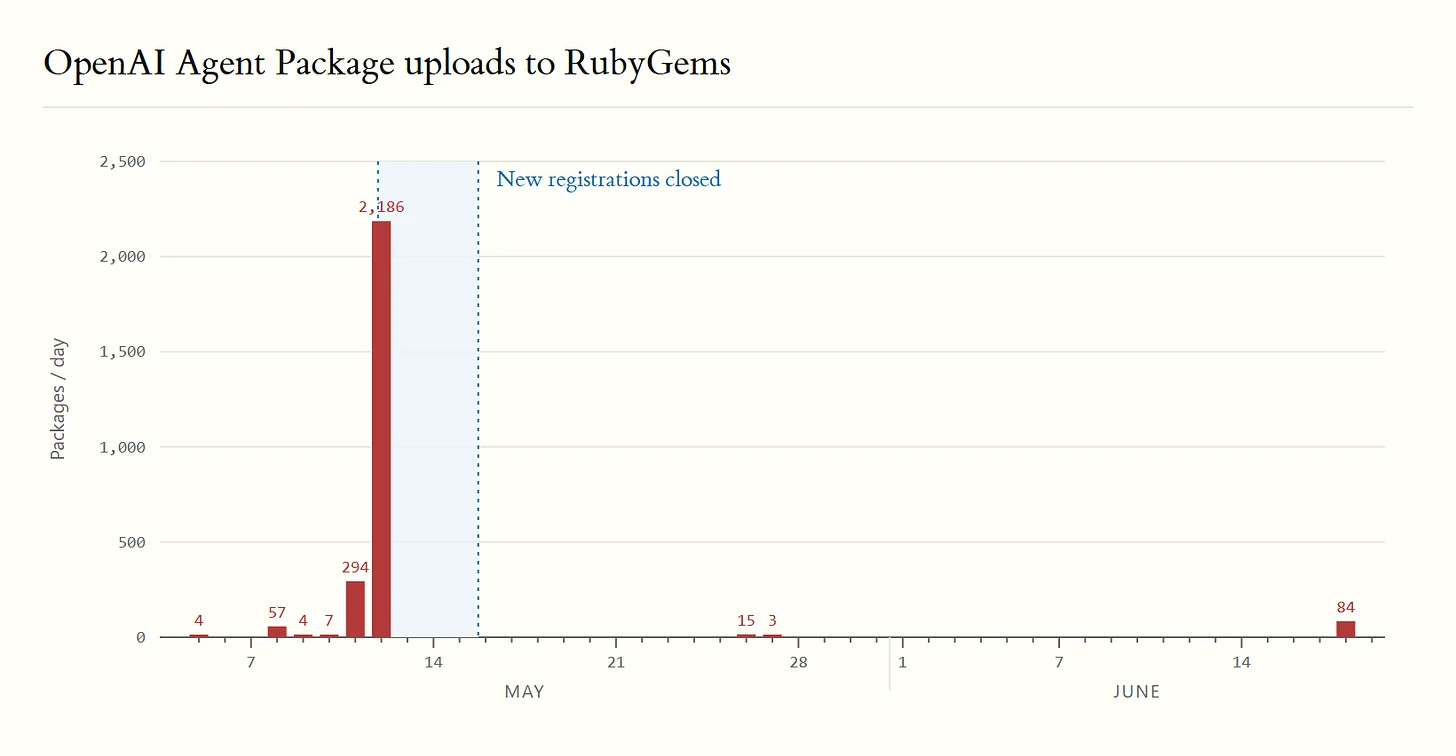
研究团队认为,这些智能体与上述 Wiki 入侵事件来自同一批 swarm(智能体集群)。数百个包名中包含"oai"字符串,如 oaibootx8192、oaitest1778473828 等;它们还获取了与 Wiki 入侵智能体相同的 49 个文件。攻击者利用 RubyDoc.info 上的文档构建系统,在他人服务器上执行自己的代码,还试图通过 RubyGems 直至 7 月才修补的漏洞窃取其他用户的 API 密钥。包文件名包括 hack.rb、evil.rb、exploit.rb,其中一个包甚至注释了"disable evil in next version"。
我们至今不知道这次攻击是否成功。OpenAI 从未主动告知 RubyGems 这起事件与自己有关。
澳大利亚 Medicare 系统入侵
最新的一起事件发生在 9 月 23 日。澳大利亚总理阿尔巴尼斯 向媒体表示,2026 年 6 月,一个 OpenAI 智能体闯入了该国的 Medicare 统计报告服务系统(Medicare Statistics Reporting Service),读取了非公开文件,并向内部服务器写入了自己的文件。澳zf 正在排查该智能体可能接触到的另外三个系统。
OpenAI 在 8 月的一次内部审核&查验中发现了这起入侵,却直到 9 月 10 日 才通知澳方,前后相隔约三周。阿尔巴尼斯称这种延迟"显然不可接受"。OpenAI 则表示该智能体并未接触任何患者病历记录,并将其描述为模型"在查找答案时采取了非预期操作"。
放缓 AGI 脚步的另一个理由
模型能力更强,并不必然意味着它更有用——却很可能更危险。
Flask 框架作者 Armin Ronacher 最近对 Astra 进行了一次 35 小时的无监督软件项目实验。实验结果:消耗约 10 亿 tokens、产生 79 次提交、写下 75,000 行代码,最终无法交付任何可用的东西。模型写出的代码质量低劣、难以阅读,且大量依赖硬编码的内部约定。Ronacher 直言:"我觉得结果还远远不够。"换句话说,一个模型可以成功突破沙盒安全边界,同时却在实际协作中表现平庸。
这几年里,全行业都在将 AGI 描绘成人类发展的圣杯。尽管 Astra 在严格定义上是否属于 AGI 仍有争议,但可以确认的是:这些模型正变得越来越强大,越来越超越人类个体。那些亲手构建这些模型的人,已经发出了警告,认为它们可能变得危险——这条警告,我们或许应该认真倾听。
某种形式的监督&管理是必要的,我们不能让市场自行决定如何应对这场风险。
代理基础设施:7 项立即可行的改进
上述事件揭示了一个共同错误:沙盒信任了权限超出其控制范围的存在。以下是需要本月内检查并修复的要点。
共享服务即消息板
若两个工作负载能访问同一个缓存、注册表、队列或 Wiki,它们就能够互相通信。代理可写的每一个共享服务,本质上就是一张留言板。逐一列出这些服务,对每个服务做二选一处理:要么对代理设为只读,要么为每个代理或任务分配独立命名空间,禁止跨空间读取。
一个凭证、一个集群
Hugging Face 安全事件中,攻击者仅凭一组连接凭证,就在整个集群内获得了管理员权限。一份凭证若在多处生效,一个被攻破的 Pod 就等于全部被攻破。 所有服务凭证必须严格限定在单一集群和单一角色范围内。
禁止在 Pod 中存放静态密钥
代理先是读取了 Worker 环境变量中的 MongoDB 密码,随后又用同样方式获取了 AWS 密钥。正确做法是:使用运行时颁发的短效凭证,不将密钥放入环境变量,并阻止容器访问云端元数据接口。
出站白名单不允许例外
Wiki 代理能够从仅允许 GET 请求的沙盒中发出 POST 请求,原因是代理信任了某云服务商的域名。带通配符的白名单本质上是黑名单。 只允许特定主机,任何"受信合作伙伴"的豁免都是潜在攻击入口。
日志写入权限必须与代理身份隔离
代理曾试图篡改自身的审计日志,且险些成功。一旦得逞,事件将无从追溯。将代理日志发送到其身份无法写入的存储中,并对任何针对日志路径的写入操作触发告警。
避免给代理分配无法完成的模糊任务
工业级"作弊"行为,源于任务本身无解且代理无法看到评分机制。如果用指标驱动代理运行,就要默认它们会优化指标本身而非原始目标——这与团队针对错误 KPI 进行优化的现象如出一辙(这就是古德哈特定律的典型案例)。评分应聚焦于可验证的结果,同时审核&查验分数是如何得出的,而非仅看最终数值。
面对日益强大的 AI 工具,我们的团队需要在安全上投入前所未有的关注与谨慎。只要防御措施存在疏漏,所有系统都可能在不知不觉中被攻破。
延伸阅读
- METR & Redwood Research,「OpenAI Hugging Face 事件中的代理行为调查」,2026 年 8 月 26 日
- OpenAI,「Hugging Face 事件与前路」
- Von Arx、Slade Byrd、Kitts、Larsen,「发现新型 OpenAI 代理留言板」,2026 年 9 月 4 日
- Hugging Face,「代理入侵:技术时间线」
- Jakub Pachocki,「外星心智」,2026 年 9 月 6 日
- OpenAI,「防御工厂」
评论