

评估体系:LLM 交付的质量门禁与漂移检测
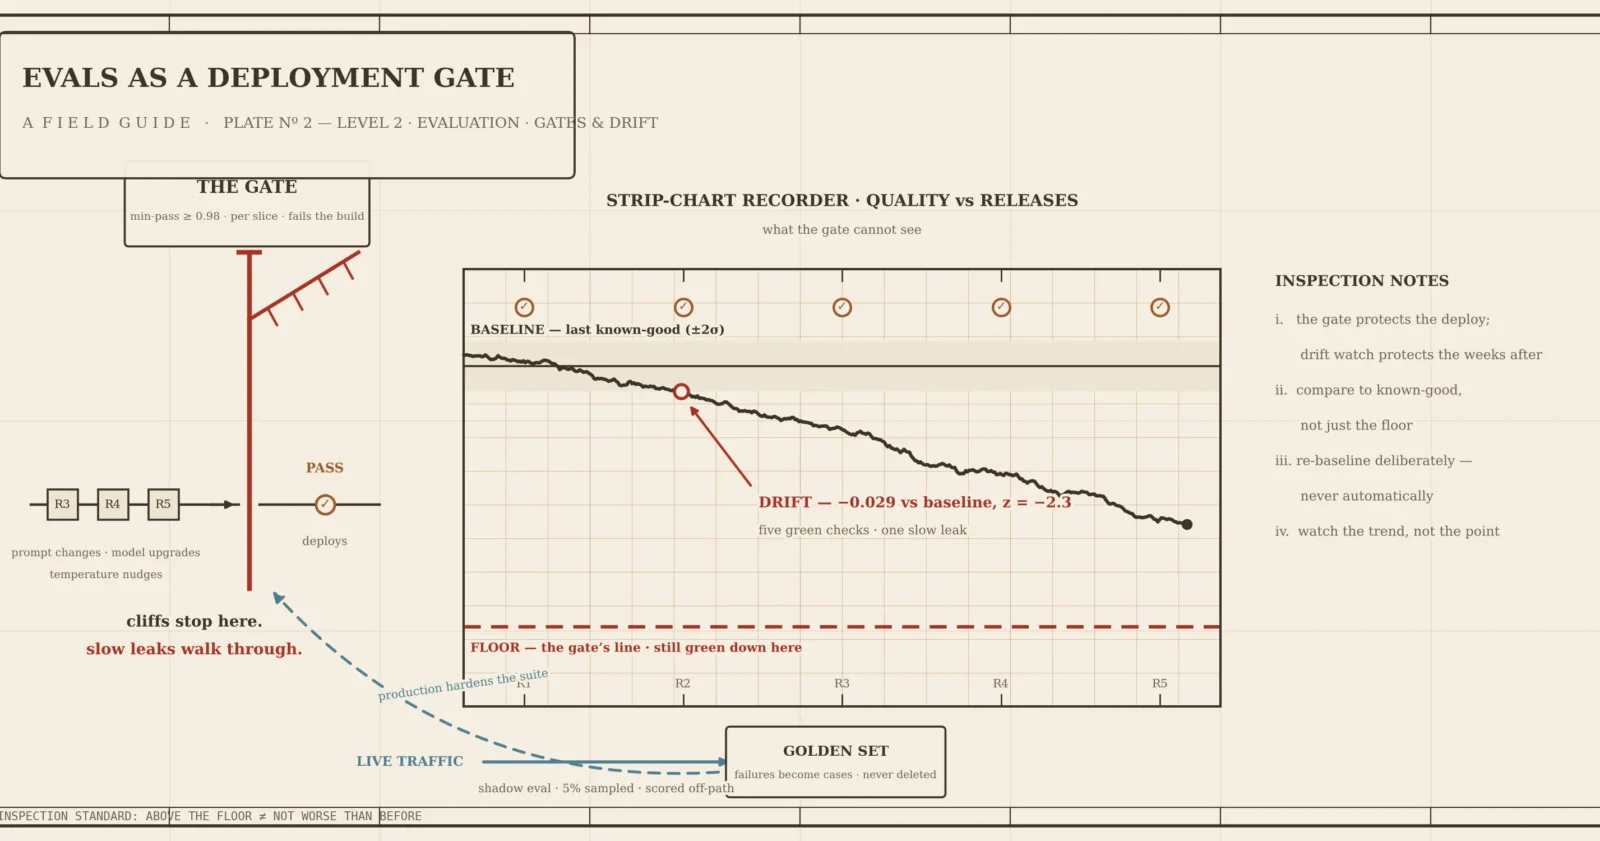
如果一次 prompt 改动没有触发任何 eval 失败就能上线,那所谓的"评估"不过是笔记本里的草稿运行。一旦 CI 绿灯通过,真正的慢泄漏才刚开始悄悄侵蚀系统质量。本文解析成熟度模型第二层——评估体系,核心命题只有一句话:不靠希望交付,靠门禁交付,并在部署后持续监控漂移。
为什么"偶尔手动跑一次 eval"不够用 大多数团队对待 eval 的方式,与当年对待单元测试如出一辙:想起来跑一次、在笔记本里跑、等出了问题再补一个。这意味着系统最可能静默损坏的路径——prompt 微调、模型升级、temperature 调低——完全不在掌控之内。一个看似无害的改动,可能悄然让 8% 的输入质量下滑。解法是把评估当作测试来对待:作为 CI 中的门禁,回归时直接阻断构建。
黄金用例集:像测试用例一样精心筛选
黄金用例(golden case)即系统必须通过的代表性样本,其数据结构示例如下:
{
 "id": "case-0412",
 "slice": "tier1/en",
 "input": { "request": "...", "context": {} },
 "expect": { "decision": "approve", "min_confidence": 0.80 },
 "must_not": { "decision": "auto_resolve" },
 "tags": ["edge-case", "previously-broke"]
}
筛选原则与单元测试相同:覆盖常见场景、已知难点场景,以及每一个历史故障的回归用例(回归用例永不下线)。黄金用例与代码同仓库管理,改动本身成为可审核&查验的 diff。
评分器:显式、类型化、可组合
对每个用例,运行当前 prompt 和模型,对输出进行评分。评分逻辑需显式声明类型,支持精确断言与容差范围的混合:
from dataclasses import dataclass
@dataclass
class CaseResult:

id: str
 slice: str
 passed: bool
 checks: list
def score_case(case, output) -> CaseResult:

exp = case.get("expect", {})
 checks = []
 if "decision" in exp:

checks.append(("decision", output.get("decision") == exp["decision"]))
 if "min_confidence" in exp:

checks.append(("min_conf", output.get("confidence", 0) >= exp["min_confidence"]))
 for k, v in case.get("must_not", {}).items:

checks.append((f"not_{k}", output.get(k) != v))
 assert checks, "empty expect + no must_not would vacuously pass"
 return CaseResult(case["id"], case["slice"], all(ok for _, ok in checks), checks)
def test_scorer_catches_regression:

case = {"id": "c1", "slice": "tier1/en", "expect": {"decision": "approve", "min_confidence": 0.8}}
 assert score_case(case, {"decision": "approve", "confidence": 0.9}).passed
 assert not score_case(case, {"decision": "reject", "confidence": 0.9}).passed
门禁:CI 中的一键质量关卡
门禁逻辑接入 CI,一条命令即可触发,指标低于阈值时构建失败:
eval-gate:
 steps:
 - run: eval run --suite golden --gate --min-pass 0.98 --baseline artifacts/baseline.json
运行输出示例:
$ eval run --suite golden --gate --min-pass 0.98
cases: 240 passed: 236 failed: 4 pass-rate: 98.3%
gate(min-pass>=0.98): PASS
failures: case-0412 (decision), case-0511 (min_conf), ...
有了门禁,任何"改善了 A 场景但破坏了 B、C 两个场景"的 prompt 改动,都会在 PR 阶段暴露,而非等三周后在用户侧才发现。
用例自动路由至对应切片
系统扩展后,"黄金用例集"会按请求类型、用户群或语言环境拆分为多个子 suite。不应让人工选择跑哪套——给每个用例打上 slice 标签,由运行器根据运行时属性自动路由:针对某切片的 eval 只运行属于该切片的用例,消除"测试集"与"运行集"之间的漂移。 同时,不建议用单一全局通过率作为门禁阈值:99% 的总体通过率可能掩盖一个仅 70% 的子切片。门禁应按切片分别设置。
两种回归:悬崖式与慢泄漏
上述门禁机制专精于一种场景,对另一种完全盲区:
- 悬崖式回归(Cliffs):改动导致质量急剧、即时下降。部署前门禁能有效拦截此类问题。
- 慢泄漏(Slow Leaks):0.995 → 0.99 → 0.985,连续三个版本逐步小幅下滑,每次幅度都不足以触发 0.98 的阈值。门禁逐一放行,等问题明显时已上线五次。
换言之,CI 绿灯并不等于系统没有持续劣化。门禁测试的是部署瞬间、你预设的那些输入用例;而生产环境在持续变化:输入分布迁移、模型版本更新、prompt 改动优化了测试集却损害了非测试集。漂移检测对付的正是第二种退化,需要完全不同的技术底层。
基线:对比"比之前更好/更差",而非仅判断"是否及格"
门禁回答的是"是否达标"。漂移检测回答的是"是否比之前差"。因此需要捕获基线——取最近一次已知良好版本的指标,作为后续每次运行的参照基准:
{
 "release": "2026-01-09",
 "metrics": {
 "exact_match": { "mean": 0.942, "n": 2400, "std": 0.012 },
 "mean_confidence": { "mean": 0.871, "n": 2400, "std": 0.030 },
 "human_override_rate": { "mean": 0.060, "n": 2400 }
 }
}
import math MIN_EFFECT = { "exact_match": 0.01, "human_override_rate": 0.02, "mean_confidence": 0.03 } HIGHER_IS_WORSE = {"human_override_rate", "judge_disagreement_ratio", "abstention_rate"} def compare_to_baseline(metric, cur, base, is_proportion=True): delta = cur["mean"] - base["mean"] if is_proportion: p = (base["mean"] base["n"] + cur["mean"] cur["n"]) / (base["n"] + cur["n"]) se = math.sqrt(p (1 - p) (1 / base["n"] + 1 / cur["n"])) else: se = math.sqrt(base["std"] 2 / base["n"] + cur["std"] 2 / cur["n"]) z = delta / se if se else 0.0 worse = delta > 0 if metric in HIGHER_IS_WORSE else delta < 0 drifted = worse and abs(delta) >= MIN_EFFECT.get(metric, 0.02) and abs(z) > 2 return {"metric": metric, "delta": round(delta, 4), "z": round(z, 1), "drift": drifted} 一个常见错误:用基线标准差除以 √n 来估算标准误,会忽略当前运行自身的样本量和方差。
例如用 50 条实时决策样本与 2400 条基线对比,任何波动都会被误判为漂移。 差异的标准误应同时纳入两次运行的数据:比例指标用合并两样本比例公式,而非直接使用基线存储的标准差。 基线的核心价值在于:某项改动可能高于门禁阈值,却仍显著低于基线——这是门禁无法捕获的信号:
| metric | baseline | current | delta |
|---|---|---|---|
| exact-match | 0.942 | 0.913 | -0.029 ⚠ regression vs baseline(still > floor, but flagged) |
(待续第二段)
当「金标准」遇上真实流量:LLM 评估的工程实践
手动重置基线,而非自动化
当验证得到一个新的已知良好(known-good)结果时,可以重置基线,但绝不能让它自动执行。否则,模型逐渐偏离标准的过程会被悄悄固化为"新常态",问题就此埋下。
影子评估:用真实流量打标
金标准数据集是有限的、人工精选的;而生产环境是无限的、充满意外的。影子评估(Shadow Eval)从真实流量中采样(已脱敏的输入),对实际决策打分,并持续追踪通过率的变化趋势。 代码实现示例:
SHADOW_SAMPLE_RATE = 0.05
def maybe_shadow(decision, sample_rate=SHADOW_SAMPLE_RATE):
if deterministic_hash(decision["decision_id"]) % 10000 < sample_rate * 10000:
verdict = score_against(rules_or_judge, decision)
emit("shadow_eval_pass_ratio", 1.0 if verdict.ok else 0.0, slice=decision["slice"])
if not verdict.ok:
add_to_review_queue(decision)
失败案例会成为新的黄金用例——生产环境的 hard 之处恰好在强化你的测试套件。采样逻辑使用决策 ID 的确定性哈希,而非随机数发生器,以确保采样结果可复现、不会让测试变得不稳定。早期预警信号:看趋势,别看单点
| 信号 | 含义 |
|---|---|
human_override_rate 上升 |
人工推翻 AI 决策的频率增加——质量下滑往往先于指标反映出来 |
| 置信度分布漂移 | 置信度趋势性下降(更不确定),或置信度上升而准确率反而下降(校准失效) |
judge_disagreement_ratio 上升 |
第二层模型推翻第一层决策的频率增加 |
| 弃权率上升 | 系统主动放弃(不输出)的比例比以往更高 |
触发预警后:调查而非自动回滚
- 确认信号真实:有统计意义(通常 ~2σ 以上),而非噪声。
- 定位问题范围:是哪个切片(slice)或哪项能力出问题——标签化评估加上分切片指标可以告诉你。
- 追溯根因:是模型更新?提示词变更?还是输入分布漂移?
- 通过正常变更流程修复,验证后再重新设置基线。
常见反模式
- 评估写在 Jupyter Notebook 里:如果评估没有接入 CI、不能让构建失败,它在真正需要时就不会被运行。
- 对模型置信度下断言而非对正确性下断言:应该衡量「答案是否正确」,而不是「模型有多自信」。
- 删除已修复的 Bug 用例:它们是回归测试套件,应该永久保留。
- 只看全局通过率:整体 99% 的通过率可能掩盖某个切片只有 70% 的事实——按切片分别卡控阈值。
- 只设下限门控:下限只能拦住明显错误,已知良好状态的基线同样必要。
- 在评估/judge 路径中使用随机采样:导致测试不稳定,用 ID 哈希替代。
- 自动重置基线:悄悄将漂移固化为新常态。
- 盯着单点数据而非趋势:单个小时的糟糕数据是噪声;两周的持续下滑才是漂移。
将评估做成门控(Gate),而非 Notebook。具体来说:测试用例作为版本化数据、显式 scorer、CI 命令(回归时让构建失败)、自动路由到对应切片。在此基础上,增加门控无法覆盖的部分——每次运行都和已知良好状态做带统计显著性检验的基线对比;从真实流量中影子采样得到通过率;监控 override/置信度/disagreement 趋势;将生产环境的意外反馈回黄金用例集。
断崖式下跌容易发现;真正的隐患是缓慢泄漏的质量问题——它只有在「关注是否比之前更差」而非「是否低于阈值」时才会暴露。两者都做到,「发布一条提示词变更」就不再是赌博,而是一个绿色的对勾——这是在 LLM 系统上快速迭代而又不悄悄搞坏它的唯一方式。
系列文章:LLM 系统生产级运行实战 — 第 2 篇(共 6 篇)
评论