

AI 系统的置信度工程:让模型知道自己"不知道"
对于生产环境中的 AI Agent 而言,最重要的输出不是答案本身,而是这个答案有多可靠。将多个独立信号组合成置信度分数、校准它的实际含义、用独立 Judge 模型评判高风险决策,剩下的交给人类——这是 LLM 生产系统六阶段成熟度模型的第三级。
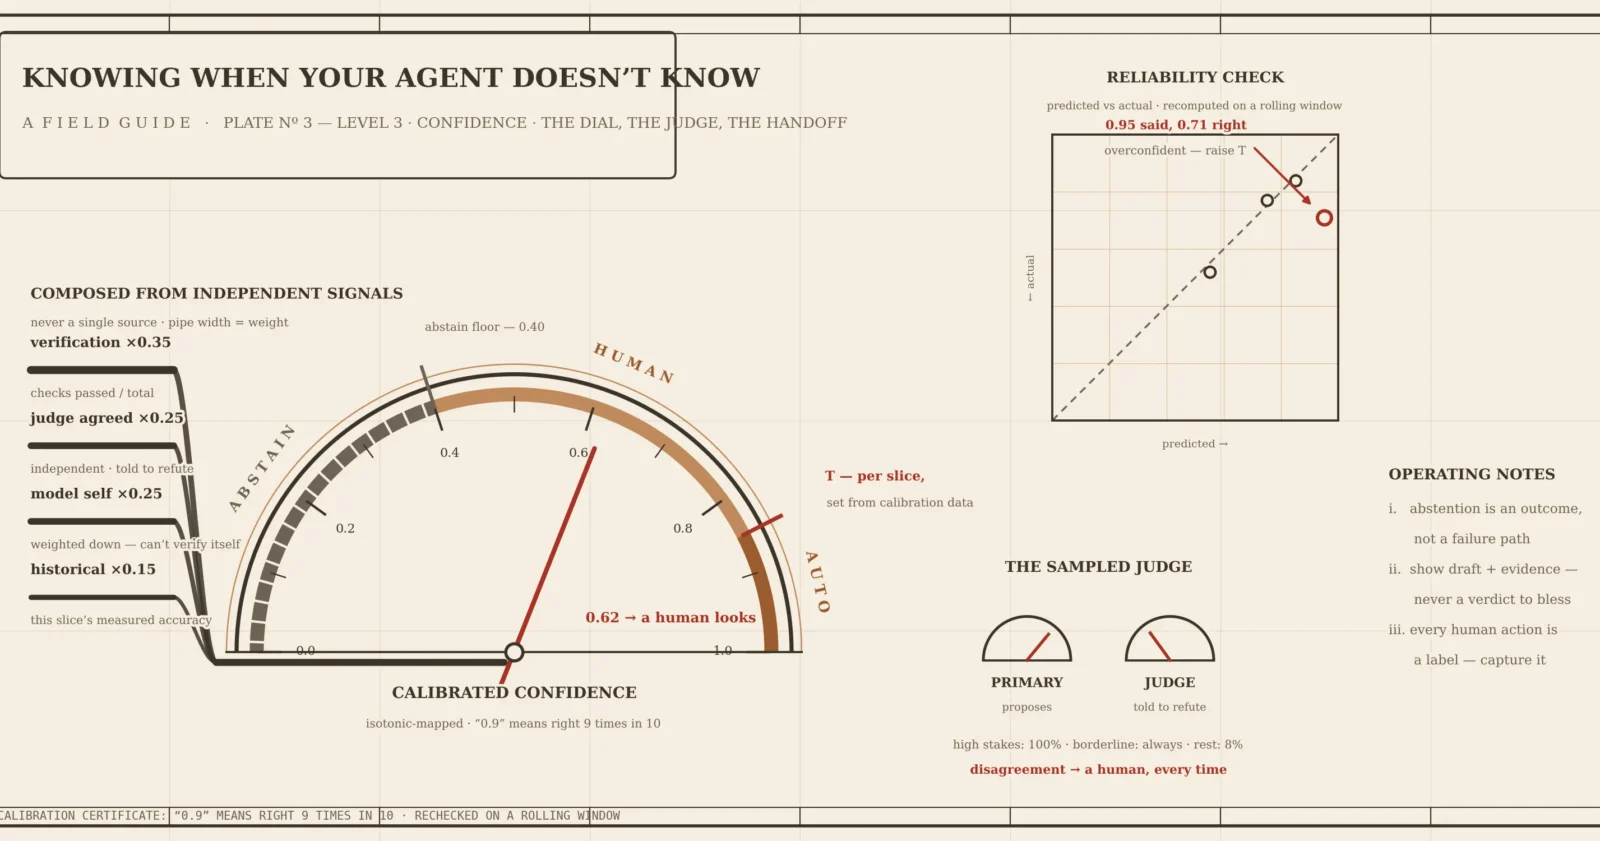
第一、二级确保系统能跑起来并可观测;第三级的核心是置信度:只有在校准后的置信度足够高时,系统才自动执行;用独立 Judge 评判重要决策;对于不确定的内容,以可追责的方式转交人类。三件事构成一个有机机制:置信度是决定"自动还是人工"的拨盘,Judge 是构成这个拨盘的信号之一,也是触发人工介入的开关,人类交接则是拨盘将低置信度内容导向的终点。三者协同,系统才能真正做到"知道自己不知道",从而被赋予更大的自主权限。
组合置信度:别信任单一信号源
大多数 LLM 系统在被问到"你有多确定"时,给不出有用的回答——要么没有数字,要么是模型自报的置信度,而这种自我评分向来校准不良(模型在犯错时往往异常自信)。因此需要工程化地构造置信度信号。
生产级评分应由独立信号组合而成,绝不直接取用模型自身的声明:
@dataclass
class Signals:
 model_self: float
 verification: float
 judge_agreed: bool | None
 historical: float
WEIGHTS = {
 "model_self": 0.25,
 "verification": 0.35,
 "judge": 0.25,
 "historical": 0.15
}
def compose(s: Signals) -> float:
 parts = {
 "model_self": s.model_self,
 "verification": s.verification,
 "historical": s.historical
 }
 if s.judge_agreed is not None:
 parts["judge"] = 1.0 if s.judge_agreed else 0.0
 return sum(WEIGHTS[k] * v for k, v in parts.items()) / sum(WEIGHTS[k] for k in parts)
具体权重数值并不重要,原则才是关键:**单一置信度来源就是单一故障点**。注意 `model_self` 的权重被刻意设得最小——当模型自信满满却犯错时,验证失败或 Judge 反对会将分数拉低,"自信地犯错"无法单凭自身越过门槛。
另外三个信号都是可被核实的:确定性验证要么通过要么失败,Judge 要么同意要么反对,历史准确率是该分片上的实测数据。只有模型对自己的评价是无法独立验证的,这恰恰是它权重最低的原因。
校准:数字必须有意义
分数只有在经过校准后才有价值——"0.9"必须意味着"大约 90% 的情况下正确"。校准方法:将决策按预测置信度分桶,测量每个桶内的真实准确率(可靠性图)。
| 预测置信度区间 | 预测值 | 实际准确率 | 判断 |
|---|---|---|---|
| 0.90 – 1.00 | 0.95 | 0.71 | ⚠️ 过度自信——需重新校准或提高阈值 |
| 0.80 – 0.90 | 0.85 | 0.84 | ✓ 校准良好 |
| 0.70 – 0.80 | 0.75 | 0.77 | ✓ |
| < 0.70 | 0.55 | 0.52 | ✓(正确表达了不确定性) |
若最高分桶实际正确率仅有 71%,说明自动化阈值设得过松。生成分桶表并触发告警的代码:
def reliability(samples, bins=10):

 rows, ece, n = [], 0.0, len(samples)
 for b in range(bins):

 lo, hi = b / bins, (b + 1) / bins
 last = (b == bins - 1)
 bucket = 展开收缩 < hi or (last and s[0] == 1.0)]
 if not bucket:

 continue
 conf = sum(c for c, _ in bucket) / len(bucket)
 acc = sum(ok for _, ok in bucket) / len(bucket)
 rows.append((round(lo, 1), round(conf, 3), round(acc, 3), len(bucket)))
 ece += (len(bucket) / n) * abs(conf - acc)
 return rows, ece
加权求和本身并不天然等于校准后的概率——`compose()` 返回的是 [0,1] 范围内的数值,而非真实概率。需要闭合这个循环:用单调映射将原始组合分数映射为经验准确率,再以此作为路由依据:
from sklearn.isotonic import IsotonicRegression calibrate = IsotonicRegression(out_of_bounds="clip").fit(raw_scores, correct) p_correct = calibrate.predict([composed])[0] 校准需在滚动窗口上持续重算——模型和数据分布都在变化,准确性会漂移。告警时优先使用 Brier Score 或分桶间隙(signed per-bucket gap),而非 ECE(ECE 对分桶方式敏感,可能在严重未校准的模型上读数为零)。还需注意独立性陷阱:如果将历史分片准确率同时塞入 compose() 权重又在校准阶段按分片处理,会造成双重计算——分片可靠性应只在一个地方编码。
置信度拨盘:自动还是人工
置信度经过组合和校准后,自动化本质上是一个阈值问题——正确的阈值 T 应按分片设置,参考依据是校准数据:
def route(conf: float, slice_key: str, thresholds: dict[str, float]) -> str:

 T = thresholds.get(slice_key, 0.95)
 if conf < ABSTAIN_FLOOR:

 return "abstain"
 return "auto" if conf >= T else "hitl_recommended"
这里的路由方案是第一级"四象限词汇表"的精简版:新增了 `abstain`(弃权),作为低于人工审核状态的底限——适用于连预填草案都不确定的输入;原来的 `reject`(验证失败)和 `hitl_required`(极低置信度)仍然保留。建议初始将 `T` 设高(几乎所有内容都走人工),只有当该分片的校准数据证明该置信度区间安全后,才逐步降低。每一个自动化区间都必须能用数据为自己辩护。

最高级的形式是**弃权**——拒绝做判断。能说"我不确定,应该让人看看"的 Agent,比总是给出答案的更值得信赖。弃权应被当作一等公民的结果,而非失败路径。这也是对抗未知未知的最佳防线:无法枚举生产环境会出现的所有奇怪输入,但有了校准后的分数加上弃权底限,奇怪的输入会自动落入人工处理。

ABSTAIN_FLOOR = 0.40
整个系统围绕三个杠杆调优,校准数据告诉你要往哪个方向拨:
| 杠杆 | 向上拨 | 向下拨 |
|---|---|---|
| 阈值 `T` | 更少自动错误,更多人工负载 | 更多自动化,更多风险 |
| `model_self` 权重 | 更信任模型(风险) | 依赖验证/Judge |
| 弃权底限 | 更少糟糕的自动提案,更多升级 | 更少升级,人类收到更多噪声 |
置信度校准的常见反模式
在构建决策层时,有几类反模式几乎必然导致系统失效:
- 直接用原始模型置信度作为阈值:模型置信度本身未经校准,误差不可控,应采用组合式判断。
- 全局单一阈值:不同数据切片的准确率差异巨大,用同一个阈值一刀切必然顾此失彼。
- 从不重新校准阈值:模型漂移是持续过程,一个季度前的阈值实际上是一个季度前的风险模型。
- 将弃权视为错误:弃权是系统正确识别自身能力边界的表现,应当测量它,而不是压制它。
采样裁判:第二模型评估第一模型
compose() 中有一个信号叫 judge_agreed,它来自"采样裁判"机制——这值得单独成节,因为对高风险决策而言,裁判模型是从"自信猜测"到"经过检验"的关键一跃。
单次模型调用是单一故障点:模型出错时往往非常自信,存在固有的盲点,而且从输出本身无法区分好的回答和看似合理的回答。廉价而有效的保险手段是引入一个裁判——一个独立的第二模型,在根据第一模型的决策行动之前对其做一次评估。
@dataclass
class Verdict:
 agrees: bool
 confidence: float
 failure_mode: str | None
def judged_decision(inputs, primary_out, judge) -> Verdict:
 return judge.evaluate(inputs=inputs, proposed=primary_out)
三个设计要点决定裁判是否有效。
**让裁判独立且持怀疑态度。** 如果裁判与第一模型相同、用相同提示词,就继承了同样的盲点,变成橡皮图章。尽可能使用不同模型家族、不同表述框架,并要求它反驳而非确认。
> You are a strict reviewer. You will be given INPUTS and a PROPOSED DECISION made by another system. Your job is to find the strongest reason the PROPOSED DECISION is WRONG, unsafe, or unsupported by the inputs. Do not be agreeable. If, after genuinely trying to refute it, you cannot, then agree. Return JSON: {"agrees": bool, "confidence": 0..1, "failure_mode": string | null}
被要求反驳的裁判远比被要求批准的裁判能发现问题——表述方式在这里产生了实质影响。一个和善的审核&查验者被问"这对吗?"时会设法说"是",而一个被要求质疑"哪里有问题?"的对抗性审核&查验者则会暴露你只有在生产环境中才能发现的故障模式。
**采样,而非全部评判。** 每次评判等于将模型成本翻倍,因此要将这笔开销花在刀刃上——用于高风险或高不确定性的决策:
| 决策类型 | 裁判策略 |
|---------|---------|
| 影响最大 / 不可逆决策 | 100% 评判 |
| 边界置信度(接近阈值) | 始终评判 |
| 其他决策 | 随机采样,如 5%~10%(持续质量探针) |
def should_judge(d, thresholds, rate=0.08) -> bool:
if d.stakes == "high":
return True if abs(d.confidence - thresholds.get(d.slice, 0.95)) < 0.05:
return True return deterministic_hash(d.decision_id) % 10000 < rate * 10000 将分歧视为路由信号和指标。 当裁判与主模型意见不一致时,该决策一律转人工处理。而分歧率本身是最好的健康指标之一——突然飙升意味着遭到攻击、一次糟糕的部署,或者模型发生了回归。
def combine(primary_out, verdict: Verdict) -> tuple:
 emit("judge_invocations_total")
 if not verdict.agrees and verdict.confidence >= 0.6:
 emit("judge_disagreements_total")
 return route_to_human(primary_out, reason=verdict.failure_mode), False
 if not verdict.agrees:
 return primary_out, None
 return primary_out, True
**一个容易踩坑的点:测试中的非确定性。** 如果裁判随机采样,而该路径在测试套件中运行,测试就会变得不稳定——相同输入在某次运行中通过评判,在下一次却不通过,导致断言间歇性失败。这看起来像个神秘的 bug,实际上是采样率渗入确定性测试的结果。在测试中固定采样率,并使用决策 ID 的确定性哈希(而非随机数生成器),使采样行为也可复现:
judge = Judge(model=secondary, sampling_rate=0.0 if TESTING else 0.08) 引入裁判不是为了把模型变完美,而是构建一个比任何单次调用都更可靠的系统——在经过评判的决策上,两个独立模型必须达成一致才能行动,而它们之间的分歧就是系统主动举起手说"这里有问题"。对那些真正重要的决策来说,这是一种成本极低、却能购买大量安全余量的方式。
交接层:人在环 UX
置信度刻度盘和裁判模型最终都指向同一个去处:被路由给人类的决策。但"路由给人工"正是许多本来不错的系统悄悄失效的地方——问题不在模型,而在交接本身。做得好,人类是一个真正的安全层,也是训练信号的来源;做得差,你只是建了一个人们不加阅读就点"批准"的按钮——这比没有人在环更糟,因为它制造了一种"有人审核&查验过"的虚假审计记录。
lazy 的交接方案只显示提议的答案和批准/拒绝按钮。在高流量下,人类会选择批准——提议锚定了他们的思维,拒绝需要付出额外努力,而队列又那么长。结果是你有一个人类在环,但他什么都没检查,外加一条虚假审计记录写着"此人已审阅"。好的 HITL UX 要让人类做出真实判断的成本足够低,并把注意力引向真正重要的地方。
展示草案和证据,而不是等待批准的结论。 对抗橡皮图章效应最大的杠杆是展示推理过程和证据——如果人类看不到结论的依据,就无法审核&查验这个结论。
{
 "proposed": {
 "decision": "approve",
 "fields": {"amount": 250}
 },
 "confidence": 0.62,
 "routed_because": "confidence_below_threshold (0.62 < 0.85)",
 "reasoning": ["matched policy 4.2", "no prior flags"],
 "evidence": [{"label": "policy", "ref": "...", "snippet": "..."}],
 "stakes": "reversible | high_cost | irreversible",
 "alternatives": [{"decision": "reject", "would_trigger": "..."}]
}
**将每次操作都捕获为信号。** 每一次人工操作都是一条标签——将其结构化记录下来,与决策关联。修改是最丰富的信号:它是正确答案,对于 golden set 的构建和发现智能体系统性问题都极有价值。
def on_review(decision_id, review):
ledger.append_outcome(decision_id, review) emit("human_override_rate", 1.0 if review["action"] != "approve" else 0.0, slice=slice_of(decision_id)) if review["action"] == "edit":
golden_set.add_candidate(decision_id, review["corrected"]) 将反馈闭环连接回置信度刻度盘。 HITL 和置信度阈值构成一个反馈回路,正是这个机制让整个决策层能够自我改进而非静态运行。
前两期我们分别介绍了置信度信号从何而来、阈值如何划定。本期作为「置信度」主题的收尾,把最后一件事说透:置信度不只是个数字,它是整套自动化安全机制的枢纽。这套机制一旦跑顺,系统就知道什么时候该收手,什么时候可以把更多决策交给机器。
核心变化:三个机制缺一不可
整篇文章的方法论可以浓缩为一个三角: ① 信号要独立,不要用模型自己的判断 置信度必须由多个独立信号合成,绝不能直接采用模型自身的「我有把握」这句话。原因很简单:模型天然会高估自己。独立信号可以是历史准确率、特定字段的编辑模式、人工抽检的偏差记录——只要来源彼此独立,置信度才能经得住真实环境的检验。
② 锚定真实结果,让「0.9」真的等于 90% 数字本身没有意义,必须用实际 outcomes 反复校准。每一次人工审核、每一个 routing 决定,都是一次校准机会。系统会在这个过程中自我修正:被法官驳回的决策提升了阈值,被人类大改的字段拉低了对应分值。
③ 独立的「怀疑者」法官,负责找漏洞 对高风险决策,引入一个独立、持怀疑态度的「法官」模型,专门尝试证明第一个模型的结论错误。它按 stake 抽样,且保持确定性——这样测试结果才稳定、可复现。法官通过则置信度加分;法官拒绝则触发人工介入。整个流程的 routing 原因对人类透明,方便其快速判断而不是逐字重读。
影响与建议
不要让人类被淹没
把一切决策都指向人工审核,这不是安全,是对自己审核团队的拒绝服务(DoS)。洪水般的队列最终会变成橡皮图章——审了等于没审。正确的做法是从上游改善置信度质量,扩大已被证明安全的自动化切片,而不是靠堆人来消化积压。
两个常见的自动化陷阱
- 拒绝比通过更难操作:一次点击通过 vs 五步填写拒绝表单,这个不对称会把阈值系统悄悄拉偏。
- 省略 routed_because:人类收到一个被路由过来的决策,却不知道它为什么被路由过来,只能粗略扫过。这样既浪费了人工审核的价值,也损失了宝贵的校准信号。
评论