

模型导向编程:一种被遗忘的编程范式,今天还有未来吗?
十三年前,Dave Clemmer 开发了一门他自称是"当时已知范围内唯一一款功能完整的模型导向编程语言及其 IDE(集成开发环境)",并以 Mo+ 为名。在个人项目和企业项目中,这门语言发挥了重要作用,但始终未能获得更广泛的市场认可。六年前,Clemmer 彻底转型,投身挪威、英国等斯堪的纳维亚地区,从事维京船和盎格鲁-撒克逊船只的建造工作。
然而,模型导向编程从未真正离开过他的思考——尤其在 AI 日益渗透软件工程各个角落的当下,他更相信这一范式仍有巨大潜力。本文的目的并非推销 Mo+ 这门具体技术,而是希望激发学术界和产业界对模型导向编程语言的进一步研究与应用。
什么是"模型"?
模型的定义有多种,但核心目标一致:用简洁的形式代表更大、更复杂的事物。在模型导向编程中,我们需要一个电子化的模型定义,可以这样描述:
模型(Model) — 由结构和数据两部分组成。结构定义模型的规则或"模式"(schema),始终是层级式的;数据则是填充到该结构中的具体实例。
模型结构与数据
层级结构
模型结构可以用节点(node)和属性(attribute)来定义:
- 每个模型结构有且仅有一个根节点
- 根节点可拥有任意数量的子节点,节点可继续递归展开,层级深度不限
- 节点至少以名称(name)标识,还可通过任意数量的属性进一步描述
节点间的引用关系
也许有人会质疑:并非所有数据结构都是层级的,例如关系数据库中的外键连接。对此,模型结构只需增加一条规则:
- 模型结构节点的属性可以引用同一模型结构中的另一个节点
这使得复杂结构能保持清晰的层级关系。Clemmer 还建议,好的模型结构定义应将节点放在其能够独立存在的最高层级上。
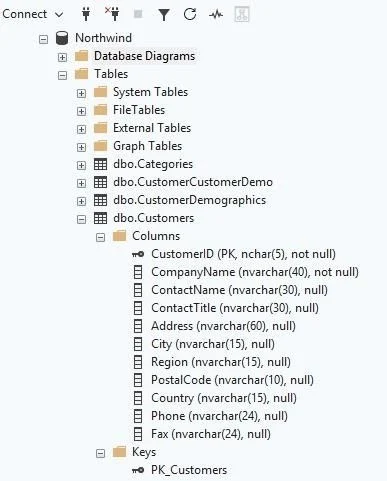
以经典 Northwind 数据库为例,用 IDE 的树形视图展开其 schema 时,可以看到完整的层级结构:

需要区分的是:
数据库表中的行数据是运行时数据,属于模型数据层面,而非模型结构本身。真正的模型结构包含 database、table、column、key 等节点,这些节点天然形成层级。
示例场景:餐厅数据建模
为便于后续说明,这里引入一个简化的餐厅场景。整个文章将围绕这一场景,演示如何用模型导向编程来处理。
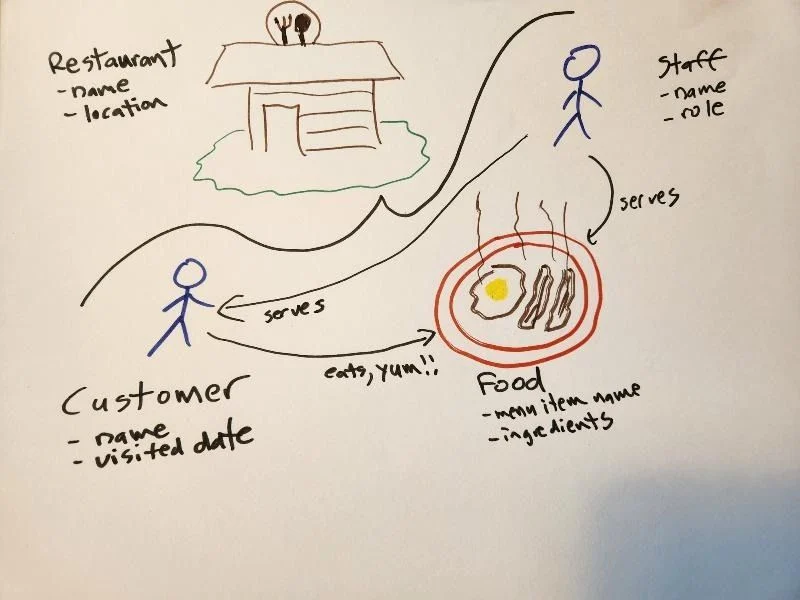
场景描述如下:
- 管理多家餐厅,每家餐厅有名称和地址
- 每家餐厅有多位顾客,每位顾客有姓名和到访时间(本简化场景不考虑回头客)
- 每家餐厅有多名员工,每位员工有姓名和职责
- 顾客点餐,记录顾客所点的菜品
- 员工为顾客提供服务,记录服务关系
用伪 Shlaer-Mellor 格式表示该场景的实体关系模型如下:
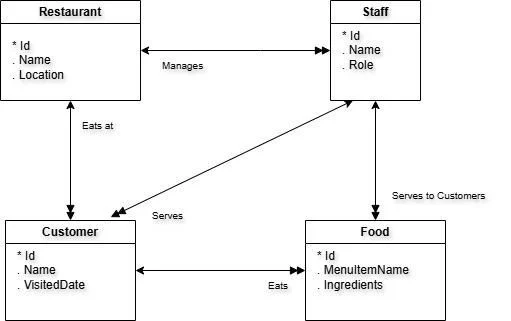
再次强调,这里展示的是模型数据,而非模型结构。接下来进入模型结构层面。
模型结构的多种可能
结构一:标准层级模型
考虑以下实体关系图,它提供了一种支持上述数据的结构:
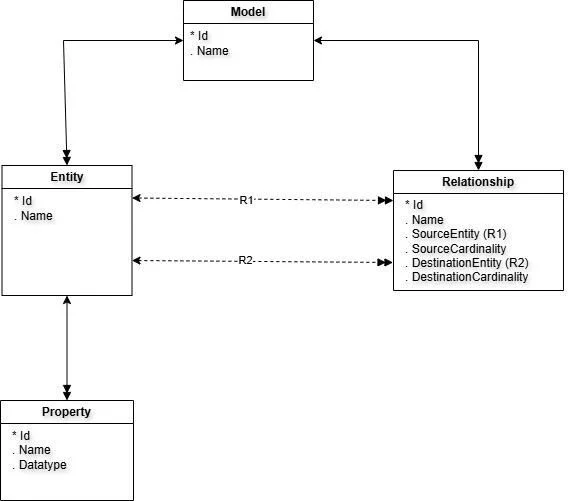
该结构以 Model 为根节点,下设 Entity、Relationship 等子节点。实线表示模型结构的层级关系,虚线表示关联(需额外添加引用属性来正式化这些关联)。在此结构下,Restaurant、Customer、Staff 等是 Entity 的实例,Id、Name、Location 等是 Restaurant 实体的属性。
结构二:平行实体模型
这是另一种完全不同的建模思路:
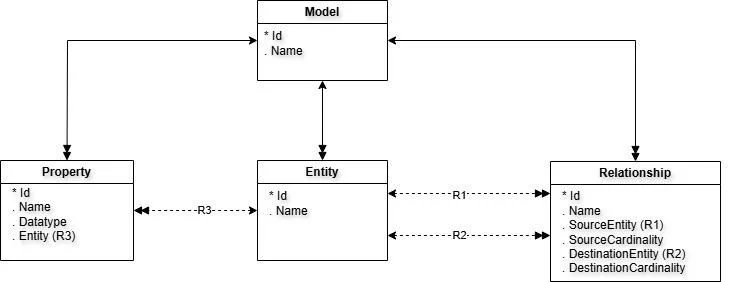
在此结构中,Entity、Relationship、Property 处于同一层级。这种设计的前提是:Relationships 和 Properties 可以独立存在,不依附于任何 Entity。
结构三:关系内嵌于实体
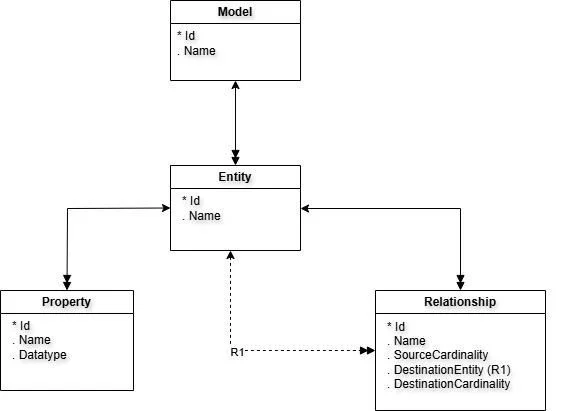
这一结构规定:关系和属性必须依附于某个实体而存在,关系节点作为源实体的子节点。不同的结构选择会直接影响模型导向编程语言中层级遍历的便利程度,后续将进一步展开讨论。
什么是模型
将模型理解为结构与数据的集合,是模型导向编程的核心出发点。这一原则看似基础,却为一系列模型导向编程语言(MOPL)奠定了根基——具体原因后文会逐步展开。
在继续之前,先明确几个关键定义:
- 建模(Modeling):将数据填充进模型结构的过程。
- 模型导向编程(MOP):利用模型来创建和维护软件系统的过程。
- 模型导向开发(MOD):创建并利用模型来构建和维护软件系统的全过程。换言之,MOD 包含了建模和 MOP 两部分。
本文后续将统一使用 MOD 和 MOP 这两个缩写。
模型导向开发的四种形态
目前业界对 MOD 的不同形态尚无标准命名,但厘清这些形态及其对 MOP 的影响具有实际意义。
非正式 MOD
非正式 MOD 指的是使用任何非标准化模型的形式。模型可以是脑海中的想法、在纸上或白板上画的草图,也可以是利用绘图工具绘制的图表。这种方式没有任何规则约束模型的创建和使用方式。
非正式 MOD 可以粗略定义为:
- 在源代码之外有一个临时性的模型定义,可能只是脑海中的想法、手写描述、自行设计或标准化的图纸与图表。
- 没有任何软件工具能够基于该模型来管理源代码。
以下是一张白板草图,展示了餐厅场景的基本概念模型,后续会进一步讨论其潜在的模型结构:
内联 MOD
随着各类框架的兴起与普及,内联 MOD 在当下极为流行。这类框架能够有效支持应用的设计与开发。
内联 MOD 可以粗略定义为:
- 在源代码中定义了正式模型,该模型通常与应用的某一特定层次相关。
- 框架提供配套的基础设施,支持对模型进行管理和利用,例如自动生成代码,或提供系统管理的底层软件。
内联 MOD 的典型例子包括:ORM 框架(如 Entity Framework、NHibernate)以及 UI 框架(如 Angular、React)。
内联 MOD 的模型通常以代码形式定义。以下是使用 Entity Framework(Code First 方式)为餐厅场景定义的模型示例: public class Restaurant { public int Id { get ; set ; } public string Name { get ; set ; } public string Location { get ; set ; } public ICollection<Customer> Customers { get ; set ; } public ICollection<Staff> Staff { get ; set ; } } public class Staff { public int Id { get ; set ; } public string Name { get ; set ; } public string Role { get ; set ; } public ICollection<Customer> CustomersServed { get ; set ; } public ICollection<Food> FoodServed { get ; set ; } } public class Customer { public int Id { get ; set ; } public string Name { get ; set ; } public DateTime VisitedDate { get ; set ; } public ICollection<Food> FoodEaten { get ; set ; } } public class Food { public int Id { get ; set ; } public string MenuItemName { get ; set ; } public string Ingredients { get ; set ; } } 上述任一实体-关系模型结构都可以用来管理这些数据;也可以使用更具体的结构,例如包含 Table、Column 等节点的结构,如下简化示意:
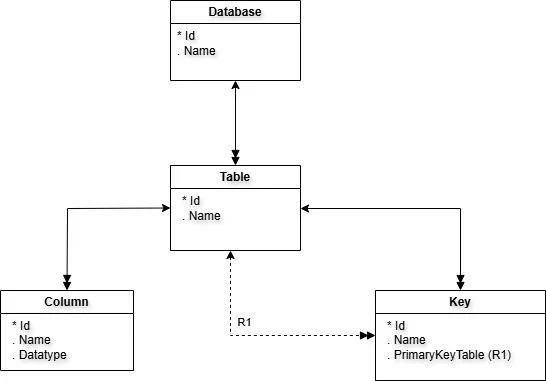
耦合 MOD
标准的 UML 建模语言及其配套工具是耦合 MOD 最常见的例子。这类工具支持 UML 建模并基于模型管理源代码。
耦合 MOD 可以粗略定义为:
- 在源代码之外定义了正式模型。
- 模型元素与源代码之间存在强关联(通常是一一对应),模型本身融入了软件设计的要素。
- 有软件工具能够管理模型,并利用模型来管理源代码。
许多 UML 图的目的是阐明系统的设计。以下是餐厅场景的类模型图:

耦合 MOD 可以使用通用的实体-关系模型结构来存储类模型数据,但更适合采用以设计为中心的结构来呈现类模型,例如:
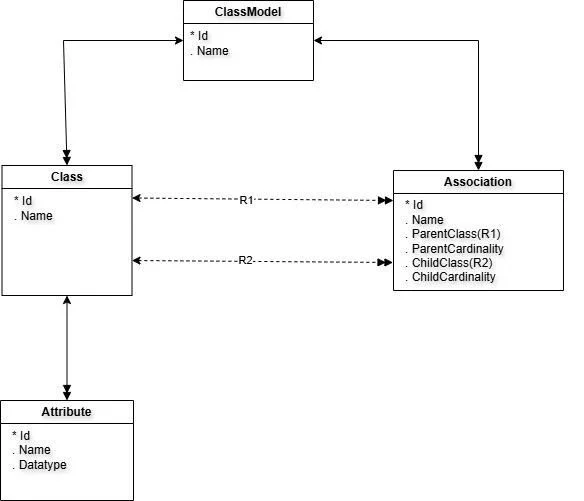
解耦 MOD
随着 UML 被更多地用于设计规范,解耦 MOD 在业界受到的关注相对较少。解耦 MOD 可以粗略定义为:
- 模型元素与源代码之间的关联较弱,源代码与模型是解耦的。抽象模型几乎不包含设计信息,详细设计同样与模型解耦。
- 有软件工具能够利用模型来管理源代码。
识别解耦 MOD 的关键在于:模型的目的是澄清想法与需求。建模通常局限于需求层面,主要围绕数据和业务流程展开,而非深入到设计或组件层面。本人倾向采用早期的 Shlaer-Mellor 方法来进行数据与流程建模。
以下是餐厅场景的信息模型(与前文相同): 在解耦 MOD 中,模型中的元素(如 Restaurant)并不指向某个特定组件,而是描述任意数量相关组件(如表、类、Web 服务、UI 组件等)的需求。
通用的实体-关系模型结构非常适合解耦 MOD。在后续的代码示例中,将使用以下结构:
不同 MOD 形态对 MOP 语言的支持潜力
是否存在能够支持上述任一 MOD 形态的 MOP 语言?答案是肯定的。那么,是否能用单一 MOP 语言同时支持所有四种形态?也许听起来有些疯狂,但我的答案同样是肯定的。不过,从潜力由小到大的角度看,各形态的排序如下。
非正式 MOD 的潜力
MOP 语言的三大应用方向
上文提到,MOP 语言在支持非正式建模方面有一定潜力——核心难题在于如何将非正式模型以电子化形式表达,让语言解释器能够理解其结构与数据。其实,MOP 语言完全可以识别并利用一套完全非标准化的结构,只是收益相对有限,可能只适用于特定团队或工作场景。
内联建模(Inline MOD)
所谓内联建模,即借助 ORM、UI 框架等标准框架所定义的模型结构来进行开发。这些框架本身依赖一套标准模型——MOP 语言同样可以围绕这套结构展开,甚至进一步强化框架本身的能力。
不过,这种方式的适用范围通常与框架边界一致,且企业自研框架时,往往只打算在内部开发流程中使用 MOP 语言,而不希望将其开放给外部。
作者旁注:多年前,作者曾在 Entity Framework 和 VITA ORM 中部分实现过这一思路,相关内容可见其 Code Project 文章。
耦合建模(Coupled MOD)
耦合建模依托 UML 等行业标准模型结构,拥有成熟完善的开发生态和大量配套工具。MOP 语言在这一领域的应用前景最为广阔:可直接基于 UML 模型创建和维护系统,现有"模型↔代码"双向转换工具也可以借助 MOP 语言大幅增强。
解耦建模(Decoupled MOD)
作者认为,MOP 语言在解耦建模场景中的潜力甚至超过耦合建模。将设计工作更多交给代码、将需求更多交给模型,可以让建模过程和编码过程都更加流畅。作者本人已通过实践验证过这一结论。
MOP 的应用层级
在讨论 MOP 语言特性之前,有必要先厘清模型驱动开发可以发生在哪些层级——不同层级对语言能力的要求差异显著。
下图展示了建模领域与系统编程领域的交叉地带,以及 MOP 可介入的不同位置:
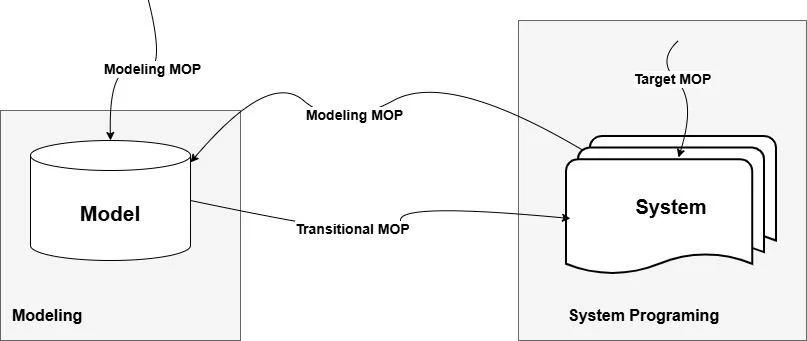
过渡型 MOP
过渡型 MOP 的目标是解析并利用模型的结构与数据,从而创建和维护目标系统环境。目标环境可以是任意语言的源代码、文档、配置文件等——后续仍可在目标环境中直接编写代码进行补充完善。
在这种场景下,MOP 语言本身无需成为目标环境的语言,但需要支持目标环境所使用的语言和文档标准。本文后续对 MOP 语言特性的讨论,将从这一场景开始。
建模型 MOP
建模型 MOP 的目标是创建和维护模型的结构与数据。模型的输入来源可以是系统自身(如源代码),也可以是外部来源(如其他模型、数据库、文档等)。
这类 MOP 语言可能需要具备一些其他场景用不到的特性。
目标型 MOP
目标型 MOP 的目标是直接创建和维护目标系统环境。此时 MOP 语言本身就是目标环境的主要语言,因此需要具备比其他场景更丰富的语言特性。
过渡型 MOP 的语言特性
以上是大量铺垫,现在终于可以正式讨论 MOP 语言的功能特性了。首先将其与面向对象语言做一些高层次的对比,以展示 MOP 语言的额外优势。
下面的代码示例采用以下配色约定:
- 核心语言语法(如语句)用蓝色
- 模型结构语法用青色
- 模型属性引用用棕色
- 输出结果用绿色
说明:以下展示的语法未必与作者实际实现的 Mo+ 语言完全一致,此处仅为清晰表达而设计。
编程会话
对于功能完备的 MOP 语言,"编程会话"(Programming Session)是一个有用乃至关键的概念。启动会话时,解释器需要解析并加载模型结构,然后灌入可用数据,生成模型在某一时刻的快照:
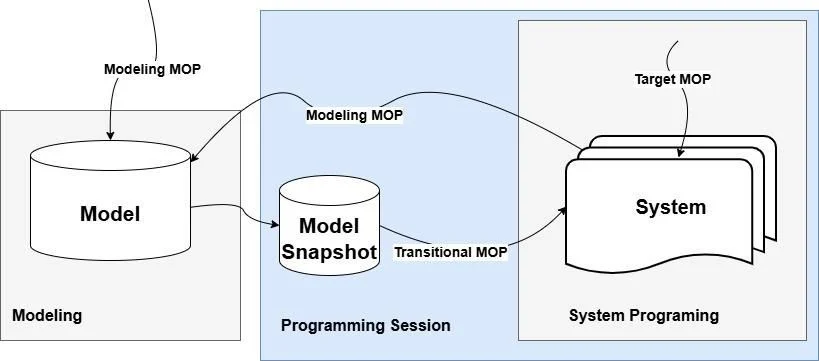
编程会话——在这段时间内,模型结构已知且数据被锁定为只读状态。无论会话持续长短,以此为基础可以解锁多项 MOP 语言特性。
将模型结构融入语言语法
既然模型结构是已知的、层级的,且在运行时即可获取,那么将其直接纳入语言语法是最充分的做法。以实体关系模型为例,将结构融入语法后,就可以直接"操作"实体、关系、属性等——换成面向对象语言,你得先为 entity、relationship、property 等创建结构或类,再实例化后才能使用。以下示例会让这一点更加清晰。
模型结构即语法——将层级模型结构的节点与属性直接加入语言语法,可以让操作模型的代码大幅简化,无需自行创建和实例化专门的类或结构。
模型上下文
模型数据在运行时读取,且天然呈层级结构,因此可以轻松遍历整棵数据树,按需访问任意节点。将这种机制引入语言文法,就构成了模型上下文(Model Context)的概念。
与面向对象语言中的对象上下文不同,模型上下文无需创建专门变量或实例来保存状态——只需持有树中某个节点的引用即可。
餐厅场景的模型结构
以下是一个餐厅场景的模型树状视图: Model: Name=My Model Entity: Name=Restaurant Property list: { Id, Name, Location } Relationship list: { Hires(Staff), Has(Customer) } Entity: Name=Staff Property list: { Id, Name, Role } Relationship list: { Serves(Customer), Serves to Customers(Food) } Entity: Name=Customer Property list: { Id, Name, VisitedDate } Relationship list: { Eats(Food) } Entity: Name=Food Property list: { Id, MenuItemName, Ingredients }
引用与输出示例
假设当前模型上下文指向 Restaurant 实体的 Location 属性,执行以下语句: print(Entity.Name, ".", Name) 输出结果为 Restaurant.Location。原理在于:模型结构本身就是文法的一部分,当前上下文在 Location 节点上,因此 Name 直接指向 Location;而 Entity.Name 则沿着层级向上查找,得到 Restaurant。
进一步扩展: print(Model.Name, ": ", Entity.Name, ".", Name) 输出 My Model: Restaurant.Location。
foreach 遍历与子节点访问
模型上下文还支持通过 foreach 遍历子节点: foreach (Property) { print(Entity.Name, ".", Name) } foreach (Relationship) { print(Entity.Name, ".", Name, ":", DestinationEntity.Name) } 输出: Restaurant.Id Restaurant.Name Restaurant.Location Restaurant.Hires:Staff Restaurant.Has:Customer 这里的 foreach 语法无需任何变量声明——迭代开始时,集合中的当前项自动压入模型上下文栈;迭代结束时再弹出。例如在 foreach (Property) 内部,当前的模型上下文就是遍历到的那个 Property 节点,同时仍可向上访问父级数据。
父级引用与路径导航
模型上下文栈还支持 ../、../../ 等路径记法,引用栈中更上层的节点: foreach (Property) { print(../Name, ".", Name) } foreach (Relationship) { print(../Name, ".", Name, ":", DestinationEntity.Name) } 效果与前例完全一致——../Name 指向栈中的父级节点,即 Restaurant 实体。
跨层级排序检索
还可以深入任意层级,访问"子节点的子节点",甚至做排序: foreach (Property in Model orderby Entity.Name, Property.Name) { print(Entity.Name, ".", Name) } 输出整棵模型中所有属性按实体名和属性名排序的结果: Customer.Id Customer.Name Customer.VisitedDate Food.Id Food.Ingredients Food.MenuItemName Staff.Id Staff.Name Staff.Role
带条件的嵌套搜索
模型上下文还支持 with 语句进行条件搜索: with (Entity in Model where Name="Food") { foreach (Relationship in Model where DestinationEntity.Name="Customer") { print(Entity.Name, ".", Name, ":", ../Name) } } 嵌套搜索的结果: Restaurant.Has:Food Server.Serves:Food
小结
将模型上下文作为一级文法概念,能带来显著的开发体验提升:模型结构即文法,开发者无需实例化专门的上下文变量,就能从树的任意节点出发,沿着层级向上、向下或跨分支访问数据。如果将模型上下文实现为栈结构,浏览和搜索模型数据将更加灵活自如。
MOP 的灵活性:表达式、put 方法与动态语法
在表达式中自由使用
由于 MOP 本质上是独立代码片段,可以像普通变量一样参与表达式运算。例如,用一条查询语句筛选出所有包含"Role"字样的实体:
foreach (Entity in Model where PublicClassCode.Contains("Role") == true) {
 print(Name)
}
运行结果会找到 Staff 实体并输出其类代码。关键在于,MOP 不需要实例化类或容器就能直接使用,这种特性使其成为构建复杂属性的基础砖块。
put 方法:直接写入目标系统
对于会话中处于 sealed 状态的模型,传统的 set 方法并不适用——因为模型整体不允许被修改。但"更新目标系统中的信息"这一需求仍然存在,于是 put 方法应运而生。
Entity property PublicClassCode
 get {
 println(PublicClassDeclaration)
 println("{")
 foreach (Property) {
 println("\t", PublicPropertyDeclaration)
 }
 println("}")
 }
 put {
 save(content, PublicClassFilePath)
 }
这里 content 是关键字,代表 get 方法的执行结果。put 将类代码写入 PublicClassFilePath 指定位置——相当于把内存中的模型快照持久化到文件系统。


构建或维护一个系统,实际上就是选取一组满足技术要求的 MOP,通过顶层属性驱动项目级组件属性,再由组件属性驱动更低层级的属性,形成自顶向下的执行链。
动态语法:运行时可扩展的语法体系
传统编程语言的语法是固定的,但 MOP 语言支持动态语法——即语法本身可以在运行时改变或扩展。
其原理并不复杂:MOP 解释器内置一个"语法构建器"(grammar builder),在会话启动时读取模型结构,将其中的节点和属性动态注册到语法体系中。这意味着模型结构本身就是语法的一部分。
场景一:模型信息不足时——扩展属性
标准化模型往往无法覆盖所有业务场景。例如,标准 Property 节点缺少 MaxLength 属性,但业务需要限制字符串字段长度。此时可以直接向 Property 节点添加 MaxLength 属性,语法构建器会将其纳入语法:
Property property StringLengthAttribute
 get {
 if (MaxLength > 0) {
 print("[StringLength(", MaxLength, ")]")
 }
 }
Entity property PublicClassCode
 get {
 println(PublicClassDeclaration)
 println("{")
 foreach (Property) {
 if (StringLengthAttribute != "") {
 println("\t", StringLengthAttribute)
 }
 println("\t", PublicPropertyDeclaration)
 }
 println("}")
 }
 put { save(content, PublicClassFilePath) }
更新后的 Staff 类代码中,Name 字段带有 `[StringLength(255)]` 注解,而 Id 和 Role 保持不变:
public class Staff { public int Id { get; set; } [StringLength(255)] public string Name { get; set; } public string Role { get; set; } }
场景二:非标准模型——支持任意结构
如果模型结构部分或完全非标准化(比如特定行业或组织自创的元模型),语法构建器同样可以解析并加载整个模型。这使得非正式建模(Informal MOD)成为可能——用贴近业务直觉的方式描述结构。
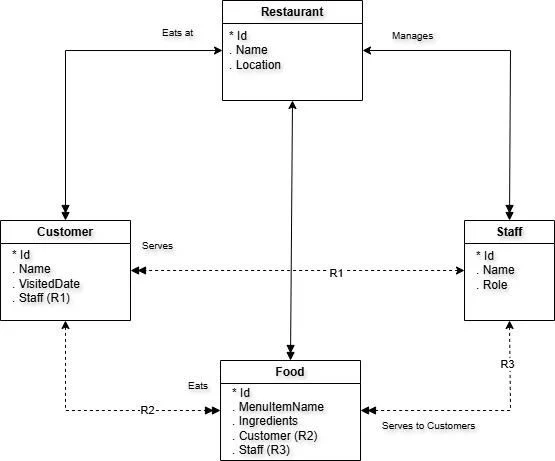
以餐厅场景为例,如果模型直接映射现实世界(Restaurant → Staff → Customer),数据结构与运行时数据完全一致,此时 MOP 语言实际上就变成了查询语言:
foreach (Restaurant) {
 println(Name, ": ", Location)
 foreach (Staff) {
 println("\tStaff: ", Name, ", ", Role)
 }
 foreach (Customer) {
 println("\tCustomer: ", Name)
 }
}
输出示例:
Chez Food: London
 Staff: Verity Jones, Chef
 Staff: Nigel Walker, Server
 Customer: David Spencer
 Customer: Catherine Rees
Chez Food: Paris
 Staff: Monique Dubois, Chef
 Staff: Henrique Bernard, Server
 Staff: Michelle Fontaine, Server
 Customer: Pierre Simon
 Customer: Camille Fournier
理论上可行,但在实际工程中,大量运行时数据加载到会话中并不现实。作者表示,目前实践中仍然倾向于使用通用标准结构。
Grammar Builder 与上下文相关语法
Grammar Builder
Grammar Builder 是一种语言解释器机制,允许在运行时修改或扩展语言语法。MOP 语言解释器可以在会话开始时读取模型结构,并将其添加到语法中,从而让新增的结构立即可用。
上下文相关语法
与动态语法相比,上下文相关语法的优先级可能略低,但它对 MOP 语言非常有价值。MOP 的应用场景广泛——支持建模、从模型过渡、以及目标编程等——因此上下文语法过滤器能确保在不同场景下提供恰当的语法集,防止写出产生意外后果的代码。
全局过滤器 对于某些模型导向属性方法,限制可编写代码的范围有助于强化职责分离、避免意外后果。具体过滤器包括:
- 在模型导向属性的 get 方法中,禁用向其他位置写入信息的任何能力,过滤掉可向任意位置写入数据的语法。
- 在模型导向属性的 put 方法中,允许向模型以外的位置写入信息,过滤掉可向模型内写入数据的语法。
- 在模型导向属性的 set 方法中,仅允许向模型写入信息,过滤掉可向模型写入数据的语法。
过渡期 MOP 过滤器 在支持利用模型管理目标环境的编程场景中,过滤器逻辑为:
- 禁用为模型导向属性创建 set 方法,因为这些方法用于更新模型并可能使编程会话失效。
建模 MOP 过滤器 在管理模型的编程场景中:
- 禁用为模型导向属性创建 put 方法,因为这些方法用于更新模型外的信息。
目标 MOP 过滤器 在直接管理目标环境的编程场景中,通常需要更完整的语法来支持目标程序员的各种需求。此情形下,可以允许所有类型的模型导向属性方法,并配备适当的语法过滤器——前提是了解 set 方法可能导致编程会话失效。
几乎无需变量
过渡期 MOP 所需的变量极少。借助 Model Context 并可访问整个模型数据树,许多在其他语言中必须使用变量的场景在这里不再需要:
- 搜索或遍历时,无需变量保存迭代状态。
- 评估模型导向属性时,无需中间变量。
- 模型导向属性可直接用于表达式等各类场景。
事实上,变量支持是在开发过程很晚阶段才加入的。对于过渡期 MOP,除了少量全局(状态)设置外,我在开发的模型导向属性中最多只用了约 1% 的变量——甚至这些少数场景本可通过更优的模型导向编程或略微扩展模型结构来处理。实践中我几乎总能找到一种模型导向属性来表达其他语言中需要用变量保存的逻辑。
高度可复用性
如前所述,模型导向属性极为灵活——它们是独立的代码片段,几乎可以在任何位置使用。这种灵活性带来了极高的可复用性,既体现在单个程序内部,也体现在不同程序之间。实践中我发现,模型导向属性往往是将最佳实践固化为代码,超越了任何单一项目的功能需求。
以下是一个极其简单的类命名规范示例——这样的最佳实践属性可以重复使用数百次。当然,更复杂的"最佳实践"属性同样可以反复复用: Entity property ClassName get { print( Name.PascalCase()) }
海量并行潜力
如果几乎不需要变量,且模型数据在编程会话中以只读形式密封,那么评估模型导向属性时就存在海量并行的潜力。
虽然没有实现真正的并行,但我实现了缓存机制。解释器会对特定模型上下文(节点实例)下模型导向属性的评估结果进行缓存,以便后续多次复用。仅此一项就带来了显著的性能提升。
与目标语言(自定义)代码的集成
根据我的实践经验,用合理的投入,过渡期 MOP 可以将约 80% 的目标企业环境按最佳实践管理起来;若投入翻倍或更多,有望达到 90%。但无论如何,要将目标环境 100% 保持最佳实践,尤其是通过过渡期 MOP 进行更新时,必须有相应的应对策略。
以下几种方式可供参考——没有一种是完美方案,但各有适用场景:
- 局部文件(Partial Files):最简单的起点是将 MOP 语言解释器创建和更新的文件,与目标语言直接创建或修改的文件分开。例如局部类文件(partial class files)就是这一思路的体现。
- 自定义点(Customization Points):局部文件的定制能力有限。更灵活的方式是在解释器管理的文件内定义可扩展的自定义点(如命名区域或注释标记),自定义代码可插入这些位置;当解释器需要重新更新整个文件时,也能保留这些自定义代码。
- 文件更新与删除策略:解释器应仅更新和删除自己管理的文件,对其他自定义文件保持静默。若管理文件内含有自定义代码,则不应删除该文件。
- 忽略策略(Ignore Policy):对于需要深度定制的文件,可将其标记为"忽略",此后解释器将不再处理该文件。
按 MOD 形态的影响
编程场景与 MOD 形态的适配差异
上述功能在不同形态的 MOD 中均可发挥作用,但需注意以下适配差异。
编程会话(Programming Session)
对于耦合式 MOD(Coupled MOD),编程会话更容易因设计变更而快速失效——在实际项目中,细节设计模型的体积远大于其他形态,因此加载模型数据会占用更多内存资源。
动态语法(Dynamic Grammar)
对于非正式 MOD(Informal MOD),动态语法与语法构建器属于刚需,因为这类形态没有标准化的模型结构可供依赖。
高度可复用性(Massive Reusability)
这更多是一种经验直觉而非实证数据:在解耦式 MOD(Decoupled MOD)下使用时,可复用性表现最佳。实践中发现,大多数面向模型的属性本质上是可以跨项目反复使用的最佳实践代码。
建模 MOP 的实现要求
建模 MOP 的核心目标是创建并维护模型的结构与数据,因此其语言需求与过渡型 MOP 存在显著差异。除了通过 IDE 手动建模外,以下特性对程序化建模尤为关键。
定义模型结构
定义或扩展模型结构是 MOP 语言的必备能力,用以应对多种编程场景。基础能力包括:在层次化模型结构中增删节点,以及为节点添加和编辑属性。这些信息可进一步传递给语法构建器,实时更新模型语法。
以下示例展示了用简单语句构建餐厅模型结构、以 Restaurant 为根节点的过程: createModel ("Restaurant") addNode (Restaurant, "Customer") addNode (Restaurant, "Staff") addNode (Restaurant, "Food") addAttribute (Restaurant, "Id") addAttribute (Restaurant, "Name") addAttribute (Restaurant, "Location") addAttribute (Staff, "Id") addAttribute (Staff, "Name") addAttribute (Staff, "Role") addAttribute (Customer, "Id") addAttribute (Customer, "Name") addAttribute (Customer, "VisitedDate") addAttribute (Food, "Id") addAttribute (Food, "MenuItemName") addAttribute (Food, "Ingredients") 注意:添加或编辑模型结构的语句可即时更新语法构建器,使新模型元素立即可用。完整的模型结构管理语句集还应包含编辑、删除等功能,以及数据类型等更丰富的信息。
导入与导出
建模 MOP 的一项重要能力是支持与外部模型数据源的导入/导出交互,具体场景包括:
- XML 文档:XML 导入需解析输入文档的结构,并将其中的节点和属性映射到目标模型结构。
- 数据库:数据库导入需配置连接字符串、读取数据库 schema,并将 schema 元素对应到模型结构。
- 其他模型:与上述场景类似,模型间的导入/导出要求能够理解源模型与目标模型的结构对应关系。
在实际企业项目中,来自其他模型的数据导入占据了大部分建模工作量。若同时存在手动建模与导入操作,IDE 需要追踪并维护手动修改的内容,防止后续导入覆盖已有变更。
标签(Tagging)
标签是一种为模型数据树中任意元素附加非结构化信息的方式,用于指定额外需求。标签可以是字符串值列表,也可以是附加在模型元素上的名称/值对。
举例来说,假设员工姓名属于机密信息,需要对某属性进行加密处理。此时可为 Staff 的 Name 属性添加 "secure" 标签: Entity property PublicClassCode get { println(PublicClassDeclaration) println("{") foreach (Property) { if (Tags.Contains("secure")) { println("\t[Encrypt]") } println("\t", PublicPropertyDeclaration) } println("}") } 生成的 Staff 类代码如下: { public int Id { get; set; } [Encrypt] public string Name { get; set; } public string Role { get; set; } }
目标型 MOP 的前瞻思考
由于未将 MOP 语言实现为目标语言,这部分内容属于纯理论推演,是后续研究的主要方向。
语言语法
目标型 MOP 语言的语法复杂度将远超过渡型 MOP,需要覆盖目标语言程序员的各种操作需求。其中,类型安全在过渡型 MOP 中非必需,但很可能成为目标型 MOP 的必要特性。
与过渡型 MOP 的集成
这是非常值得深入思考的领域。前面提到过渡型 MOP 可以通过定义定制点来管理自定义代码;而对于真正的目标型 MOP 语言,显然需要更智能的机制。
设想这样一种场景:使用过渡型 MOP 利用模型来构建和维护项目的基础框架乃至复杂的企业级框架。此时,如何将目标代码接入这一框架?当框架本身因最佳实践或其他因素发生变化时,目标代码的变更又如何管理?目前尚无具体方案,但从高层视角看,可以想象一个智能 IDE,能够向程序员展示框架更新与目标代码的差异,并辅助完成目标代码的同步更新。
与建模 MOP 的集成
建模 MOP 或手动更新模型数据对目标编程的影响与上述场景相同。当会话和框架发生更新时,同样需要一个智能化的图形化 IDE 来协助管理目标代码的变更。
模型结构变更时会发生什么
如果通过手动方式或 Modeling MOP 改变了模型结构,MOP 语言语法也会随之改变——这种情况该如何处理?
Transitional MOP 给出了答案:删除模型结构元素会触发编译错误,这些错误可以被逐步修复;而新增的模型结构元素,仅会在面向模型的属性变更中被调用,不会立即影响既有代码。
至于语言语法变更后如何管理目标代码,作者认为这需要一个智能 IDE 来兜底,但具体实现思路尚未成熟,作者也向读者征询想法。
目标语言中的变量
作为目标语言,变量需求主要集中在处理用户输入或其他 I/O 场景。作者判断,MOP 目标语言中的变量使用量,会明显低于传统命令式语言。
新语言还是扩展面向对象语言
MOP 作为目标语言时,其语法与面向对象语言存在大量重叠。因此一个值得思考的问题是:MOP 语言是否应该作为一门独立语言存在,还是作为现有面向对象语言的扩展?这个选择将影响语言的设计方向和生态演进。
小结
本文探讨了模型导向语言的几个核心问题:结构变更时的语法管理、目标语言中变量的角色,以及语言定位的选择。如果你对这一领域感兴趣,可以进一步了解作者多年前开发的 Mo+ 语言及配套 IDE。
评论