
内容管家
评论0字数 1238阅读4分7秒阅读模式

大语言模型驱动的 Agent 是当下 AI 应用开发的核心方向之一,但许多团队都面临同一个困境:Demo 惊艳,上线却问题百出。原因并非模型能力不足,而是缺乏支撑生产级运行的工程机制。
这篇文章的核心观点可以一句话概括:LLM 本质上是概率模型,而生产环境需要确定性保证。实现这种保证的路径,不是让模型"更确定",而是将模型的职责压缩到最小决策单元,然后在其外围构建完整、可测试、可审计、可观测的确定性工程架构。
核心变化:六层成熟度模型
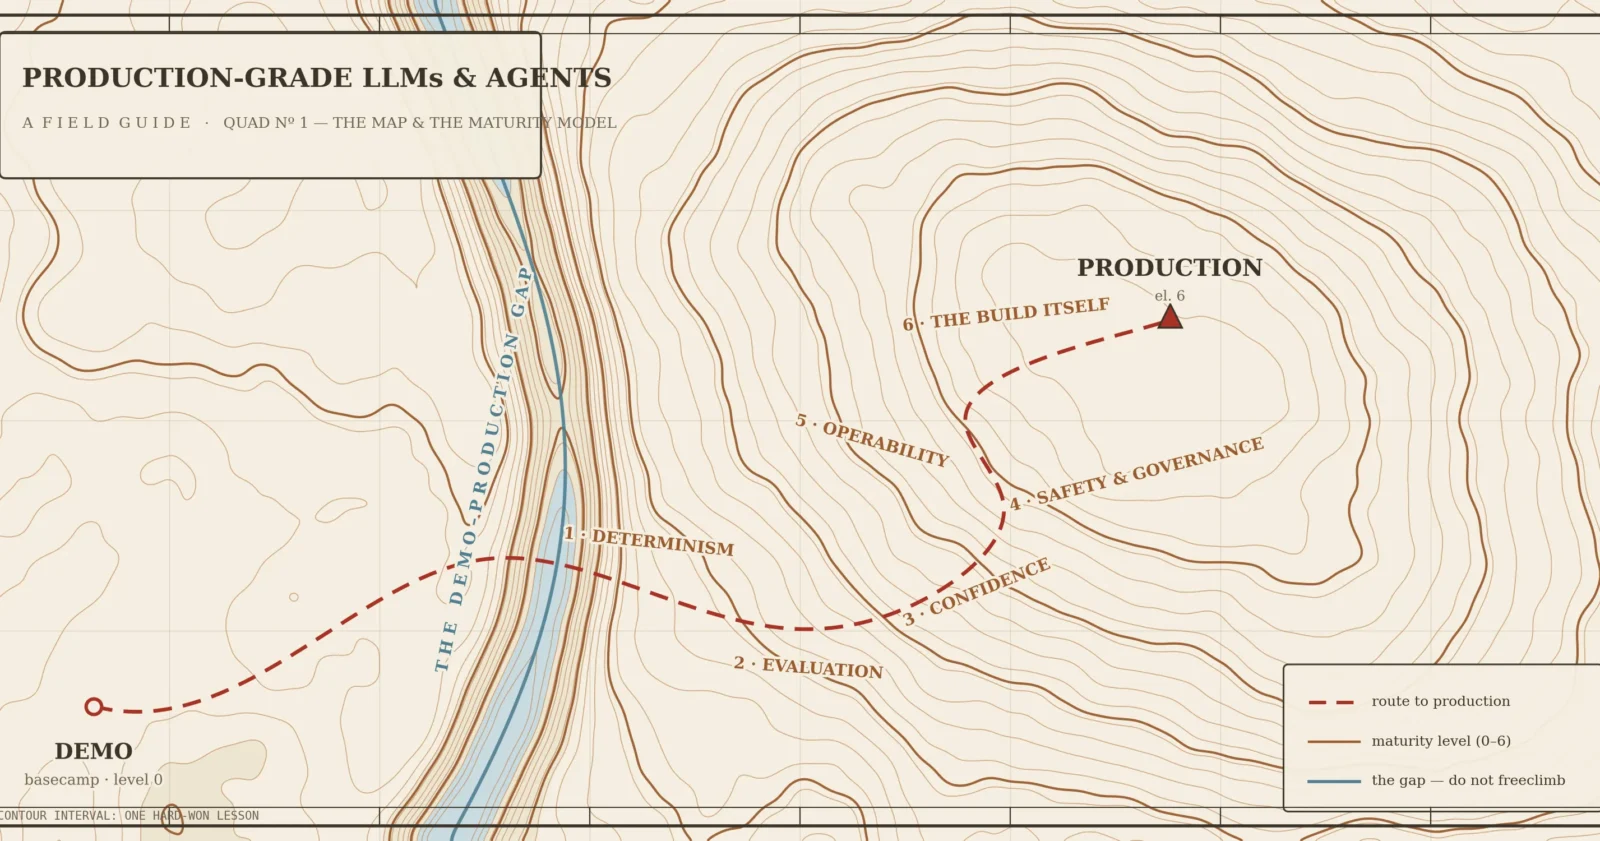
文章提出了一套从 Demo 到生产级的六层成熟度模型,每个层级都以前一层为基础:
| 层级 | 名称 | 典型表现 | 差距特征 |
|---|---|---|---|
| 0 | Notebook 阶段 | 一个提示词 + 一个模型 + 跑通正向用例 | "我的例子能跑" |
| 1 | 确定性 | Agent 仅提议(不直接操作);每个能力对应固定流程图;模型作为单一节点;循环有界 | Agent 能写业务状态,但行为依赖其游走路径 |
| 2 | 评估体系 | CI 流程中嵌入评估;基线漂移检测;生产流量影子评估 | 改个提示词只能靠"希望没事";评估还停留在 Notebook 里 |
| 3 | 置信度校准 | 组合置信度 + 校准输出;自动路由 vs 人工阈值;采样 Judge | 依赖原始置信度数值做决策;缺乏主动弃权机制 |
| 4 | 安全与治理 | 纵深防御护栏;PII 在边界处理;仅追加审计账本;作用域内存 | 只有一层内容审核;原始输入写入日志;审计可篡改 |
| 5 | 可运维性 | 决策可观测;成本控制;模型路由 + 降级;熔断开关 | 靠账单和客户投诉才发现质量和成本问题 |
| 6 | 生产级构建 | 构建流程本身规范化——决策日志上的并行 Agent;Agent 编程操作系统 | 靠口口相传;决策每隔几周就要重新争论 |
使用方法
找到当前最薄弱的那一层,从那里开始修复,且严格按顺序推进。大多数团队的现状是:0 层很强、1 层缺确定性、5 层缺可观测性——但正确的顺序是:确定性优先于评估,评估优先于置信度,置信度优先于规模化,安全优先于规模化,可观测优先于安心上线。
影响与建议
快速自检:你的 Agent 现在处于哪一层?
回答以下问题,统计"是"的数量:
- Agent 只能提议,实际变更由独立组件在审批后执行
- 每项能力都是一个固定步骤序列,模型只是其中一环
- 提示词或模型的变更导致质量下降时,CI 会拦截
- 每次发版都和基线做对比,而非仅检查是否通过门槛
- 决策附带组合校准置信度,低置信度自动路由给人工
- 护栏分层(输入过滤、输出过滤、PII 检测、验证、评判),失效默认关闭
- 敏感数据在边界层脱敏或哈希处理;审计账本仅追加
- 仪表盘可见决策记录、护栏拦截、Token 消耗、人工介入频率
- 秒级停止自动化决策,无需重新部署
- 核心决策以日志形式沉淀,人和 Agent 都能读取
低于半数"是":你比 Demo 展示的阶段要早期得多,这是系列文章的用武之地。
关键认知转变
从 Demo 到生产,核心不是"更信任 AI",而是更严格地约束模型、将其装入一个可测试、可量化、可审计、可观测的系统架构中。每上一级台阶,系统可靠性就提升一个档次。
系列文章地图
以下为每个层级配套的深度展开文章,可按需查阅: 第 1 层 · 确定性
- 让 AI Agent 变得无聊
- Agent 请求的解剖学
- 结构化输出优于自由文本
- 有界 ReAct:循环只应出现在一个地方
第 2 层 · 评估
- 评估作为部署关卡
- 生产环境中的漂移检测
第 3 层 · 置信度
- 基于置信度构建系统
- LLM-as-Judge
- 人工介入 UX 设计
第 4 层 · 安全与治理
- 纵深防御护栏
- 边界层的 PII 处理
- 仅追加审计账本
- 多租户 Agent 的记忆模型
- 种子数据与运行时
第 5 层 · 可运维性
- AI 系统的六边形架构
- LLM 系统的可观测性
- 成本控制
- 模型路由与降级
- 熔断开关与优雅退化
- Agent 身份体系
- Agent 平台实际需要的基础设施
- 让 Agent 流水线提速
第 6 层 · 生产级构建本身
- 并行自主 Agent 的构建运行
- 决策日志
- 编程 Agent 的操作系统
评论