

10 月版本发布周期里,Stack Internal 与 Stack Internal Community 同步上线了一批更新,目标很直接:把散落在代码仓库、聊天记录和文档平台里的组织知识,收拢成边界清晰、权限可控、经过人工验证的上下文层,既服务于开发者,也服务于 AI Agent。
之所以强调"边界"与"验证",与一组调查数据直接相关。Stack Overflow 2026 年开发者调查显示,75% 的开发者每周花费超过 5 小时查找信息,而 79% 的开发者在任务已经开始之后才发现关键上下文。换句话说,信息并非不存在,而是难以在正确时机、以正确粒度被找到和使用。
核心变化一:Stack Internal 的上下文治理升级
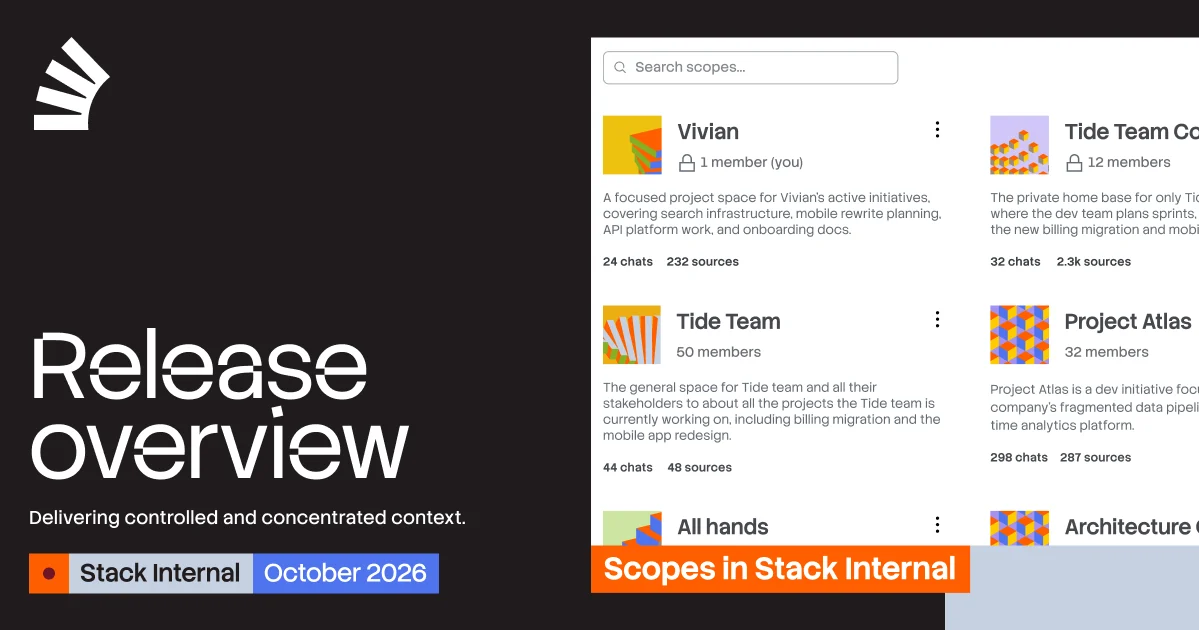
Scopes:把组织知识切成有边界的上下文层
Scopes 是 Stack Internal 新增的上下文层,可以理解为在组织内部再划出一组聚焦、受权限治理的知识空间。通过控制"纳入哪些知识"以及"谁可以使用",Scopes 能在不给人类和 AI Agent 引入噪声或越权暴露的前提下,提供更集中的上下文。
在实际使用上,用户可以按当前任务在项目、团队或部门等不同空间之间切换;也可以通过 Model Context Protocol(MCP)服务器,直接指定 AI Agent 查询某个特定的 Scope。
开箱即用的 GitHub 连接器:让代码仓库变成企业记忆
新增的 GitHub 连接器会把组织自有代码讨论中的工程知识——包括 issue、pull request 和仓库文档——直接摄取进 Stack Internal 的已验证知识层。它会自动捕捉高信号价值的工程决策与文档,无需人工维护。
更关键的是权限处理:连接器遵循源端权限,GitHub 现有的访问控制同时对人类和 AI Agent 生效。
服务账号:安全连接应用与自动化工作流
组织工作区现在可以使用服务账号来连接应用、MCP 客户端和自动化流程,不再依赖个人 token 或共享账号。开发者获得标准的 OAuth 授权流程和稳定身份,安全团队则能更方便地管理凭证生命周期。
每个服务账号绑定唯一工作区,拥有独立的权限、凭证和可审计身份,便于把 Stack 的知识安全地接入企业既有的 Agent 工作流。
验证 API:让已验证知识保持新鲜
当组织工具中的知识源随制度演进而过时,同步问题就会浮现。为此 Stack Internal 引入了一个验证 API 端点:团队可以自建集成,监控 Stack Internal 中的验证事件,按时间范围、主题或来源做筛选,并把更新后的、经过验证的知识自动写回任意来源,例如 Confluence 或 Stack Internal Community。
SME 验证流程内置于 Web UI
Subject Matter Expert(主题专家,SME)验证流程现已直接集成在 Stack Internal 的 Web 界面中。通过新的 Reviews 功能,用户可以在一个集中的界面里验证来自同一工作区其他成员提出的问题。
核心变化二:Stack Internal Community 的治理与透明度增强
内容互动与变更可解释
社区支持在问答帖和文章中使用动图 GIF 提升互动性,同时补充了变更说明机制:对于已过时的帖子给出清晰的失效理由,对于未被采纳的答案标明归属来源,让知识变更本身可被追溯。
版主协同与管理员视角
版主管理支持定向公告(targeted announcements)与颗粒度更细的 SME 控制项;管理员则可获得更深层的平台可见性,包括搜索活动导出,以及一个记录站点配置变更的 History 页面。
影响与建议
两者如何协同
两个产品各自独立就已够用,但设计上更倾向于组合使用:
- Stack Internal Community 充当经过人工验证的记录系统(system of record);
- Stack Internal 把这份可信事实直接延伸到日常工作流和 AI 工具链中。
由此形成的是一个持续复利的组织记忆层:知识在工作发生的地方被激活——在 IDE、Slack、Microsoft Teams 和编程助手中,通过 MCP 提供自然语言对话式 AI 摘要,同时保留对原始 Community 讨论帖的直接可见引用。
信任标签与权限边界
系统会给数据附加明确的信任标签,例如 validated(已验证)、corroborated(已互证)、conflicting(存在冲突)、unsupported(缺乏支撑)。再把 Community 的问答与实时仓库上下文一起装入权限受限的 Scope,开发者与 AI 模型都能在不产生幻觉、不发生上下文漂移的前提下做出有把握的决策。
落地建议
如果团队准备试用,可以按以下顺序推进:
- 先选定一个边界清晰的场景,例如某个核心服务或某个前端项目,用 Scopes 建立第一个上下文空间,而不是一上来就全量接入;
- 开启 GitHub 连接器,让该范围内的 issue、PR 与仓库文档先沉淀成可检索的工程记忆;
- 用服务账号接入现有工具链,把 AI 助手的查询范围锁定在指定 Scope 内,避免 Agent 越权访问;
- 把 SME Reviews 与验证 API 纳入流程,让"知识已过期"成为可被系统捕获的事件,而不是靠人肉发现;
- 把 Chat UI 或 IDE 中已解决的技术讨论回写为经审核的 Community 问答,形成"讨论 → 沉淀 → 再被引用"的闭环。
评论