

LLM 系统凭什么上生产?Level 4 安全治理四步法
一个 LLM 系统何时才配触碰真实数据、介入真实决策?答案是:当你构建起分层护栏(fail-closed)、在边界处理 PII、保留不可篡改的审计日志,并对记忆按类别严格隔离时——这便是成熟度模型的 Level 4:安全与治理。
在此之前,"能用就行"或许可以接受;但当系统开始做真正重要的决策时,"能用"远远不够。这个层级包含四项 disciplines,团队往往后期才匆忙拼接,实际上它们必须在设计阶段就内置进去。四者的共同理念是:不要信任任何一个单点能始终做对。叠加独立护栏,让某一层的遗漏被下一层捕获;在每个边界处理敏感数据,防止其堆积在不应当的位置;建立不可变的审计轨迹,让"它为什么这么做"在数月后仍有答案;按类别划分记忆,确保一个客户的数据永远不会流入另一客户的决策——在交付物与系统获取的内容之间划清界限。
这四项 discipline 本身并不高深,每个都是代码中可测试的小型契约。以下是它们如何协同工作的完整图景。
分层护栏:纵深防御
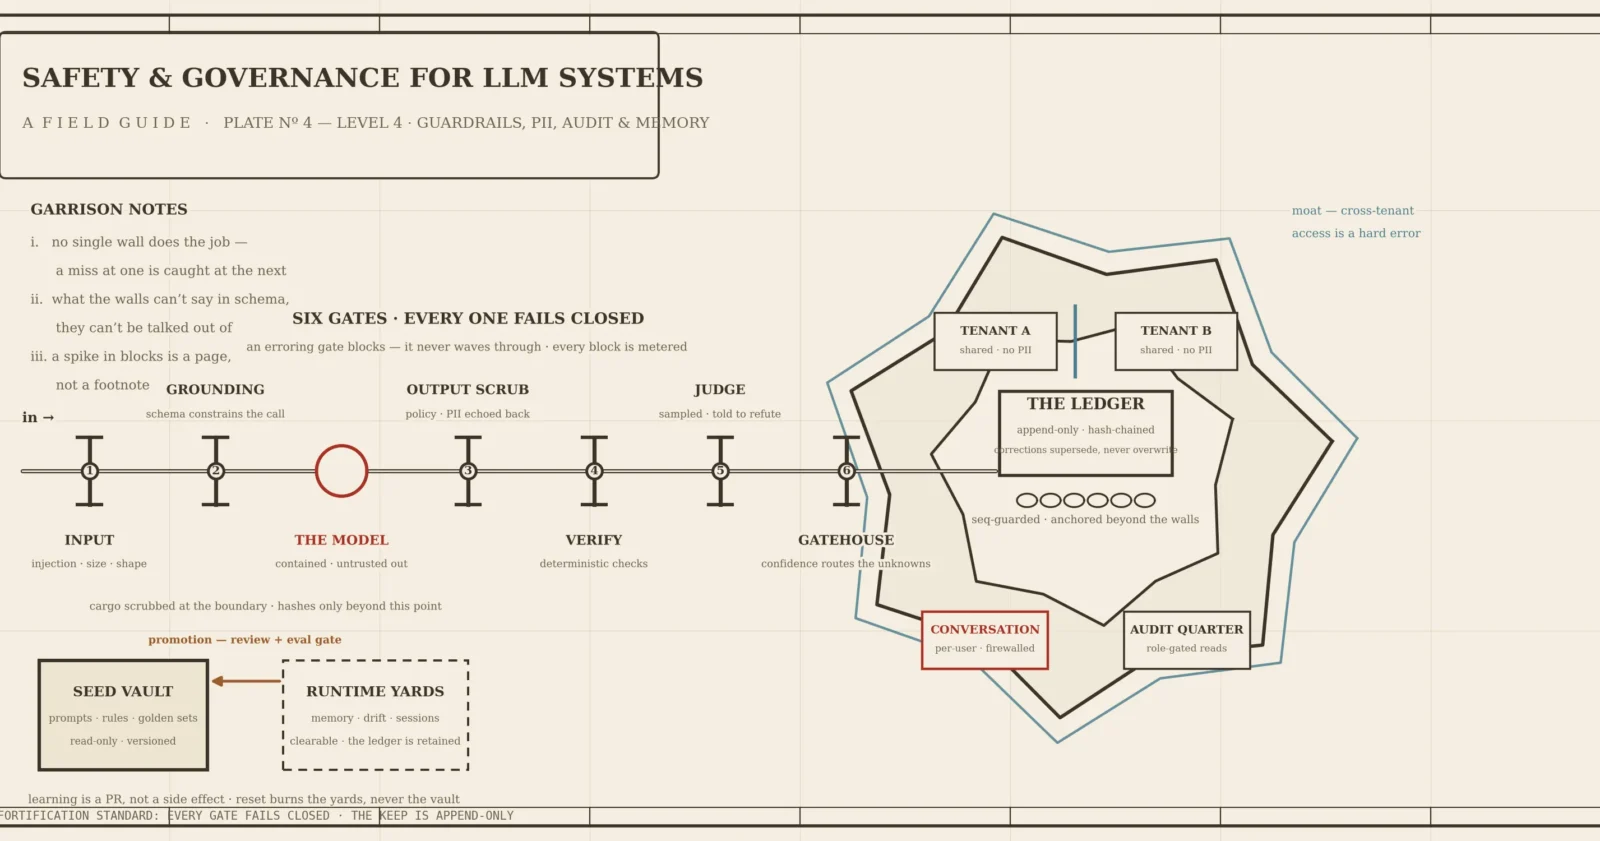
很多团队"加护栏"的方式,是在模型输出末端挂一个审核过滤器,然后宣称大功告成。这相当于只用一条防火蔷规则来防护整个网络。真正的安全——和真正的网络安全一样——需要纵深防御:若干独立层级,每个捕获不同类别的问题,层层递进、前一层漏报则后一层捕获。
护栏之间遵循统一的小型契约,这样就可以独立地增删、测试和重排。
@dataclass class GuardrailResult:
action: Literal["ok", "block", "redact", "flag"] layer: str rule: str = "" detail: dict = field(default_factory=dict) class Guardrail(Protocol):
layer: str def check(self, ctx: "Context") -> GuardrailResult: ... 请求在入口与出口之间依次经过各个检查点:
| 层级 | 捕获目标 | 阶段 |
|---|---|---|
| 1 | 输入/预注入、超大/畸形输入 | 模型调用前 |
| 2 | grounding——模型使用禁用动作/数据;输出偏离 schema | 模型调用 |
| 3 | 输出清洗——策略违规、PII 被回显 | 生成后 |
| 4 | 验证——业务规则/一致性违规 | 确定性子系统 |
| 5 | 判断——通过机械检查但"合理但错误"的答案 | 采样二模型 |
| 6 | 置信度 + 路由——仍有疑问的未知项 | 最终网络 |
in ─▶ [1 input] ─▶ [2 grounding] ─▶(model)─▶ [3 output scrub] ─▶ [4 verify] ─▶ [5 judge] ─▶ [6 confidence/route] ─▶ act | escalate 顺序与判断逻辑集中在一处可读的位置。两条核心规则:fail-closed(护栏报错或不可用时,阻断或升级请求——绝不直接放行)以及每次阻断都作为一等公民信号记录。
def run_guardrails(ctx, layers, metrics) -> list[GuardrailResult]:
 applied = []
 for g in layers:
 try:
 r = g.check(ctx)
 except GuardrailError:
 metrics.incr("guardrail_blocks_total", layer=g.layer, rule="error")
 return applied + [GuardrailResult("block", g.layer, "error")]
 if r.action == "ok":
 continue
 metrics.incr("guardrail_blocks_total", layer=g.layer, rule=r.rule)
 if r.action in ("redact", "flag"):
 ctx.apply(r); applied.append(r); continue
 if r.action == "block":
 return applied + [r]
 return applied + [GuardrailResult("block", g.layer, "unknown_action")]
 return applied or [GuardrailResult("ok", "all")]
最重要的测试用例,用来证明 fail-closed 确实生效:
def test_fail_closed_on_error():
class Boom:
layer = "x" def check(self, ctx):
raise GuardrailError("boom") result = run_guardrails(ctx, [Boom()], NullMetrics()) assert result[-1].action == "block" 分层优于单一大过滤器的原因:
- 无单点故障——注入绕过第一层?grounding 限制其可执行动作;输出偏离预期?scrub 或验证层捕获。
- 每层简单可测——六个单一职责检查各有清晰契约,而一个大过滤器根本无法有效推理。
- 不同层捕获不同失败模式:输入清洗捕获攻击,验证层捕获逻辑错误,判断层捕获"合理但错误",置信度层捕获未知未知。没有任何单一机制能全覆盖。
还有一个理由:计量每一次阻断。guardrail_blocks_total{layer, rule} 是生产健康度最敏锐的信号之一。数值飙升意味着攻击、回归或错误部署——直接告警。
反模式清单:
- Fail-open:比没有护栏更糟糕——制造虚假安全感。
- 单层全能:不可维护。
- 模型可绕过的护栏(prompt 中写"请勿做 X"):不是护栏——应通过约束输出空间(enum/schema)让禁止行为根本无法表示。
- 静默阻断:无法区分攻击与 bug。
- 注意 Layer 3 的最后一项职责——清洗模型回显的 PII,这正是与下一项 discipline 的自然交接点。
敏感数据的边界处理
AI 系统对数据异常饥渴——需要丰富上下文才能良好推理,同时又会对每个决策生成记录。这与一项基本义务产生冲突:不要囤积不需要的敏感个人数据。解决方案是在边界处理 PII——入口出口双向清洗,绝不让原始敏感数据沉淀到存储、日志或模型流量中。
去标识应基于声明式的分类策略驱动,而非散落在代码各处的 if field == "email" 判断。
class Sensitivity(Enum):
 PUBLIC = 0
 INTERNAL = 1
 PII = 2
 SECRET = 3
FIELD_POLICY = {
 "name": Sensitivity.PII,
 "email": Sensitivity.PII,
 "card_number": Sensitivity.SECRET,
 "amount": Sensitivity.INTERNAL,
 "category": Sensitivity.PUBLIC,
}
数据在组件间流动的每一个位置都是边界——进入系统、进入模型、进入账本、进入日志、输出到外部服务。在每个边界都要问:**跨边界的数据是否真的需要原始敏感数据?** 通常答案是否——在跨边界前完成去标识、掩码或哈希。
inbound ─▶ [scrub] ─▶ working set ─▶ [scrub] ─▶ model
 ├─▶ [redact + hash] ─▶ ledger(无原始 PII)
 └─▶ [redact] ─▶ logs(无原始 PII)
账本边界需要特别关注:需要证明"基于什么做出决策",而非保留原始敏感载荷。存储哈希值加上去标识摘要,日后重新哈希以证明等价性——可验证性与责任分离并行。
数据边界:脱敏与边界守卫
两个核心决策点:哈希与规范 JSON
有两个设计决策一旦敲定就要贯穿全局,不能各行其是。
第一,密钥化哈希(HMAC)用于低熵字段。 用 KMS 中的租户密钥对 16 位数字这类低熵字段做 HMAC,而不是直接 SHA-256——因为裸 SHA-256 在这类场景下是可逆的。第二,统一规范 JSON(RFC 8785 / JCS)。 键排序、统一 Unicode 归一化、固定数字格式——所有审计账本的哈希链都依赖重新哈希后产生完全一致的字节序列。
模型也是外部边界:Prompt 脱敏与输出清洗
大模型通常是第三方,对它不必要推理的敏感字段要在 Prompt 中彻底剔除;模型输出在持久化或返回前也要清洗,因为模型会"回声"输入——正好复用上面第三层(脱敏)的逻辑。
失效模式:不能留"大多数地方脱敏"的侥幸
一旦出现"我们在多数地方做了脱敏"这种情况,泄露就以更隐蔽的方式发生了。正确的做法是:让脱敏成为跨过每个边界的唯一路径,从机制上防止开发者遗忘:
ledger.append(ledger_view(raw, tenant_key))
log.tier2(redact(event))
从设计之初就考虑数据驻留与访问控制
敏感数据天然携带约束:存放位置、可读人员都有规定——租户级密钥、受监督&管理层级区域锁定存储、访问门控审计读取。等数据已经散落各处再回头补救,是真正的噩梦。 还有一类更隐蔽的泄露方向:横向渗透——一个用户的上下文流向了为其他用户做决策的组件。这种问题的根因在结构层,需要在记忆模型层面解决。
不可篡改审计账本:append-only 设计实践
为什么需要审计账本,而不是日志
当有人第一次问"为什么系统在三月份对 X 案例做出那个决定?"时,你才能真正检验自己建的是审计轨迹还是仅仅有日志。日志是用来调试的——会轮转、无结构、不是权威记录。 审计账本才是每项决策及其理由的规范、只增不改、防篡改的权威记录。任何有实质性影响的系统,这都不是可选项。 关键表结构如下:
CREATE TABLE decision_ledger (
 decision_id TEXT PRIMARY KEY,
 ts TIMESTAMPTZ NOT NULL,
 tenant_id TEXT NOT NULL,
 identity TEXT NOT NULL,
 capability TEXT NOT NULL,
 inputs_hash TEXT NOT NULL,
 inputs_summary JSONB NOT NULL,
 model_version TEXT NOT NULL,
 prompt_version TEXT NOT NULL,
 decision JSONB NOT NULL,
 confidence REAL,
 routing TEXT NOT NULL,
 outcome JSONB,
 supersedes TEXT REFERENCES decision_ledger(decision_id),
 seq BIGSERIAL,
 prev_hash TEXT,
 entry_hash TEXT NOT NULL
);

REVOKE UPDATE, DELETE, TRUNCATE ON decision_ledger FROM app_role;

GRANT UPDATE (outcome) ON decision_ledger TO app_role;
设计一:append-only——纠错用新行,不改旧行
修正不是覆盖,而是插入一条指向旧记录的新记录。例如: seq 1041 decision=approve conf=0.91 supersedes=NULL seq 1207 decision=reject conf=NULL supersedes=< id of 1041> reason="manual review" 历史即真相——哪怕某条旧记录记忆模糊,它也不会悄然变成错误,而是以"已被取代"的姿态清晰可见。数据库层面强制执行(REVOKE UPDATE/DELETE),因为"我们承诺不更新"不是真正的 append-only。
设计二:哈希输入而非存储原文——证明事实,不做仓库
复用前文 ledger_view 的思路:存储哈希 + 脱敏摘要,通过重新哈希比对来证明某项决策基于特定输入做出。"为完整起见存一份完整敏感载荷"只会建一个攻击蜜罐。
设计三:哈希链——密码学级别的防篡改
"只增不改"是规范约束,变成密码学保障需要哈希链:
import hashlib
IMMUTABLE = (
 "decision_id", "ts", "tenant_id", "identity", "capability",
 "inputs_hash", "inputs_summary", "model_version", "prompt_version",
 "decision", "confidence", "routing", "seq", "supersedes"
)
GENESIS = "0" * 64
def _h(payload: dict) -> str:
 return hashlib.sha256(canonical_json(payload).encode()).hexdigest()
def seal(row: dict, prev_hash: str) -> dict:
 row["prev_hash"] = prev_hash
 row["entry_hash"] = _h({
 "row": {k: row[k] for k in IMMUTABLE},
 "prev": prev_hash
 })
 return row
哈希链防止篡改——改动任意一行,后续所有 `entry_hash` 立即不匹配。但它无法阻止截断(删除尾部)或从创世块开始的完整重写。因此验证方需要额外检查:seq 连续性 + 已知 GENESIS 值;对有 DB 写权限的运维层威胁,还要用独立签名者持有的非对称密钥对每个 `entry_hash` 签名,并将定期签名的检查点发布到外部存储。**REVOKE 挡住应用层,写入签名加锚定才挡住有 DB 写权限的人。**
def verify_chain(rows):
prev, expect = GENESIS, None for r in sorted(rows, key=lambda r: r["seq"]):
if expect is not None and r["seq"] != expect:
return expect if r["entry_hash"] != _h({ "row": {k: r[k] for k in IMMUTABLE}, "prev": prev }):
return r["seq"] prev, expect = r["entry_hash"], r["seq"] + 1 return None
写入原子性:加锁 append
读尾部的 entry_hash(SELECT … FOR UPDATE 或咨询锁)和 INSERT 必须放在同一事务中,否则并发 append 会在同一 prev_hash 上分叉,破坏链的连续性。
账本的查询场景示例
追溯决策血缘关系(包含被取代的旧记录):
WITH RECURSIVE lineage AS (
 SELECT * FROM decision_ledger WHERE decision_id = $1
 UNION
 SELECT d.* FROM decision_ledger d
 JOIN lineage l ON d.decision_id = l.supersedes OR d.supersedes = l.decision_id
)
SELECT * FROM lineage ORDER BY seq;
统计过去一周各能力维度的自动路由比例:
SELECT capability, avg((routing = 'auto')::int) FROM decision_ledger WHERE ts > now() - interval '7 days' GROUP BY capability;
账本:决策追踪的核心支柱
账本是整个系统的脊柱,而非可有可无的副产品。分析、漂移检测、覆盖率和调试都依赖账本数据,每条记录通过 decision_id 与其调用链绑定。因此,必须将账本写入作为每个决策流程的最后一个节点无条件执行——绝不能出现"队列满时跳过账本记录"这类逻辑,否则系统出问题时,审计数据恰好就会出现缺口。
多租户 Agent 的内存模型
当 Agent 同时服务多个客户,甚至多个用户时,"内存"就不再只是一个功能特性,而是一道数据治理问题——披着功能外衣的风险。
一个不加区分的统一内存存储,就是将 PII 区域横向泄露变成了具体的事故:跨租户数据暴露迟早会发生,而这类审计你根本过不了。解决方案不是换一个更花哨的向量数据库,而是构建类型化内存模型——每类内存有明确的分类名称,并附带作用于存储边界、代码级别强制执行的写入规则。
以下是一个参考分类枚举:
from enum import Enum
class MemoryCategory(Enum):
 TENANT_SHARED = "tenant_shared"
 AGENT_NAMESPACE = "agent_namespace"
 WORKFLOW_CONTEXT = "workflow_context"
 AUDIT = "audit"
 SEMANTIC_KNOWLEDGE = "semantic_knowledge"
 CONVERSATION = "conversation"
重点不在于这六类本身,而在于**每个数据项必须归属且仅归属一个类别,类别本身决定访问规则**。对于每个类别,需在代码中明确锁定以下三项规则,而非仅写在文档里:
| 类别 | 作用域(分区键) | 可读权限 | 是否可含 PII |
|------|-----------------|---------|------------|
| TENANT_SHARED | tenant | 租户内任意调用方 | 否 |
| AGENT_NAMESPACE | tenant | 仅系统 | 否(禁止原始 PII) |
| WORKFLOW_CONTEXT | invocation | 仅本次调用 | 否 |
| AUDIT | tenant | 仅 audit 角色 | 仅允许哈希/脱敏数据 |
| SEMANTIC_KNOWLEDGE | global / tenant | 仅系统 | 否(禁止用户 PII) |
| CONVERSATION | user + session | 仅对应用户自身 | 是,但严格隔离 |
**租户隔离是不可妥协的底线**:每次读写都携带 `tenant_id`(在用户级类别中还需 `user_id`),在存储层强制校验,跨租户访问直接抛出硬错误。
实现示例:
@dataclass class Caller:
tenant_id: str user_id: str | None = None role: str | None = None def partition_key(category, tenant_id, *, user_id=None, session_id=None, invocation_id=None) -> str:
C = MemoryCategory if category is C.WORKFLOW_CONTEXT:
assert invocation_id, "workflow context is invocation-scoped" return f"{category.value}:{tenant_id}:{invocation_id}" if category is C.CONVERSATION:
assert user_id and session_id, "conversation is per-user, per-session" return f"{category.value}:{tenant_id}:{user_id}:{session_id}" if category is C.SEMANTIC_KNOWLEDGE:
return f"{category.value}:{tenant_id or 'global'}" return f"{category.value}:{tenant_id}" def read(category, *, tenant_id, key, caller: Caller, user_id=None, session_id=None, invocation_id=None):
enforce_access(category, tenant_id, caller, user_id) return store.get(partition_key(category, tenant_id, user_id=user_id, session_id=session_id, invocation_id=invocation_id), key) def enforce_access(category, tenant_id, caller: Caller, user_id):
if caller.tenant_id != tenant_id:
raise Forbidden("cross-tenant access") if category is MemoryCategory.AUDIT and caller.role != "audit":
raise Forbidden("audit memory is role-gated") if category is MemoryCategory.CONVERSATION:
if user_id is None or caller.user_id != user_id:
raise Forbidden("conversation memory is per-user") def write(category, *, tenant_id, key, value, caller: Caller, user_id=None, session_id=None, invocation_id=None):
enforce_access(category, tenant_id, caller, user_id) if category in (MemoryCategory.TENANT_SHARED, MemoryCategory.AGENT_NAMESPACE) and contains_pii(value):
raise Forbidden(f"{category} must not hold personal data") store.put(partition_key(category, tenant_id, user_id=user_id, session_id=session_id, invocation_id=invocation_id), key, value) 防止尴尬泄露的关键防火蔷是 CONVERSATION 类别:用户 B 的决策 Agent 绝对不能读取用户 A 的对话记录。将其独立成单独类别,仅在 A 自己的会话内可读,且永不注入共享决策路径。这道边界能结构性杜绝"为什么 AI 会知道关于我的这些信息"这类投诉——也是应对前文所述横向泄露的结构性解决方案。
尽早测试最怕发生的泄露场景
测试应在边界层进行,而非对序列化后的上下文做字符串搜索(base64 或 embedding 形式的数据会轻松绕过子串匹配):
def test_no_cross_tenant_read():
 write(MemoryCategory.TENANT_SHARED, tenant_id="A", key="policy", value="x", caller=Caller("A"))
 with pytest.raises(Forbidden):
 read(MemoryCategory.TENANT_SHARED, tenant_id="B", key="policy", caller=Caller("A"))
def test_conversation_firewalled_to_owning_user():
 write(MemoryCategory.CONVERSATION, tenant_id="A", user_id="u1", session_id="s1", key="msg", value="secret", caller=Caller("A", user_id="u1"))
 with pytest.raises(Forbidden):
 read(MemoryCategory.CONVERSATION, tenant_id="A", key="msg", user_id="u1", session_id="s1", caller=Caller("A", user_id="u2"))
即使当前仅做单租户设计,按照这种方式构建,后续迁移多租户时只需改配置,无需重写代码。
反模式:需要刻意避免的做法
- 统一无分类存储:无类别、无规则,泄露只是时间问题
- 在应用层"通常"做过滤:应在每次访问的存储边界强制执行,而非依赖应用层逻辑
- 在 shared/namespace 内存中存放原始记录:这些是抽象层——写入时需校验
- 清空内存时误删结构化知识:这正是前文要强调的接缝问题——系统不仅遗忘学到的内容,还遗忘自己的身份
种子记忆 vs 运行记忆:系统自带的是什么,自己积累的又是什么
这里有一种反复出现的典型 Bug:有人执行"清空内存"或"重置"操作来清除积累的状态,结果把系统赖以运行的提示词、规则和参考数据也一并删除了。系统回来时变成了失忆症患者——不仅忘记了学到的东西,还忘记了自己是什么。
状态化 AI 系统的两类数据:Seed 与 Runtime
任何有状态 AI 系统中,存在两种本质完全不同的数据,它们在存储、版本管理和生命周期处理上应当区分对待:
- Seed(种子数据):即"交付物",包括提示词及版本、决策规则与策略、黄金数据集与评估基线、检索增强用的 grounding 数据。这些由人工编写、受版本控制、跟随部署包走,且运行中的系统不得修改它。
- Runtime(运行时数据):即"系统挣来的",包括审计账本(ledger)、学到的记忆、漂移信号、异常事件、会话上下文。这些是运营的副产物,可变且大多可丢弃——清空后系统仍能正常运行,回到基线行为,因为它的身份根植于 seed。
目录结构:把分界编码进去
seed/ prompts/ rules/ golden_sets/ grounding/ runtime/ ledger/ memory/ drift/ sessions/
关键功能:带作用域的清空
最有用的单一函数是"作用域清空"(scoped reset)。注意,守卫必须用真实异常(raise),而非 assert——生产环境以 -O 运行时会丢弃 assert,导致 seed 被悄悄清空:
def clear_state(scope: str):
 if scope != "runtime":
 raise ValueError("refusing to clear seed — seed is shipped config, not state")
 for area in ("memory", "drift", "sessions"):
 storage.purge(f"runtime/{area}")
注意,即使在 runtime 内部,ledger 本身也会保留——它是早前的审计记录。只清空 memory 和 sessions,不动历史。
> ⚠️ 前提条件:"清空 runtime 后行为回到 seed 基线"这一假设,学到的记忆必须是加性上下文,而非决策的承重输入——请在系统文档中明确声明这一假设。
Runtime 信号如何安全地进入 Seed
新行为不得从 runtime 偷偷潜入系统运作方式。 所有 validated runtime 信号必须通过一道刻意审核&查验步骤才能晋升为 seed: runtime signal(例如:某模式反复出现,人类持续以相同方式纠正 X) └─▶ candidate(提出变更:新的提示词 / 规则 / 黄金用例) └─▶ review + eval gate(评估:是否提升质量且不回退基线?) └─▶ merged into seed/ → 在下一版本中交付 系统运行时不自行编辑自己的 seed——那将是无版本控制、无审核&查验、不可复现的行为变更。
学习是一条 PR,而非副作用。 这道分界让难题变得简单:重置只清 runtime,seed 分毫不变;所有 seed 变更必经审核&查验和评估门控;seed 驱动的行为给定输入即可复现,而学到的知识则不然;新行为永远来自经晋升的 runtime 信号,经由审核&查验而非从 runtime 直接映射到行为。
核心结论
安全与治理在这一层级不是事后叠加的功能,而是需要架构层面安排的设施,且四个组件相互强化:
- 护栏(Guardrails):在单一契约下组合,失败时关闭,单次失败即触发捕获。
- PII 处理:在各边界清洗并哈希存储,AI 需要的丰富上下文积累,但不保留原始敏感数据。
- 审计账本:只追加、防篡改,作为每个决策的最终无条件步骤写入。回溯"三月为何那样做"只需查询一行,且可验证溯源。
- 记忆分型与作用域:一个租户或用户的数据在结构上无法流向另一方的决策,从根本上杜绝横向泄露。
- Seed/Runtime 分界:使整个体系可重置、可复现,学习流经审核&查验而非原地变异行为。
把这套机制在 Level 4 构建好,系统将成为你能在审计时底气十足交付的东西——而非事后只能道歉的东西。
- Running LLM systems in production — Level 4 of 6: Safety & governance
评论