

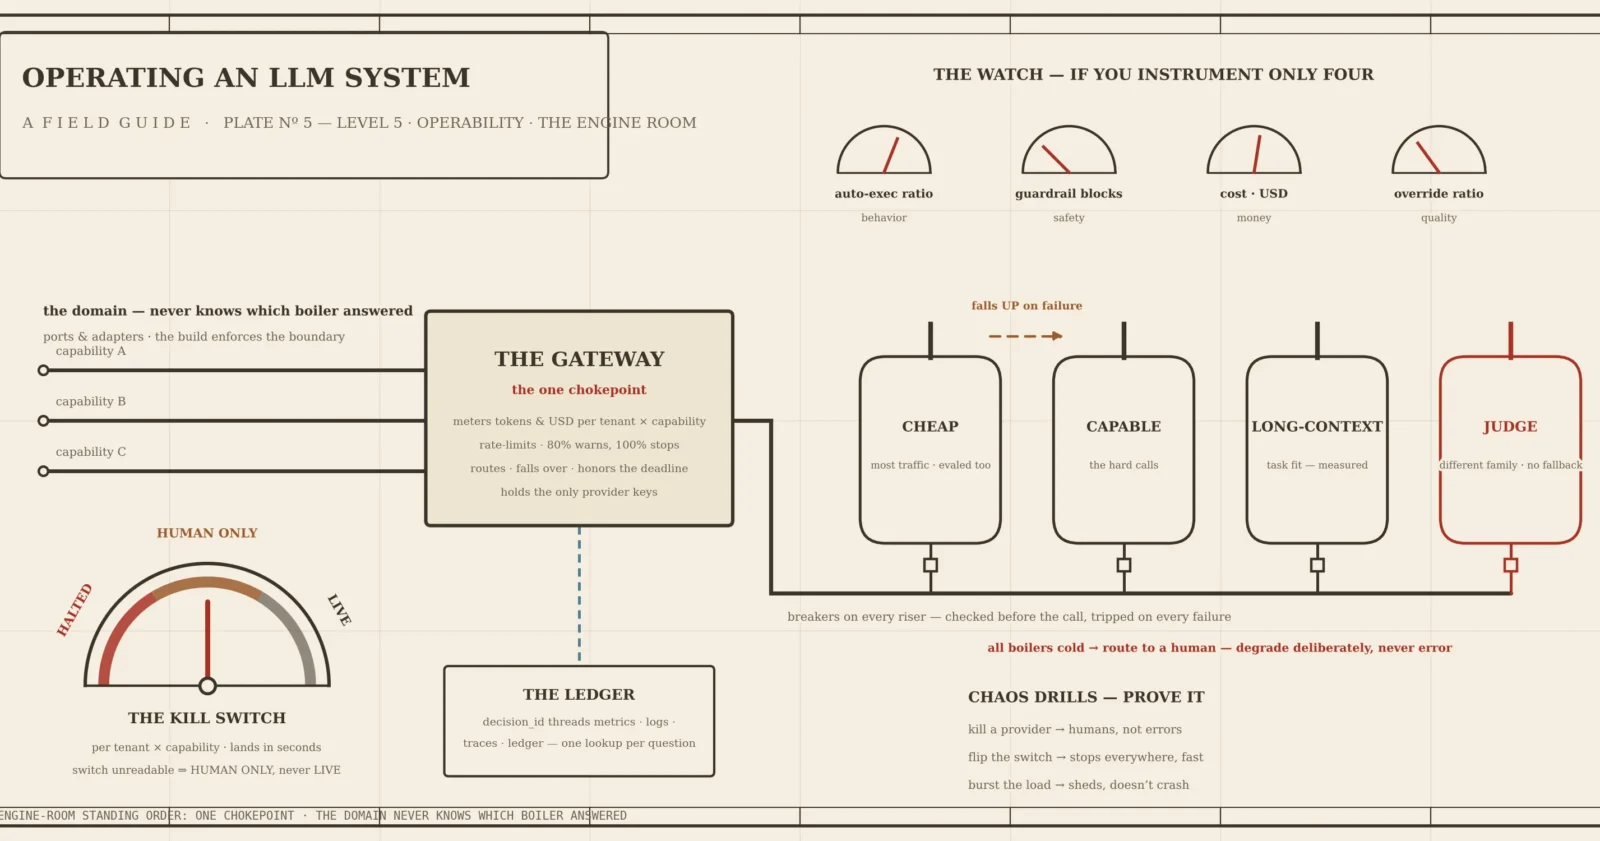
本文是 LLM 生产系统六层成熟度模型的第五级。前几级主要解决系统「能不能跑」和「跑得对不对」的问题,而第五级关注的是可操作性:能否日复一日地运行系统、看清模型每一次决策、控制成本、在供应商故障时快速切换、在模型行为异常时秒级熔断——以及底层平台是否围绕这些能力而构建。
传统微服务出故障时返回 500 错误。LLM 系统出故障则可能以极快速度大规模执行错误操作。这种不对称性决定了可操作性不是锦上添花,而是「能跑」与「只能靠祈祷」的本质差别。
本篇是整个系列最长的一篇,因为可操作性这一层涉及最多移动部件。核心设计理念却很简洁:一个模型流量的总闸口、一个贯穿所有环节的 decision_id、以及下游业务域永远不需要知道是谁回答的。
观察决策,而非只观察服务
传统可观测性指标——请求量、延迟、错误率、CPU——只能告诉你服务在不在线,但无法告诉你 AI Agent 实际工作质量如何。你需要建立一套专门针对 AI 的第二层信号机制,配合可操作的 Schema 和阈值。
RED 指标 + 决策层
保留服务层惯用的 RED 指标(Rate、Errors、Duration),在此基础上新增决策层,将每一次 Agent 决策视为第一等的可测量事件。以下命名遵循 Prometheus 规范(_total 计数器、_bucket 直方图),所有序列均携带 tenant_id 和 capability 标签(表中省略,使用时默认携带)。注意:若在直方图上添加 per-tenant_id 标签, tenant 数量超过几百后会引发基数爆炸;建议对 tenant 数量设上限,或将 per-tenant 聚合迁移到 recording rules 或 exemplars。
| 指标类型 | 指标名 | 标签 | 用途 |
|---|---|---|---|
| Counter | agent_decisions_total |
outcome(auto / hitl_recommended / hitl_required / reject / abstain) |
决策总量及自动/人工分流比 |
| Gauge | agent_auto_execution_ratio |
— | 无需人工介入的处理比例 |
| Histogram | agent_decision_confidence |
— | 组合置信度分布 |
| Histogram | agent_decision_duration_seconds |
node |
各图节点的延迟 |
| Counter | guardrail_blocks_total |
layer(input / output / pii)、rule |
各层被拦截的内容及规则 |
| Counter | judge_invocations_total |
— | judge 模型调用次数(比率分母) |
| Counter | judge_disagreements_total |
— | judge 与主模型意见分歧次数 |
| Counter | llm_tokens_total |
direction(in / out)、model |
token 消耗量 |
| Counter | llm_cost_usd_total |
model |
按 tenant/capability 汇总的花费 |
| Histogram | llm_call_duration_seconds |
model、outcome |
模型延迟(独立于服务层) |
| Gauge | shadow_eval_pass_ratio |
slice |
抽样生产流量的线上质量 |
| Gauge | human_override_rate |
— | 人工干预率 |
四大指标族:决策(量、分流比、置信度、延迟)、安全(guardrail 拦截、judge 分歧)、成本/性能(token、花费美元、模型延迟)、质量(影子评估、人工覆盖)。若只选四个指标重点建设,选择顺序是:agent_auto_execution_ratio(行为)、guardrail_blocks_total(安全)、llm_cost_usd_total(资金)、human_override_rate(质量)。
结构化日志:三档分级
不要把所有日志灌入同一个日志流。按敏感度分级处理,因为部分数据受监督&管理约束,且大多数告警只需查询第一档。
第一档——运营日志(任意环境安全,高容量):时间戳、日志级别、decision_id、tenant_id、capability、node、duration_ms、outcome。这是告警查询的数据源。
第二档——决策元数据(在信任边界内,接近审计记录):模型名称、prompt_version、composed_confidence、路由决策、judge 结果、guardrail 操作、inputs_hash,以及一份去敏感化(不含 PII)的摘要。
第三档——受监督&管理/原始数据(加密、访问控制、不进入通用日志库):敏感 payload,仅在你决定保留时使用——通常做法是在第二档存储 hash + 去敏感摘要,完全跳过第三档。
原则:一档和二档对工程师可查询,三档进入保险箱。所有三档日志通过同一个 decision_id 关联,也关联下方 trace,实现任意决策的端到端重建。
追踪决策图
普通 trace 展示 HTTP 请求在服务间的流转。Agent trace 还需跨越内部图结构,以便看清哪一步失败、各步耗时多少: span: agent.decision attrs: decision_id, tenant_id, capability, outcome, confidence ├─ span: entry │ attrs: identity, auth_type ├─ span: context_load │ attrs: slices_loaded, cache_hit ├─ span: llm_decision │ attrs: model, prompt_version, tokens_in, tokens_out, cost_usd ├─ span: output_guardrail │ attrs: blocks[], pii_actions[] ├─ span: judge │ attrs: ran, model, agreed(仅在采样时出现) ├─ span: routing │ attrs: decision=auto|hitl|reject, threshold └─ span: exit attrs: ledger_entry_id 有了这套 trace,「为什么决策 X 耗时 4 秒/被拒绝?」变成一次 trace 查询即可回答。
按症状告警,设置真实阈值
告警对象是影响用户或业务的现象,而非根因。推荐告警配置如下:
| 告警名称 | 条件 | 级别 |
|---|---|---|
| AutoExecutionSwing | auto_execution_ratio 较 7 天基线波动 >15% |
warning |
| GuardrailBlockSpike | rate(guardrail_blocks_total[5m]) 超过过去 1 小时均值 3 倍 |
critical |
| JudgeDisagreementHigh | rate(judge_disagreements_total[1h]) / rate(judge_invocations_total[1h]) > 0.15 |
critical |
| CostCeiling | increase(llm_cost_usd_total[1h]) 超过日预算的 1/24 |
warning→page |
| ShadowEvalDrop | shadow_eval_pass_ratio < 0.95 |
critical |
| ModelLatencyP99 | llm_call_duration_seconds p99 在 10 分钟内持续 >8s |
critical |
安全和质量类告警触发 page(通知),其余仅生成工单。决策系统应设置有实际意义的 SLO:决策可用性(≥ 99.9% 的决策返回提案——决策失败才是真正的故障,而非返回 5xx)、质量(影子评估通过率 ≥ 基线 − 2%,滚动 7 天)、延迟(排除人工时间后 p95 低于交互预算)、成本(每千次决策美元花费在计划的 ±20% 以内)。
LLM 可观测性的三个反模式
在生产环境中跑 LLM 应用,有三个问题反复出现,却很少被明确命名:
- 用单一日志流处理所有事件——第三层级(tier-3)的调试日志混入可搜索日志,既浪费存储,又带来合规风险。
- 将模型自我报告的置信度作为指标——模型对自己的判断往往过度自信,需要跟踪组合置信度并用实际结果验证。
- 缺少 decision_id——没有决策追踪,每一次复盘都变成考古。
这三点看似小事,却是团队后期深陷泥潭的常见根源。
在流量入口控制成本
LLM 成本有一个恼人的特性:看不见,直到账单来了才知道。而费用增长往往藏在没人监控的地方——每次调用的 token 数、每个请求的调用次数、重试次数、某人悄悄加进去的冗长提示词。很多团队发现单位经济模型已经颠倒时,产品已经上线了。
解决方案不是换更便宜的模型,而是建立一套结构性控制机制,让成本可见且有上限。这些控制都挂在同一个"咽喉点"上。
测量从强制执行点开始
你无法控制看不见的东西。如果模型调用分散在代码库各处,成本就成了一笔糊涂账。正确做法是将所有调用统一路由到网关组件,由网关统一测量和强制执行。
此时,成本可以按租户 × 能力 × 模型归因——这才是找出钱花在哪里的正确视角,通常会发现是某个"话多"的能力或某个超长的提示词在烧钱,而不是笼统的"用太多 AI"。
成本杠杆,按收益排序
以下是按投入产出比排列的优化手段: 不调用模型——将简单、确定性的 case 走代码规则。这往往是收益最大的杠杆,因为很多所谓"AI 成本"实际上是模型在做本该规则搞定的事。
批量处理——N 条记录一次调用,而非 N 次调用。减少往返次数,每条成本更低。
缓存——确定性结果(嵌入向量、重复查询)做记忆化存储。最便宜的调用是跳过的调用。
模型选型匹配——简单决策用便宜模型,复杂决策用强模型。多数流量是简单 query,多数成本却花在高端模型上,这个错配很大。
精简提示词——只加载必要上下文,删除"以防万一"的前置说明。每次调用都在为此付税。
值得特别说明的是"模型选型匹配":它直接决定了路由策略——如果便宜模型通过评估测试,就把它路由到对应场景,单次调用成本差 5–20 倍很常见。算清这笔账(cost = tokens_in/1k × price_in + tokens_out/1k × price_out)而不是靠猜。
预算、限速与静默倍增器
为每个租户设置费用上限和速率限制,且状态在所有副本间共享——无状态 worker 池无法用本地内存独立执行单租户限制,否则每个副本都会放行自己的那一份。
同时设置平台级别的总上限——否则 N 个租户 × 每人限额加起来没有总量约束。
还要警惕两个悄悄把账单放大 10 倍的因素:
- 重试风暴:不稳定的验证逻辑反复回调模型。
- 无界工具循环:智能体持续运行停不下来。
对两者都要设置上限,并暴露 llm_retries_total{reason} 指标,让风暴可见。
LLM 成本本身并不高,只是本质上缺乏监控。在咽喉点做好监控,账单就会与价值成正比。
提速且不牺牲质量
成本与延迟往往有共同根源:一个需要几分钟的 pipeline,通常不是因为模型慢,而是因为 O(n²) 循环、逐条记录的往返调用或串行阶段——这些老问题现在裹上了 LLM 的外壳。
优化前的铁律
规则 0:锁定质量基线再动手。性能优化有风险,因为最快版本往往暗中降低了正确性。要先建立基线——代表性数据集、当前输出、关键质量指标——然后每次改动后重新跑。不允许任何导致基线回归的优化。
规则 1:看数据,不要猜。一个匹配 10,000 × 10,000 条记录的 pipeline"感觉"是模型瓶颈,但一 profiling 就发现 90% 的时间耗在一个做了一亿次比较的嵌套循环里。模型根本不是问题所在。
常见性能问题,按收益排序
O(n²) 匹配循环 → 改为一次建索引后用哈希/键连接查找:约一亿次比较变成约两万次操作。
逐条记录模型/网络往返 → 批量处理,或对简单 case 跳过模型(partition(rows, is_deterministic),简单的走规则,难的批量调用一次模型)。这是成本部分"不调用模型"杠杆的二次收益。
可以并行却串行的阶段 → 有限并发,并发数匹配真实约束(提供商速率限制、CPU、内存),不要无界——无界只是把瓶颈移了位置并冲破限制。
重复计算 → 缓存确定性工作(嵌入向量、解析后的输入、参考查询结果)。
每次改动后,同时重新跑两个维度的验证——延迟基准测试和与基线的质量对比。任何导致质量回归的改动都要回滚,无论速度提升了多少。
兜底策略:模型不可用时的降级路径
当主模型所在服务商出现故障时,系统需要有预建的兜底链路。核心思路是为不同请求类型规划好备用模型顺序,并配备断路器防止雪崩。
路由链设计遵循能力分层原则:判断类请求优先走专用 Judge 模型;低风险任务(如批量生成)走廉价模型并串联备用能力模型;高风险任务则先用能力最强的模型,再用保底模型兜底。
def route_chain(req):
 if req.is_judge:
 return [JUDGE_MODEL]
 if req.stakes == "low":
 return [CHEAP_MODEL, CAPABLE_MODEL]
 return [CAPABLE_MODEL, FALLBACK_MODEL]
实际调用时,完整超时管理是关键:用全局截止时间减去当前时间得出剩余预算,动态分配给每次尝试,而非用固定超时逐个重试——后者会让总延迟变成 N 倍超时,直接撑爆上游资源池。此外,幂等性(idem_key)是必选项:主模型若已超时但实际完成了写入操作,不能被兜底模型重复处理。
**断路器逻辑**有几个常见错误点需特别注意:断路器状态检查应发生在调用之前,且每次捕获到的异常(Timeout、ProviderError)都必须记录失败次数——常见的 bug 是把成功和失败记录都写在 except 块里,导致断路器无法主动跳过已宕机的 provider。
一个原则贯穿路由与兜底:**路径上的每个模型都必须经过评估**。便宜模型和备用模型在其负责的能力维度上,同样需要通过 golden set 验证质量。若兜底模型悄悄拉低了输出质量,那它造成的停机比它所掩盖的故障更严重。账本中应记录是哪个模型做出的决策,方便后续分析该便宜模型或备用模型是否发生了降级。
熔断器与 kill switch:秒级生效的安全开关
熔断器:避免级联故障
在依赖服务不可用时,熔断器的作用是让失败在毫秒级内发生,而非堆积在 60 秒超时后面——后者正是依赖故障演变为线程耗尽故障的典型路径。超载时应主动卸压:降速或路由到人工,而不是直接崩溃。系统能降级到"人工处理"状态,说明它仍在履行使命。
Kill switch:秒级全量生效的关闭开关
发布一次上线需要数分钟,而紧急情况可能等不了那么久。Kill switch 必须是运行时状态,所有节点实时检查:
class Mode(Enum):
LIVE = "live"
HUMAN_ONLY = "human_only"
HALTED = "halted"
def get_mode(switch, tenant_id, capability) -> Mode:
raw = switch.read(f"killswitch:{tenant_id}:{capability}") \
or switch.read(f"killswitch:{tenant_id}") \
or switch.read("killswitch:global")
return Mode(raw) if raw else Mode.LIVE
可靠 kill switch 的四个设计要点:
- **快速传播**:依赖共享状态或 pub/sub 机制,确保开关切换在秒级内覆盖所有实例。30 秒本地 TTL 不算"秒级"。
- **细粒度控制**:支持按租户和按能力分别设置关闭范围,使"关闭"的爆炸半径与问题本身的半径相匹配。
- **中间档位**:`HUMAN_ONLY` 模式允许系统继续生成方案但停止自动执行——很多时候并不需要完全关闭,而是需要让人重新介入流程。
- **默认安全**:节点若无法读取开关状态,默认进入保守模式。降级设计 + 混沌验证
提前规划系统在压力下的形变方式,才能避免故障级联。混沌测试是对这些机制真实有效性的唯一验证手段,必须覆盖以下场景:
- 主模型服务商宕机 → 决策路由到人工,不报错误
- Kill switch 翻转 → 自动执行立即停止,且全实例快速生效
- 突发过载 → 卸压或降级,不崩溃、不重启
- 决策进行中节点故障 → 幂等恢复或安全失败
- 依赖延迟激增 → 断路器触发,无线程堆积
如果从未在真实故障条件下演练过 kill switch 和兜底机制,就无法确认它们真的有效——只是在心存侥幸。Kill switch 才是让你安心睡觉的东西。
底层平台:六边形架构与统一网关
上述所有机制的前提,是一个允许随时替换模型而不必重构的架构基础,以及一套保持每个操作可追溯的身份模型。
六边形架构:让供应商代码远离业务域
你所交付的模型不会是最初选择的模型。供应商每隔数月就会互相超越,价格策略会调整,区域或合规要求会迫使切换。如果业务逻辑中散布着供应商 SDK 导入和供应商格式的请求对象,每一次切换都是一次重构。
解决方案是将经典的分层思想应用到新场景:端口与适配器(Ports & Adapters)。业务域只依赖端口——即由你自己定义、用你自己的术语描述的接口。外部的混乱(模型供应商、数据存储、消息队列)都存在于实现这些端口的适配器中。业务域代码绝不直接导入供应商 SDK。
统一网关:所有模型流量的唯一入口
定义一个用你的词汇表描述所有模型交互的网关:
@dataclass(frozen=True)
class ChatRequest:
 messages: list[dict]
 schema: dict | None = None
 max_tokens: int = 1024
class LLMGateway(Protocol):
 def complete(self, request: ChatRequest) -> ChatResponse: ...
这个网关同时承担成本计量、限流、路由、兜底和 kill switch 等所有横切关注点——只在一处存在,不分散各处。这并非巧合:让业务域可移植的流量咽喉,正是让系统可运维的咽喉。由于业务域依赖的是 Protocol,测试时可以直接注入 fake——无需网络、不产生费用、无抖动——而适配器则通过集成测试对接真实服务。
用 Linter 守住架构边界
不要依赖开发者的警觉来维护模块边界,而要用 linter 强制执行。定义一条导入契约规则(例如"domain 层不得导入 vendor SDK"),一旦有人把 vendor 依赖塞进 domain 代码,构建立刻失败。
配合命名约定一起使用:凡在 adapters/ 下、或带有特定 provider 后缀的模块可以导入该 provider,其他模块一律禁止。大多数生态都有对应的工具——JS/TS 的 module-boundary lint、Java 的 ArchUnit、Go 的 depguard。
代价是额外的抽象层和前期接口设计工作,收益是:单文件级别替换 provider、domain 层可测试、边界由构建系统永久维护。届时"能不能换模型"就不再是一个项目,而是一个下午的事。
身份与授权:每个操作携带谁的权限
Agent 以用户名义行动时,面临一个身份问题——这是无状态的 API 所没有的。一个请求以用户身份到达,Agent 推理、调用下游服务,可能运行较长时间,甚至在用户离开后继续工作。每一跳都要问:当前运行持有的是谁的授权?该用户、该租户是否被允许执行此操作?处理不当就会陷入经典的"混淆副手"问题——Agent 用自身宽泛的权限做了用户做不到的事。
两种场景,两种策略: 短时同步(< 约 60 秒):传播用户凭证——入站 token 沿链路传递到下游调用,每一步都用用户本人的授权执行(前提是每个下游服务都独立做操作级授权)。
长时 / 延迟任务:无法持续持有用户 token。在入口节点签发一个短命的委托授权——非对称签名、作用域限定于当前工作流、代表用户、绑定单一受众和租户、最小权限精确匹配作用域、可撤销 ID、TTL 以小时计并设硬性上限。
最关键的检查——在每一跳都要做——是身份所属租户与请求所属租户是否匹配: def authorize(token: str, request):
identity = verify_grant(token, expected_aud=THIS_SERVICE, leeway_s=30) if identity.tenant_id != request.tenant_id:
audit.violation("cross_tenant", identity=identity, request=request) raise Forbidden if request.action not in identity.scope:
raise Forbidden(f"out of scope: {request.action}") return identity 这道检查阻止了一个租户的 Agent 访问另一租户的数据——即便通过 bug 或提示词注入。非对称签名(共享 HMAC 密钥会让任何持有者都能签发授权);最小权限 + 短 TTL(泄露短命授权是小问题,泄露长命授权则是事故);每一跳都验证(注入发生在边界之后);跨租户拒绝日志记为审计违规——这是攻击信号,不是静默的 403。
所有机制的核心目标:Agent 做的每一件事都可归因、作用域精确、边界限定在它本应服务的用户和租户。
基础设施:搭好骨架,拒绝技术崇拜
搭建 Agent 平台容易陷入两种失败模式:供给不足(无审计存储、无密钥管理、一个共享的超权凭证)或过度建设(为几个无状态服务配备消息队列、三个数据库和服务网格)。实际清单:
| 组件 | 为什么起步就要 | 备注 |
|---|---|---|
| Agent 服务 | 能力核心 | 少量无状态服务,可自动扩缩容 |
| 模型网关 | 唯一持有 provider 凭证的卡点 | 成本可见、可路由、可熔断 |
| 审计数据存储 | 追加式决策账本(权威记录) | 关系型数据库 |
| 缓存 | 会话/工作状态;限速 + 熔断的背压 | 如 Redis |
| 密钥存储 | 模型密钥、护栏配置、签名密钥 | 托管密钥管理器 |
| 对象存储 | 大输入/制品 + 分层日志,加密 | 一个 bucket |
Agent 端点在结构上是无状态 HTTP 服务。如果它们只做决策推荐、不运行长内部循环,通常不需要消息队列或事件总线——同步请求/响应足够。注意哪些是刻意缺席的:消息队列、向量数据库、第二个数据库。每个组件只在具体工作负载真正需要时才引入。
两件事比组件清单更重要: 最小权限 IAM:不要给每个服务发一个宽泛凭证——网关需要 model:invoke 和模型密钥;Agent 服务需要审计存储和自己的对象存储前缀,但不要模型凭证(它们调用网关);审计库用户限定在自身 schema。使用每服务工作负载身份,绝不用共享静态密钥,这样一次泄露的爆炸半径只是一个组件的窄权限,而非整个平台。
加密:第一天就为静态数据配上托管密钥;如果账本做密码学签名则需要专用签名密钥;即便从单租户起步也要设计每租户密钥。这不是堆砌花哨基础设施——而是不添加多余组件、严格约束每个凭证、把审计存储和网关卡点第一天就搭好。
可运维性是把"能跑的 LLM 系统"变成"真能持续运行"的关键。仪表化决策而非仅仪表化服务——按租户和能力标签化的指标目录、分层日志、决策 ID 贯穿指标/日志/链路追踪和账本、对有真实阈值的症状告警。所有模型流量走一个网关,使成本可见且有上限,然后按序操作:跳过模型→批处理→缓存→合理选型→精简,并在优化前先做性能分析,每步都基线化质量。
把模型视为路由决策而非常量:简单的走便宜模型,困难的走强模型,用独立模型做判断,Failover 让一家 provider 的宕机不等于你的宕机——配备即时、细粒度的熔断开关和经过混沌测试验证的优雅降级。这一切建立在这样的平台上:供应商在端口之后、租户检查贯穿每一跳、基础设施骨架扎实但不搞技术崇拜。
贯穿每个章节的主线是同一个:一处卡点。让领域可移植的网关,也是你度量成本、路由模型、Failover、扳动熔断开关的地方。把这一处接缝做好,可运维性就不再是故障时的仓皇应对,而成为系统的内在属性。
评论